

Python Pandas实现不规则时间序列数据的分钟级分组与补齐
本文介绍如何使用Python的Pandas和Numpy库,将不规则采样的时间序列数据按分钟进行分组。通过将秒级时间戳转换为分钟并分组,提取每组数据长度,利用最大长度构建统一宽度的DataFrame,最后通过ffill方法向前填充缺失值,实现数据对齐与补齐。
2026-10-13
6

本文介绍如何使用Python的Pandas和Numpy库,将不规则采样的时间序列数据按分钟进行分组。通过将秒级时间戳转换为分钟并分组,提取每组数据长度,利用最大长度构建统一宽度的DataFrame,最后通过ffill方法向前填充缺失值,实现数据对齐与补齐。
本文介绍如何使用Python中的Plotly库结合Cufflinks和Pandas绘制直方图。通过计算滑点前后平均成本的差异,生成数据分布图表,帮助开发者直观理解金融数据的波动情况。

本文介绍如何在Python中通过sqlite3模块获取数据库的所有表名及字段名列表。针对SQLite不直接返回字典数据集的特点,提供查询sqlite_master和pragma table_info的方法。此外,结合实例演示如何遍历数据并清除Excel导入产生的回车符,实现自动化的数据清洗与更新操作。
本文基于《Python3爬虫、数据清洗与可视化实战》的学习实践,详细解析Pandas中DataFrame的核心操作。内容涵盖按单列或多列进行分组聚合(注意返回Series类型)、利用切片与merge进行数据分割及内/外连接,以及通过concat实现轴向堆叠。通过具体代码示例展示分组、合并与堆叠的实际用法,帮助读者掌握数据处理的关键技巧。
本文详细解析NumPy数组广播机制的核心原理,通过标量、二维及三维数组示例说明后缘维度匹配规则。重点剖析计算均值时因形状不匹配导致的常见错误,并给出修正方案,帮助开发者避免广播陷阱。
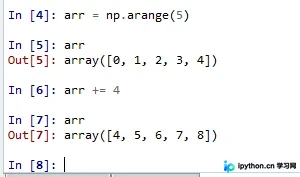
本文详细介绍基于Python的数据分析与建模流程。内容涵盖数据读取、空值与异常值处理(删除、填充、四分位数法)、静态结构分析、数据分区间及对比分析等核心步骤。通过具体代码示例,帮助读者掌握使用Pandas和Numpy进行高效数据预处理与特征工程的方法,适用于实际业务场景中的数据科学实践。
本文深入解析Pandas中易混淆的行与列选择机制。通过对比Python列表切片、loc索引值选择及iloc位置选择的实际效果,重点阐述删除行后索引变化对loc与iloc的不同影响。同时介绍单列、多列及按索引范围选取列的正确写法,帮助开发者避免常见错误,掌握高效的数据提取技巧。
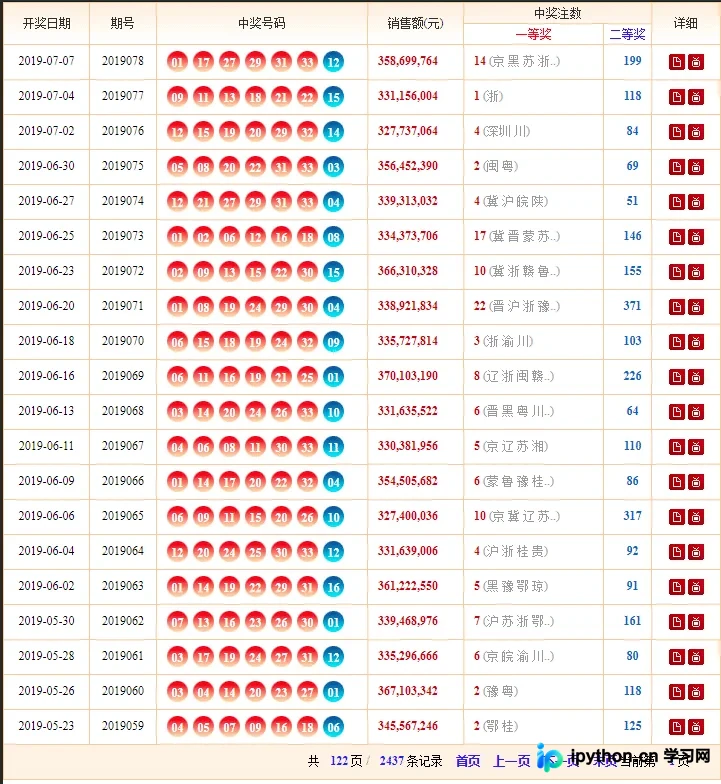
本文基于Python语言,演示如何抓取双色球历史开奖数据,并通过统计红蓝球出现频率来预测下一期号码。文章涵盖环境配置、网页解析、数据清洗及排序算法,提供完整代码示例。需注意的是,彩票具有随机性,本文方法仅基于历史数据统计,不构成中奖保证。
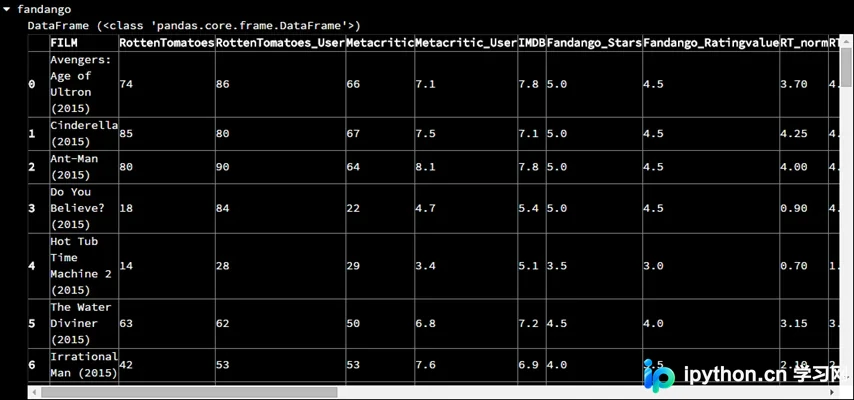
本文深入解析pandas中concat()函数的核心用法,详细讲解objs、axis、join、ignore_index等关键参数的具体含义与配置方法。通过outer并集与inner交集两种连接模式的代码示例,展示如何处理索引对齐、层级索引构建及数据复制优化,帮助开发者高效实现多DataFrame的数据合并。
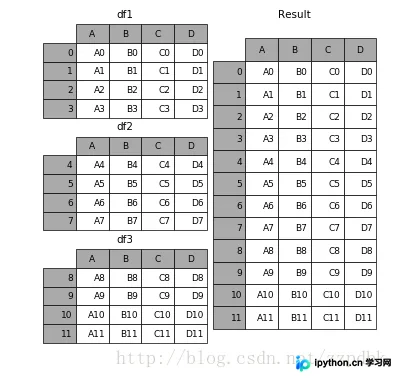
本文深入解析pandas库中pd.concat函数的核心用法,详细讲解objs、axis、join等关键参数的配置方法。通过相同字段首尾相接、横向拼接、忽略索引及增加分组键等多种场景示例,展示如何实现Series和DataFrame的高效合并与重塑,帮助开发者掌握数据整合技巧。
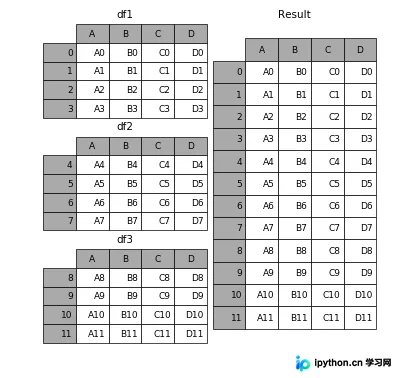
本文介绍如何使用Python的Pandas库将多个结构相同的Excel文件合并为一个。通过遍历指定目录下的所有Excel文件,读取数据并转换为DataFrame,最后利用pd.concat()函数进行合并,并将结果保存为新的Excel文件。该方法适用于需要批量处理同构Excel数据的场景。
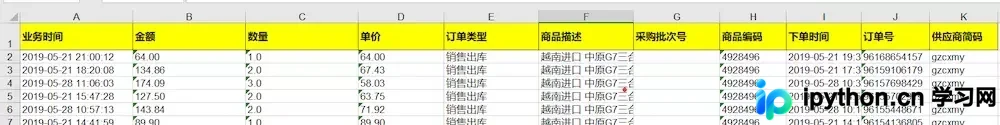
本文介绍在 Python Pandas 中如何根据列值选取多行数据。主要涵盖使用 == 选取等于特定值的行,利用 isin 选取属于某列表的值,以及通过 & 符号组合多种条件进行筛选。同时介绍了使用 != 和 ~ 选取不等于特定值的行记录,并附带完整代码示例说明。