

Pandas行与列选择详解:loc、iloc与切片用法辨析

本文深入解析Pandas中易混淆的行与列选择机制。通过对比Python列表切片、loc索引值选择及iloc位置选择的实际效果,重点阐述删除行后索引变化对loc与iloc的不同影响。同时介绍单列、多列及按索引范围选取列的正确写法,帮助开发者避免常见错误,掌握高效的数据提取技巧。
Pandas行列选择基础与数据来源
初学Pandas时,行与列的选择逻辑往往容易让人产生混淆。为了厘清这些概念,本文将对相关操作进行系统的讨论与归纳。
本文示例使用的数据集来源于:https://github.com/fivethirtyeight/data/tree/master/fandango
import pandas as pd

fandango = pd.read_csv('fandango_score_comparison.csv')
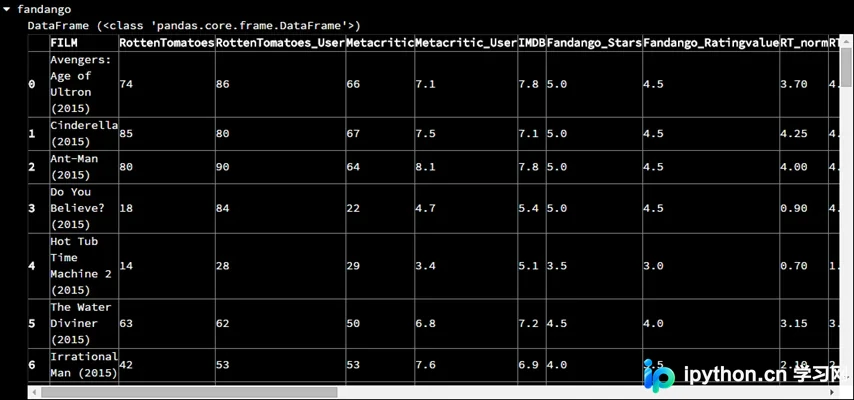
以下是部分原始数据展示:
行选择的三种方法辨析
行选择
在Pandas中进行行选择,通常有三种主要方式:
- 1. 使用类似Python列表的切片语法;
- 2. 基于指定索引值选择一行或多行,使用loc[]方法;
- 3. 基于指定位置序号选择一行或多行,使用iloc[]方法。
第一种方法:使用类似Python列表的切片语法。
n = fandango[1:3]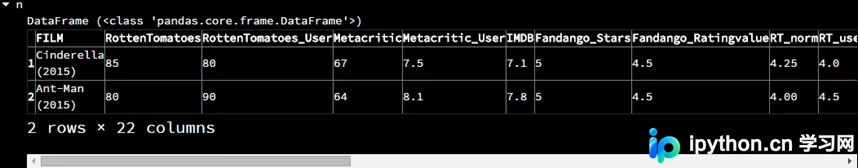
从运行结果可以看出,其逻辑与Python列表切片一致:索引号从0开始,选取索引号为1和2的数据,但不包含索引号为3的数据。
第二种方法:基于指定索引值选择一行或多行,使用loc[]方法。
o = fandango.loc[1]

p = fandango.loc[1:3]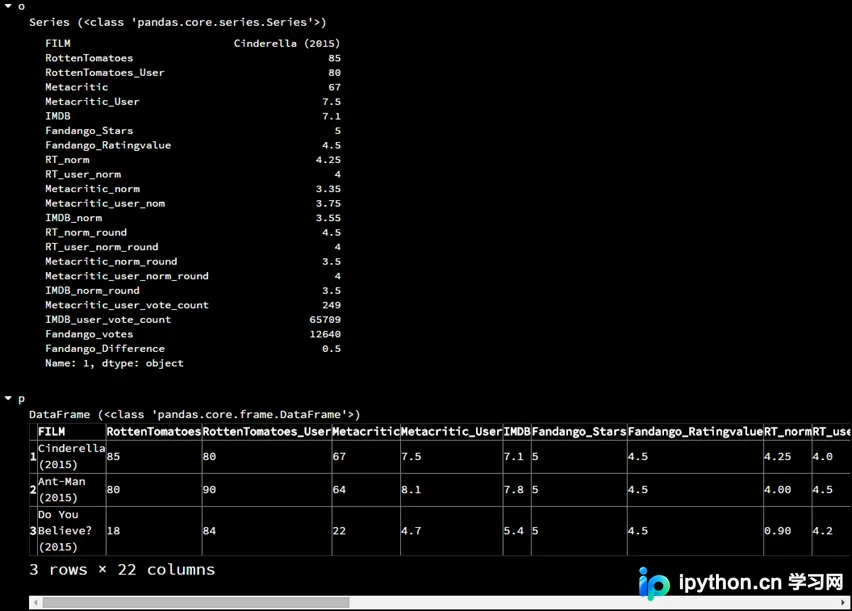
观察结果可知,变量o返回的是一个Series对象,选取了索引号为1的那一行数据。需要注意的是变量p,它与第一种列表索引方式最大的区别在于:loc切片包含了结束索引号为3的那一行数据。
u = fandango.loc[[1,3]]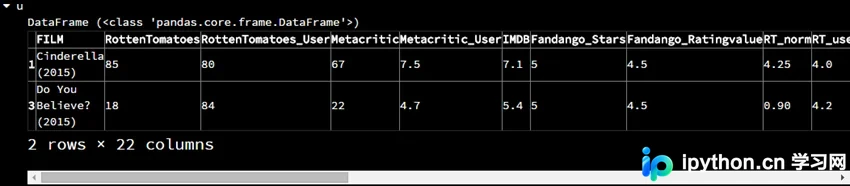
此外,还可以利用loc[]按照指定的索引值选择不连续的多行。
第三种方法:基于指定位置序号选择一行或多行,使用iloc[]方法。
在上述原始数据中,由于索引号从0开始且连续,此时iloc[]与loc[]的效果看似相同。为了演示差异,我们先删除索引号为1和2的两行数据。
fandango_drop = fandango.drop([1,2], axis=0)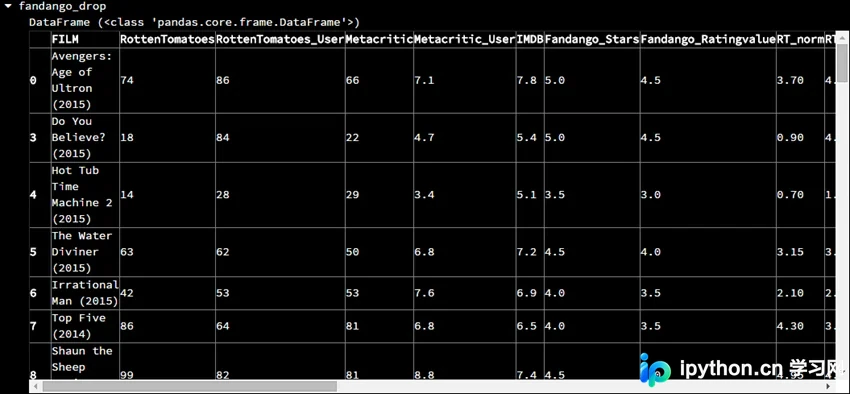
可以看到,这两行数据确实已被删除。
此时,如果继续使用loc[]尝试索引行号为2的那一行,程序将会报错,因为原索引号2已不存在。
s = fandango_drop.loc[2]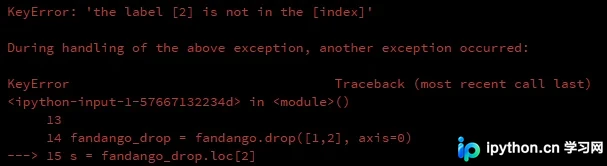
然而,如果我们改用iloc[]进行操作:
t = fandango_drop.iloc[2]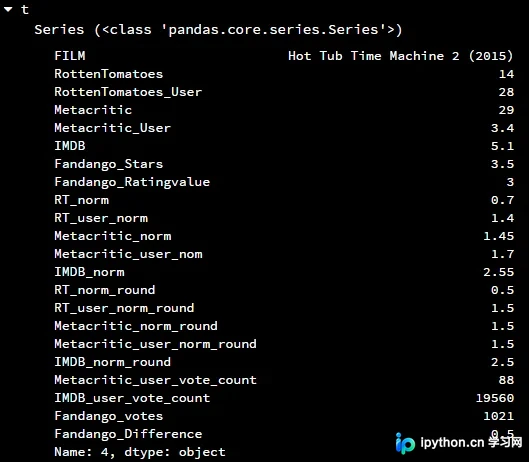
结果显示,iloc[2]表示选择第三行的数据(即当前索引号为4的那一行)。因为iloc[]的计算也是从0开始的,所以它适用于数据经过筛选导致索引号与原始数据不一致的场景。
loc[]与iloc[]之间还有一个关键区别:loc[]的参数对应的是索引值,因此参数可以是整数,也可以是字符串;而iloc[]的参数表示的是第几行的位置序号,因此只能是整数。
列选择的常见误区与正确写法
列选择
列选择相对简单,只需直接传递列名即可。如果需要选择多列数据,需单独列出列名或列的索引号。
第一种情况:选择单列,例如选择电影名称(FILM)那一列。
q = fandango['FILM']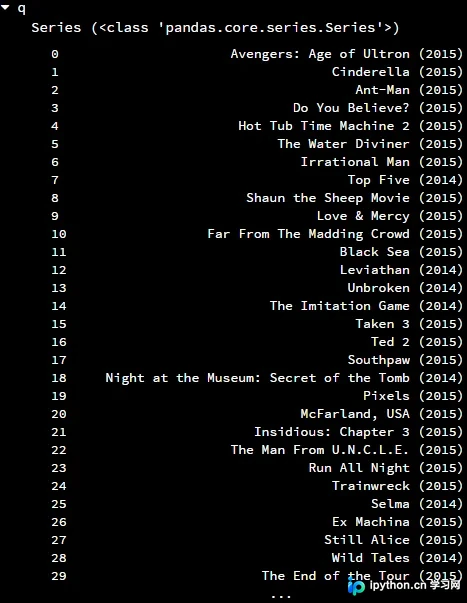
第二种情况:通过指定列名列表来选择多列。
r = fandango[['FILM','Metacritic']]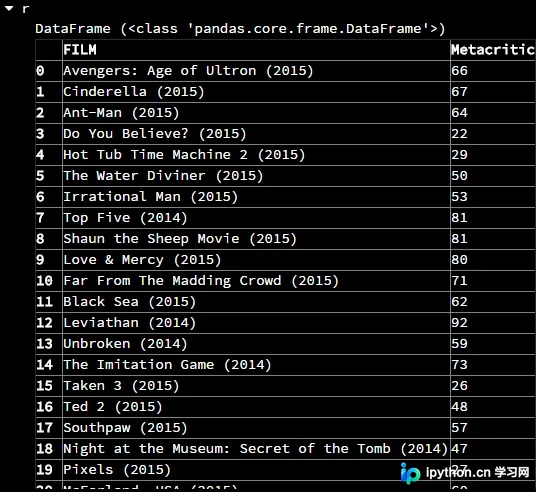
第三种情况:一种容易让人混淆的操作,即通过列的索引号来选择多列。
v = fandango[[0,1,2]]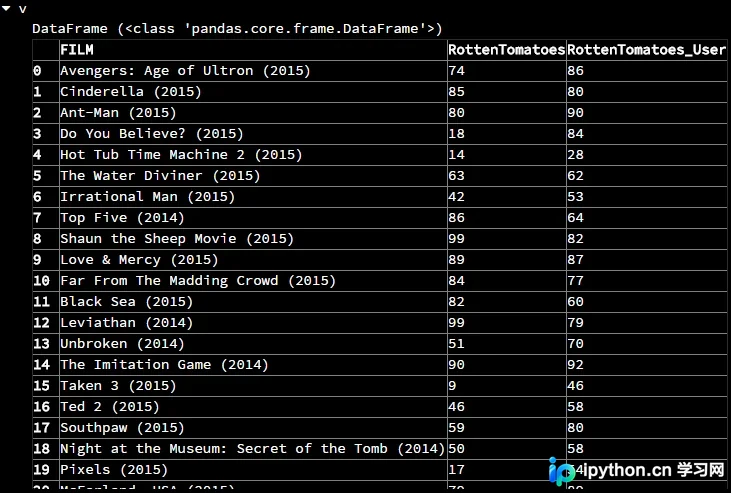
其实,列也存在索引号。看到这里可能会产生疑问:如果要选择前5列,不想写一个长列表,也不想逐个写出这5列的名称,能否直接使用切片呢?
x = fandango[[0:5]]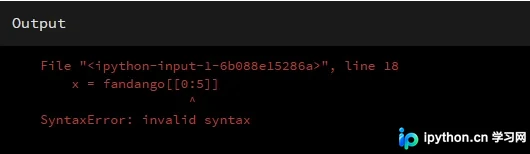
事实证明,直接切片是不行的。更好的方法是在参数中构建一个列表。
w = fandango[list(range(5))]更多参考资料:http://pandas.pydata.org/pandas-docs/version/0.17.0/api.html
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









