

pandas.concat()函数参数详解与连接模式实战

发布时间:2026-10-13| 6人浏览过
本文深入解析pandas中concat()函数的核心用法,详细讲解objs、axis、join、ignore_index等关键参数的具体含义与配置方法。通过outer并集与inner交集两种连接模式的代码示例,展示如何处理索引对齐、层级索引构建及数据复制优化,帮助开发者高效实现多DataFrame的数据合并。
concat()函数基本用法
concat()函数的具体用法
pd.concat(objs, axis=0, join='outer', join_axes=None, ignore_index=False,
     keys=None, levels=None, names=None, verify_integrity=False,
     copy=True)
核心参数详解
参数含义
- objs:接收Series、DataFrame或Panel对象的序列或映射。若传入字典,默认使用排序后的键作为键参数;若指定了值参数,则优先使用值。任何None对象将被静默忽略,除非所有对象均为None,此时将抛出ValueError。
- axis:{0,1,...},默认为0。指定沿哪个轴进行连接操作。
- join:{'inner','outer'},默认为“outer”。定义如何处理其他轴上的索引。设置为outer表示取并集,设置为inner表示取交集。
- ignore_index:boolean,default False。若设为True,则不使用连接轴上的现有索引值,结果轴的标签将重新标记为0至n-1。当连接的对象在连接轴上缺乏有意义的索引信息时,此选项非常有用。需注意,其他轴上的索引值在连接过程中仍会被保留。
- join_axes:Index对象列表。用于指定其他n-1轴的特定索引,从而跳过内部/外部设置的逻辑判断。
- keys:序列,默认值无。使用传入的键构建最外层的层次索引。若涉及多索引,应使用元组形式。
- levels:序列列表,默认值无。用于构建MultiIndex的特定级别(唯一值)。若未指定,则从keys中推断。
- names:list,default无。指定结果层次索引中各级别的名称。
- verify_integrity:boolean,default False。检查新连接的轴是否包含重复项。此操作相对于实际数据串联可能较为耗时。
- copy:boolean,default True。若设为False,则避免不必要的数据复制操作。
In [1]: df1 = pd.DataFrame({'A': ['A0', 'A1', 'A2', 'A3'],
  ...:           'B': ['B0', 'B1', 'B2', 'B3'],
  ...:           'C': ['C0', 'C1', 'C2', 'C3'],
  ...:           'D': ['D0', 'D1', 'D2', 'D3']},
  ...:           index=[0, 1, 2, 3])
  ...:

In [2]: df2 = pd.DataFrame({'A': ['A4', 'A5', 'A6', 'A7'],
  ...:           'B': ['B4', 'B5', 'B6', 'B7'],
  ...:           'C': ['C4', 'C5', 'C6', 'C7'],
  ...:           'D': ['D4', 'D5', 'D6', 'D7']},
  ...:           index=[4, 5, 6, 7])
  ...:

In [3]: df3 = pd.DataFrame({'A': ['A8', 'A9', 'A10', 'A11'],
  ...:           'B': ['B8', 'B9', 'B10', 'B11'],
  ...:           'C': ['C8', 'C9', 'C10', 'C11'],
  ...:           'D': ['D8', 'D9', 'D10', 'D11']},
  ...:           index=[8, 9, 10, 11])
  ...:

In [4]: frames = [df1, df2, df3]

In [5]: result = pd.concat(frames)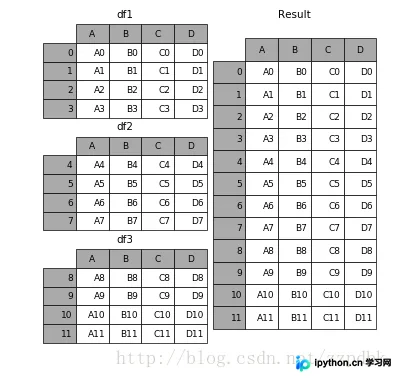
KEY参数构建层级索引
KEY参数
result = pd.concat(frames, keys=['x', 'y', 'z'])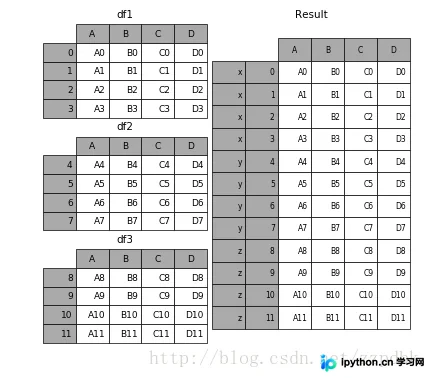
JOIN模式与索引处理
JOIN参数
默认join = 'outer',为取并集的关系
In [8]: df4 = pd.DataFrame({'B': ['B2', 'B3', 'B6', 'B7'],
  ...:         'D': ['D2', 'D3', 'D6', 'D7'],
  ...:         'F': ['F2', 'F3', 'F6', 'F7']},
  ...:         index=[2, 3, 6, 7])
  ...:

In [9]: result = pd.concat([df1, df4], axis=1)
结果:
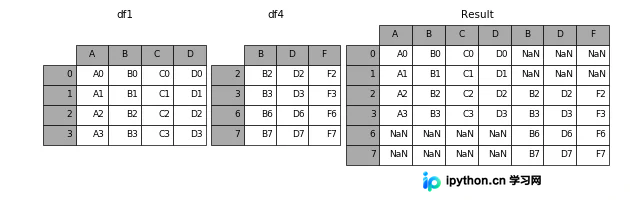
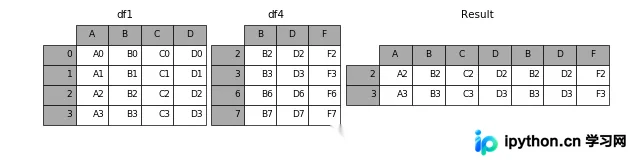
当设置join = 'inner',则说明为取交集
In [10]: result = pd.concat([df1, df4], axis=1, join='inner')结果:
如果索引想从原始DataFrame重用确切索引:
In [11]: result = pd.concat([df1, df4], axis=1, join_axes=[df1.index]) #设置索引为df1的索引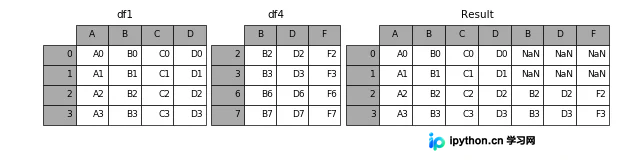
pandas文档:http://pandas.pydata.org/pandas-docs/stable/
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









