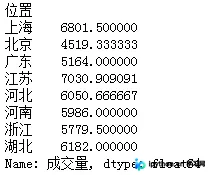
Python Pandas中cumsum函数实现按用户累计安装次数统计
本文介绍如何利用Python Pandas库中的cumsum函数,结合groupby操作,实现按用户ID分组统计历史累计安装次数。通过具体数据集示例,演示从数据分组到计算累加值的全过程,帮助开发者快速掌握累计统计技巧。
2026-10-13
6

本文介绍如何利用Python Pandas库中的cumsum函数,结合groupby操作,实现按用户ID分组统计历史累计安装次数。通过具体数据集示例,演示从数据分组到计算累加值的全过程,帮助开发者快速掌握累计统计技巧。
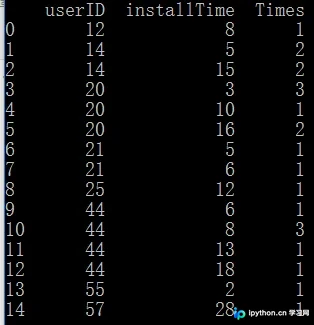
本文详解Python中numpy和pandas计算标准差的区别。默认情况下,numpy.std()使用有偏估计(除以n),而pandas.std()使用无偏估计(除以n-1)。通过调整ddof参数,可实现两种算法的互换。文章指出ddof=1为无偏估计的关键,并提醒在scikit-learn等库中手动设置该参数的重要性,尤其在数据量较小时需特别注意。
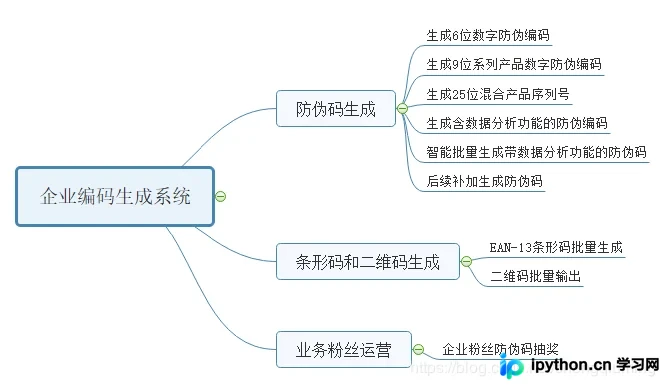
本文详细介绍基于Python的企业编码生成系统总体设计。系统涵盖6位数字、9位系列及25位混合防伪码等多种格式,支持含地区、颜色、批次信息的数据分析型编码生成。此外,系统还集成补加生成、EAN-13条形码及二维码功能,并提供粉丝抽奖应用。开发环境基于Windows 10与Python 3.6,利用tkinter、qrcode等模块实现可视化界面与编码处理,旨在帮助企业高效管理产品序列号并追踪销售数据。
本文探讨pandas中MultiIndex对象在切片或布尔索引后,其index属性仍保留原始层级的问题。通过示例展示该现象,并推荐使用remove_unused_levels()方法清理未使用的索引层级,确保df.index与实际数据索引一致,避免潜在Bug。
本文详解pandas中SettingWithCopyWarning警告的产生机制,通过复现案例对比直接索引与.loc方法的差异,指出使用.loc进行链式赋值可避免该警告,并提供代码修正示例,帮助开发者规范DataFrame操作习惯。
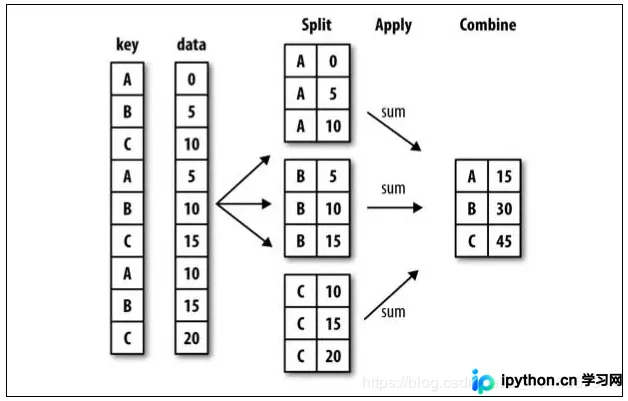
本文详细介绍Pandas中分组与排序的核心操作。通过split-apply-combine机制解析groupby函数,演示单列、多列分组及不同聚合函数的应用,并对比DataFrame与Series返回类型。同时讲解按索引和数值降序排列的sort_index与sort_values方法,提供完整代码示例。
本文详细介绍Pandas库中数据重塑与轴向旋转的核心方法。通过stack和unstack函数实现列索引与行索引的相互转换,并深入讲解pivot函数如何利用指定索引和值构建宽表。文章包含完整代码示例与输出结果,帮助开发者掌握长宽表转换技巧。
本文深入解析Pandas库中的pivot_table函数,涵盖从数据读取、索引设置、聚合函数(如sum, mean, len)配置到多级分组的高级应用。通过销售漏斗案例,演示如何利用columns、values、fill_value及margins等参数构建灵活报表,并结合DataFrame过滤实现高效数据分析。
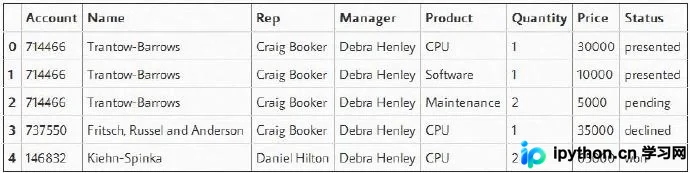
本文介绍如何使用Python的Pandas和Numpy库,将不规则采样的时间序列数据按分钟进行分组。通过将秒级时间戳转换为分钟并分组,提取每组数据长度,利用最大长度构建统一宽度的DataFrame,最后通过ffill方法向前填充缺失值,实现数据对齐与补齐。
本文介绍如何使用Python中的Plotly库结合Cufflinks和Pandas绘制直方图。通过计算滑点前后平均成本的差异,生成数据分布图表,帮助开发者直观理解金融数据的波动情况。

本文介绍如何在Python中通过sqlite3模块获取数据库的所有表名及字段名列表。针对SQLite不直接返回字典数据集的特点,提供查询sqlite_master和pragma table_info的方法。此外,结合实例演示如何遍历数据并清除Excel导入产生的回车符,实现自动化的数据清洗与更新操作。
本文基于《Python3爬虫、数据清洗与可视化实战》的学习实践,详细解析Pandas中DataFrame的核心操作。内容涵盖按单列或多列进行分组聚合(注意返回Series类型)、利用切片与merge进行数据分割及内/外连接,以及通过concat实现轴向堆叠。通过具体代码示例展示分组、合并与堆叠的实际用法,帮助读者掌握数据处理的关键技巧。