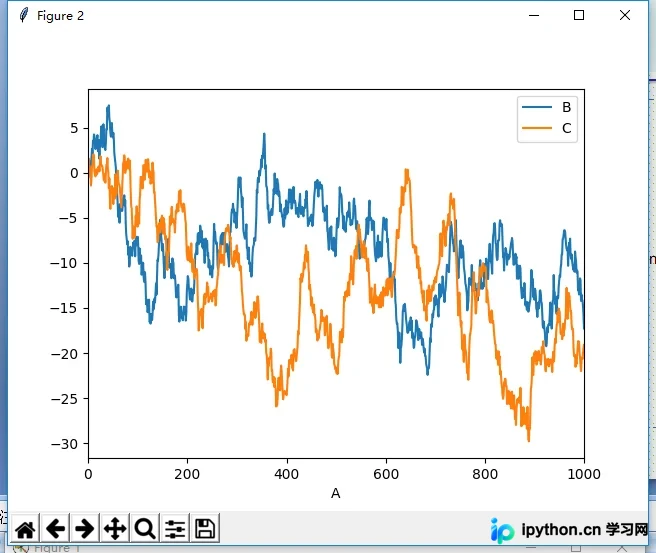
Pandas缺失数据处理指南:检测、填充与删除
本文详细介绍Pandas中处理缺失数据的完整流程。涵盖使用isnull和notnull检测NaN值,通过sum进行含NA的计算规则,利用fillna以标量或前后向填充缺失值,以及使用dropna删除含NA的行或列。
2026-10-13
6

本文详细介绍Pandas中处理缺失数据的完整流程。涵盖使用isnull和notnull检测NaN值,通过sum进行含NA的计算规则,利用fillna以标量或前后向填充缺失值,以及使用dropna删除含NA的行或列。
本文详细解析Python内置的statistics模块,涵盖mean、harmonic_mean、median、mode等核心统计函数的具体用法。通过代码示例展示如何处理整数、分数及小数数据,并深入讲解中位数计算逻辑及分组数据中位数的复杂算法,帮助开发者高效实现数据统计功能。
本文详细介绍pandas中遍历Dataframe的三种核心方法:iterrows、itertuples和iteritems。通过对比分析,说明iterrows按行返回(index, Series)对,itertuples按行返回元组且效率更高,iteritems按列返回(列名, Series)对。文章提供具体代码示例,帮助开发者根据性能需求和访问方式选择最合适的数据遍历方案。

本文详细解析在 Pandas 中遍历 DataFrame 行的多种方法。重点对比了 iterrows()、itertuples()、apply() 以及 iloc 的性能差异与适用场景。文章指出 itertuples() 通常比 iterrows() 更快,并强调避免在迭代中修改数据的重要性,同时提供自定义 namedtuple 迭代器以进一步提升处理效率。
本文介绍在Python Pandas中处理包含Tuple元素的DataFrame的高效方法。针对Word2vec输出的相似度数据,通过applymap结合lambda函数提取元组首个元素,并利用reset_index和rename重构数据结构,实现从索引提取关键词及过滤相似度值,提供比常规循环更优的性能方案。
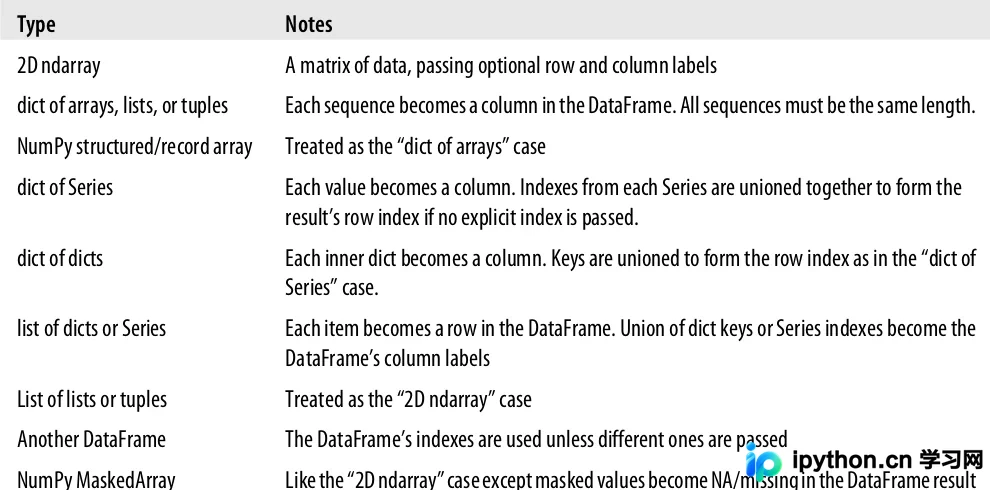
本文详细介绍 pandas 中 DataFrame 数据结构的构建、访问及修改方法。涵盖通过字典、列表及嵌套字典创建 DataFrame,指定列顺序与索引,以及获取单列、单行和特定值的操作。同时演示如何增加、修改列数据及设置行列名称,帮助开发者掌握 DataFrame 的核心操作。
本文提供使用Python和Pandas库拆分大型CSV文件的完整代码示例。通过设置chunksize参数进行分块读取,根据指定行数动态计算输出文件数量,并自动处理有表头和无表头两种情况。代码演示了如何遍历数据块并逐一保存为独立CSV文件,适用于处理超出内存限制的大规模数据集。
本文详解Python Pandas中处理Excel数据缺失值的两种核心方法:dropna用于删除全空行或列,fillna用于填充特定值或前向/后向填充。通过读取含空行的Excel文件,演示如何忽略前导空行、检测空值、删除无效数据列及行,并将分数列空值填为0,姓名列使用前向填充。最终保存清洗后的数据,提供从读取到保存的完整清洗流程。
本文介绍在Python中将DataFrame字符串列转换为日期类型的两种常用方法。首先讲解使用pd.to_datetime函数的简洁实现,其次深入解析利用datetime模块中strptime和strftime函数进行格式匹配转换的技巧。重点强调格式字符串必须与原数据完全一致,否则会导致转换失败。
本文详解如何使用 Python3 的 pandas 库读取、修改并保存 Excel 文件。通过实例演示了安装依赖、读取指定 Sheet、新增列(处理 Series 长度一致性)、以及调用 to_excel 方法保存结果的关键步骤,帮助开发者快速掌握基础数据操作。
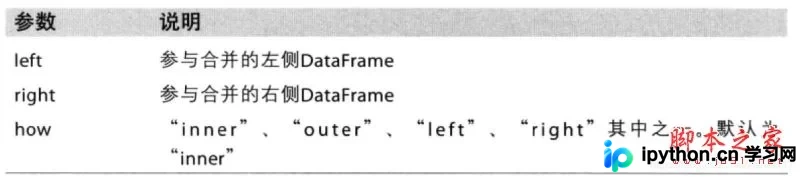
本文深入解析Python3中pandas库的merge函数,详细讲解其核心参数如on、how、left_on、right_on及suffixes的用法。通过对比内连接、外连接、左连接和右连接的区别,并演示如何利用索引进行合并,帮助开发者高效完成数据清洗与重塑任务。
本文详细介绍Python数据分析库pandas的核心用法。涵盖Series、DataFrame和Panel三种数据结构,演示如何生成一维与二维数组、查看索引与统计信息、执行数据转置与排序、进行数据选择与修改,以及处理缺失值和结合matplotlib绘图。通过具体代码示例,帮助开发者快速掌握pandas在数据清洗与分析中的实际应用。