

Python Pandas resample函数详解:降采样与重采样实战
本文详细介绍Python Pandas中resample函数的用法,涵盖降采样与重采样两种场景。通过示例解析rule、closed、label等关键参数对区间划分的影响,并对比asfreq、ffill、bfill三种重采样填充策略,帮助开发者掌握时间序列数据的聚合与插值技巧。
2026-10-13
6

本文详细介绍Python Pandas中resample函数的用法,涵盖降采样与重采样两种场景。通过示例解析rule、closed、label等关键参数对区间划分的影响,并对比asfreq、ffill、bfill三种重采样填充策略,帮助开发者掌握时间序列数据的聚合与插值技巧。
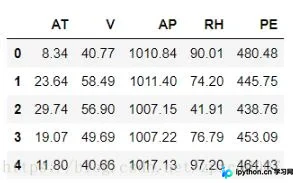
本文详细演示了如何使用Python和SPSS进行多元线性回归分析。通过电厂数据案例,分别采用梯度下降法和sklearn库中的最小二乘法求解回归参数,并对比SPSS结果。文章涵盖数据预处理、损失函数构建、参数迭代优化及模型验证全过程,展示不同方法在参数精度与收敛速度上的一致性。
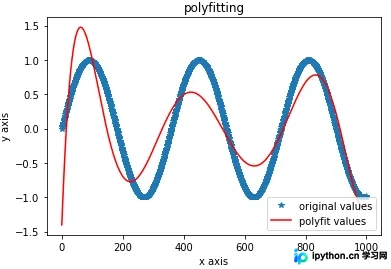
本文介绍在Python中计算波峰波谷值(极值点)的四种常用方法。通过scipy库的find_peaks检测极大值,利用np.polyder求导寻找导数为零的点,以及使用argrelextrema直接获取极大极小值索引。结合np.polyfit进行数据拟合,可灵活处理不同场景下的极值点定位需求。
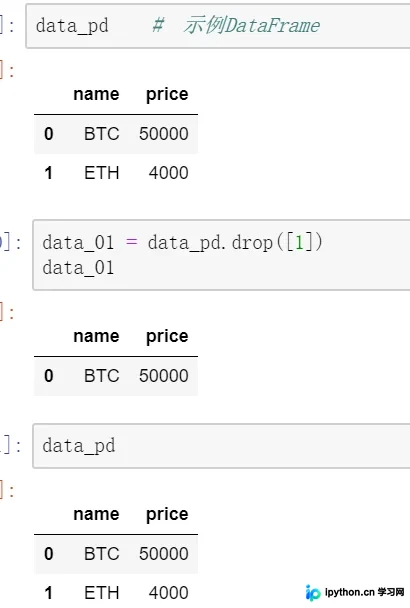
本文深入解析Python中Pandas库在处理数据结构时的内存复制机制。通过具体示例说明,当对DataFrame进行删除行等操作时,默认会在新的内存区域生成副本以保护原始数据。文章探讨了如何通过设置参数直接修改原数据,并引出Python中赋值与深浅复制的广泛概念,帮助开发者理解数据安全性与内存优化的平衡。
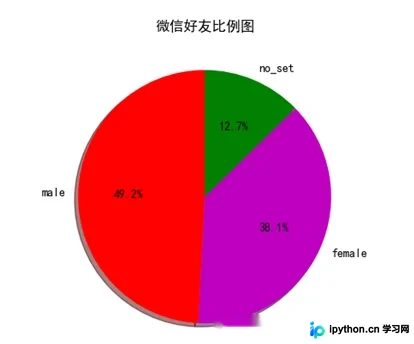
本文介绍如何利用Python的wxpy库获取微信好友数据,并通过pandas和pyecharts进行性别、地域分布的可视化分析。同时结合jieba分词与wordcloud库生成好友个性签名词云,直观展示社交网络特征。
本文详解pandas中计算相关系数与协方差的核心方法。通过实例演示如何使用pct_change计算百分比变化,利用corr和cov计算列间相关性与协方差矩阵,并讲解DataFrame与Series间的对齐计算规则及axis参数的应用,帮助开发者掌握数据统计分析基础。
本文介绍pandas中DataFrameGroupBy对象的agg方法,演示如何对分组数据执行聚合操作。涵盖对每一行使用agg、多列应用多个聚合函数以及单列指定聚合函数的具体代码示例,帮助开发者掌握灵活的数据聚合技巧。
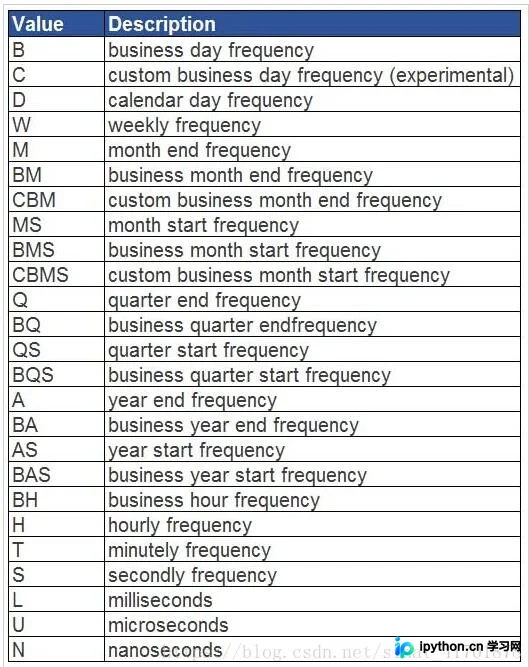
本文介绍如何利用 pandas 的 resample 方法对时间序列数据进行聚合处理。通过设置 datetime 索引,演示按年、月、日及自定义频率(如周、季度)提取数据,并结合 sum 与 fillna 实现具体列的汇总与缺失值填充,提供完整的代码示例供参考。
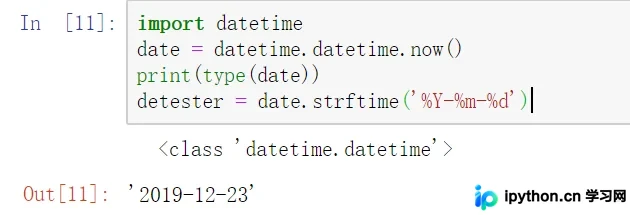
本文详解Python中Pandas处理日期格式的常用方法。涵盖字符串转日期的strptime与to_datetime函数,以及利用apply处理DataFrame列的技巧。同时介绍dateutil.parser.parse的高级解析能力,并演示日期转字符串的strftime用法,帮助开发者高效解决时间格式转换问题。
本文提供基于Kashgari库的Python代码,用于利用预训练Ner模型对Conll格式数据进行清洗与合并。核心逻辑包括读取原始数据,通过文本长度判断是否分块预测实体,最终将清洗后的文本与标签合并输出至目标文件,适用于需要批量处理序列标注数据的场景。
本文介绍了在Python Pandas中处理数据时遇到的inf和nan值问题。通过示例展示了如何使用replace方法将inf和-inf转换为nan,以避免对后续数据处理产生影响。
本文介绍Pandas库中DataFrame.rename函数的使用方法,用于重命名数据框的行索引或列名。详细解析了mapper、index、columns、axis等关键参数,对比了两种调用约定,并通过代码示例演示了字典映射与函数转换的实际效果,帮助开发者高效进行数据预处理。