

pandas 实现将NaN转换为None

发布时间:2026-10-14| 6人浏览过
本文介绍在Python中使用pandas将数据中的NaN值转换为None的方法。通过df.where(df.notnull(), None)实现精准替换,解决接口接收数据时的类型兼容问题。同时补充了处理数据库读取后None转0.0时的常见误区,指出需区分NaN与None类型,并给出fillna的正确用法。
在Python中,利用pandas库进行数据处理是一项高效且便捷的操作。
然而,在从外部来源读取数据时,往往需要处理一些异常值。
例如,当从Excel文件读取数据并调用接口写入数据库时,读取到的空值通常表现为NaN,而接口要求的对应单元格数据应为None。此时,如何利用pandas轻松完成这一转换呢?答案同样简单。
具体示例如下:
原始数据展示:
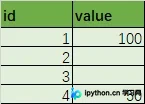
示例代码实现:
import pandas as pd
df = pd.read_excel('data/test_data.xlsx')
# 将非空数据保留,空数据用None替换
df = df.where(df.notnull(), None)
print(df)
运行输出结果:
id value
0 1 100
1 2 None
2 3 None
3 4 50
补充说明:Pandas中NaN与None的处理差异
在处理数据过程中遇到了上述问题。
数据库中的存储值为null。
读取数据库后,得到的DataFrame中显示为None。
试图将这些None值转换为0.0,但尝试多种方法均未成功。
曾使用过以下方法:
df['PLANDAY'].replace('None',0)该方法未奏效。
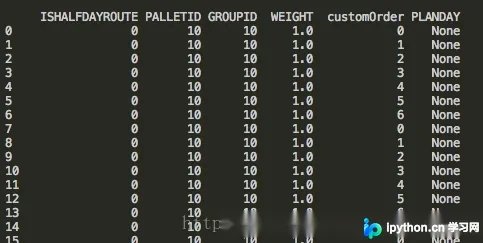
此判断语句生效:
df.loc[0,'PLANDAY'] is None:随后发现,该数据类型实际为NaN而非None。
因此,采用相应方法解决了上述问题。
df['PLANDAY'] = df['PLANDAY'].fillna(0.0)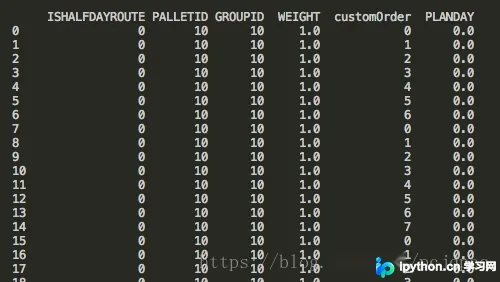
以上为个人经验分享,希望能对大家有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









