Pandas基础:TXT与SQL文件数据导入实战指南
本文详解如何使用Pandas库读取TXT和SQL文件。通过read_table()方法处理TXT数据,并演示利用pymysql连接MySQL数据库进行SQL查询。重点解决charset编码报错问题,对比展示正确与错误的连接代码,帮助开发者快速掌握结构化数据导入技巧。
2026-10-14
6

本文详解如何使用Pandas库读取TXT和SQL文件。通过read_table()方法处理TXT数据,并演示利用pymysql连接MySQL数据库进行SQL查询。重点解决charset编码报错问题,对比展示正确与错误的连接代码,帮助开发者快速掌握结构化数据导入技巧。

本文详细介绍Pandas中DataFrame的行列数据提取方法,涵盖按行、按列、按位置及按索引的多种操作。重点解析df.iloc()、df.loc()、df.iat()和df.at()函数的具体用法与区别,通过实例演示如何高效获取连续或不连续的数据块,帮助开发者掌握灵活的数据筛选技巧。
本文详细介绍Pandas中plot()方法的可视化操作。涵盖图表类型、数据源选择、图大小、标题、坐标轴、图例、网格线、颜色及多子图等元素设置。演示柱状图、条形图、直方图、箱线图、面积图、散点图、气泡图及饼图的绘制方法,并介绍密度图、六边形箱型图等高级图表及绘图引擎切换。
本文详解Pandas中处理文本数据的完整流程。涵盖object与string类型差异、大小写转换与对齐等基础字符串方法,深入讲解split、replace、cat等拆分替换拼接技巧,以及利用正则表达式进行match、extract和虚拟变量提取的高级操作,助力高效数据清洗与分析。
本文深入解析Python列表切片在内存中创建副本的机制,并推荐针对大规模数据遍历使用itertools.islice以节省内存。文章详细对比了普通切片与islice的行为差异,指出islice不支持负参数。同时,通过具体代码示例展示了Python切片语法的完整用法,包括起止索引、方向控制及边界处理,并简要提及Pandas DataFrame切片返回视图的特性。
本文详细介绍Python pandas库中count和sum函数的具体用法。通过完整示例演示如何对全表、单列、多列及单行、多行进行非空值计数与数值求和。重点解析字符串拼接与数值计算的差异,帮助开发者掌握数据预处理中的基础统计操作。
本文详细介绍Pandas中的option系统,用于控制数据展示行为。涵盖常用方法如get_option、set_option、reset_option及option_context,并深入解析display.max_rows、display.precision、display.chop_threshold等关键参数的配置与示例,帮助开发者优化DataFrame输出格式。
本文介绍Pandas中用于高效存储含大量NaN值数据的稀疏数据结构。重点讲解SparseArray的创建、SparseDtype的类型定义(如非NaN值类型与填充常量),以及通过.sparse属性访问密度和填充值的方法。同时说明SparseSeries和SparseDataFrame在1.0.0版本后的替代方案,并提供SciPy稀疏矩阵转换示例。
本文详解Python中方差检验的含义与用法,介绍如何利用pandas构建数据及statsmodels进行方差分析。通过具体代码示例,展示单因素、多因素无重复及重复方差分析的实现流程,帮助读者掌握数理统计在Python中的实际应用。
本文深入解析Python Pandas库中read_sql_query函数的使用方法。详细说明了如何将SQL查询结果高效转换为DataFrame,并逐一解读sql、con、index_col、coerce_float、params及parse_dates等关键参数的配置技巧。结合MySQL连接实例,展示如何安全传递参数并处理日期格式,帮助开发者快速掌握数据库交互与数据清洗的核心技能。
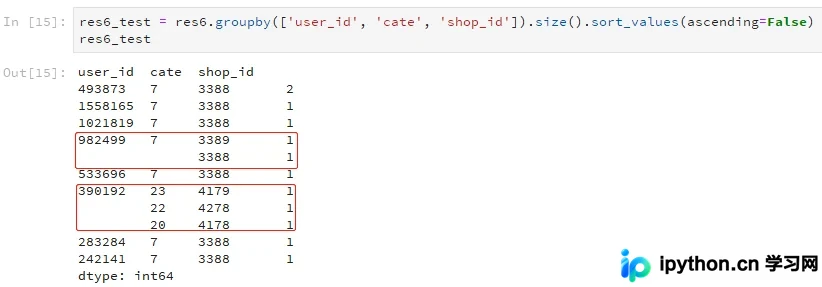
本文解析Pandas使用groupby与size进行多列分组统计时,多级索引默认不显示重复外层键值的特性。通过具体数据示例说明982499等数值行的显示逻辑,指出这并非数据缺失,而是为了排版直观。文章提供完整代码示例,帮助开发者正确理解并处理此类统计结果,避免误判数据完整性。
本文详细介绍如何在Python中读取xlsx格式文件。通过安装并调用xlrd库和pandas库,演示了如何打开工作簿、获取行列数、提取特定单元格及遍历数据。重点展示了使用pandas进行列选择(usecols)和行数限制(nrows)的具体代码实现,帮助开发者快速掌握Excel文件的数据提取技巧。