Python自动化处理Word民主评议:读取表格、计算汇总并导出Excel
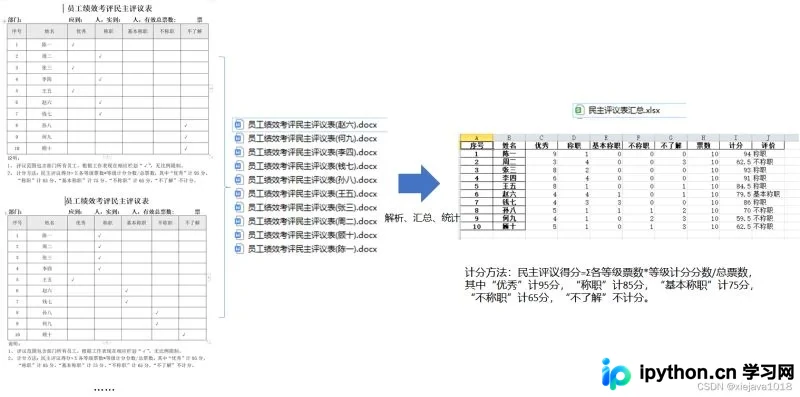
本文介绍利用Python自动化处理年度民主评议表的完整方案。通过docx解析Word文档中的评价表格,使用pandas进行数据汇总与加权计分,最终将结果写入Excel文件。代码不足80行,涵盖从安装依赖、读取目录、解析表格、计算评分到导出文件的全流程,适用于批量处理员工评价数据。
2026-10-16
6

本文介绍利用Python自动化处理年度民主评议表的完整方案。通过docx解析Word文档中的评价表格,使用pandas进行数据汇总与加权计分,最终将结果写入Excel文件。代码不足80行,涵盖从安装依赖、读取目录、解析表格、计算评分到导出文件的全流程,适用于批量处理员工评价数据。
本文整理了八个Python数据清洗的常见场景及对应代码,涵盖删除多列、转换数据类型、分类变量数值化、检查缺失值、处理字符串异常及空格、条件拼接字符串以及时间戳转换。通过封装函数,帮助开发者高效完成数据预处理工作,提升数据分析效率。
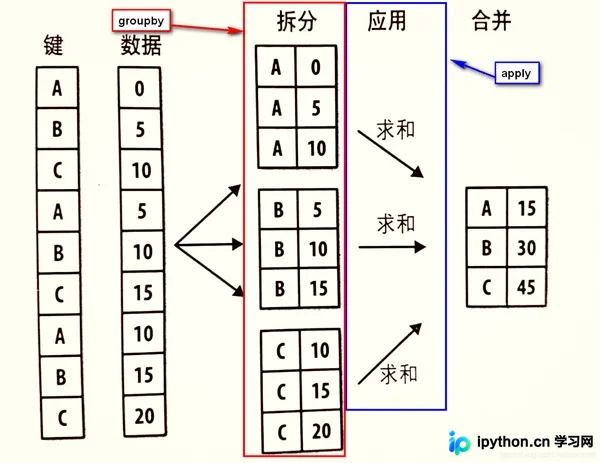
本文详细介绍Python中Pandas库的apply函数,涵盖其函数原型、参数含义及核心用法。通过具体代码示例,演示如何对DataFrame的指定列、整体列及行进行自定义函数计算,并展示其与groupby函数结合使用的场景,帮助开发者高效处理数据。
本文详细介绍Python Pandas中访问和修改DataFrame数据的四种方法:at, iat, loc, iloc。对比标签与索引的使用场景,解析单个与批量元素操作,探讨重复标签处理及性能差异,并通过实例演示如何高效获取和更新数据。
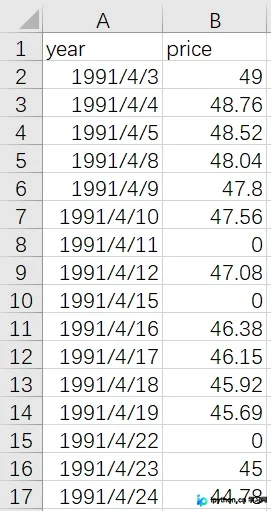
本文介绍如何使用Python的csv模块读取CSV文件,并通过numpy模块计算指定列(如股价)的均值和方差。重点讲解利用next()跳过表头、类型转换及数据提取的关键步骤,提供完整代码示例,帮助开发者快速实现金融数据的统计分析。
本文详细讲解Python中使用Pandas进行数据预处理的核心步骤。通过read_csv读取数据,利用duplicated和drop_duplicates处理重复项,使用notnull筛选非空记录,并基于3σ原则(拉依达准则)识别正态分布下的异常值,为后续分析提供高质量数据基础。
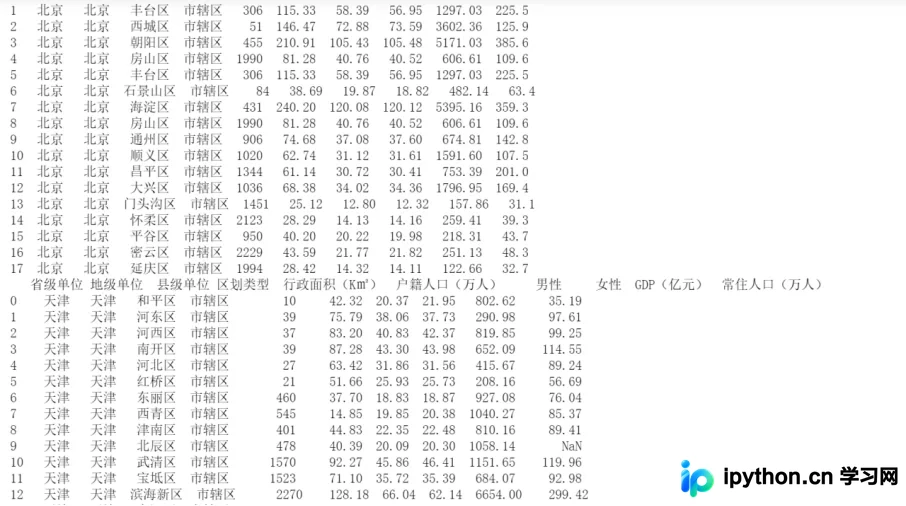
本文深入解析Python中datetime模块的核心类,包括date、time、datetime、timedelta及tzinfo。详细演示如何将日期转为字符串、字符串解析为日期,以及处理Excel中常见的数值型时间格式。结合信贷催收场景,展示如何利用pandas进行数据排序与去重,提取客户最后一次通话记录,解决实际业务中的时间处理难题。
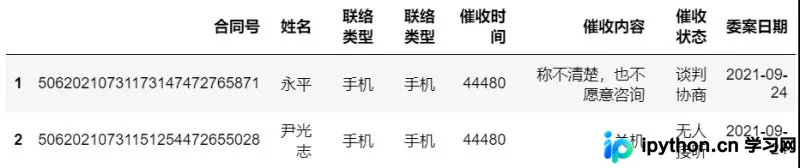
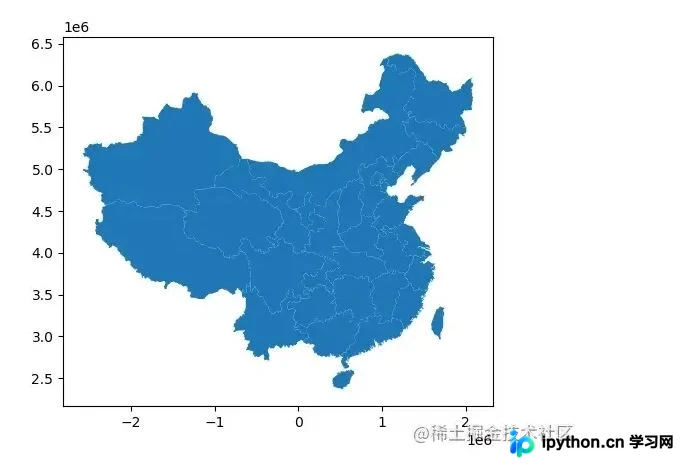
本文介绍如何使用Python的GeoPandas库处理地理数据。通过安装依赖,利用GeoSeries和GeoDataFrame创建几何对象,并直接调用area属性计算图形面积。进一步演示如何读取ESRI Shapefile格式的省级行政区数据,批量计算并输出每个省份的具体面积数值。
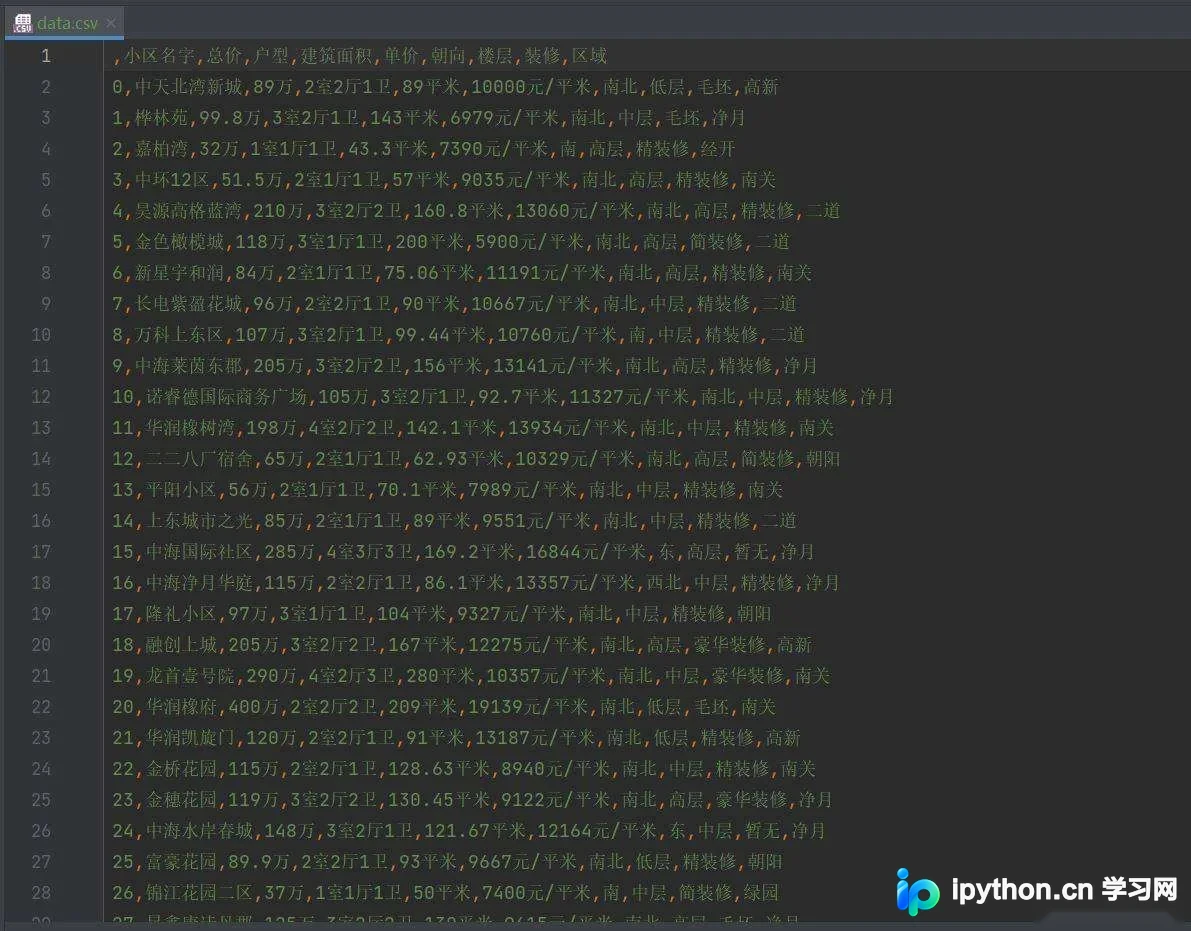
本文详细介绍使用Python对某地区二手房数据进行清洗与可视化分析的全过程。通过Pandas处理原始CSV数据,去除无效字段并转换数值类型,利用Matplotlib绘制各区均价、装修分布、区域占比及热门户型均价图表,直观展示市场特征。
本文详细介绍Python中matplotlib库绘制直方图的方法。涵盖直方图定义、适用场景及绘制步骤,深入解析facecolor、bins、alpha、histtype等关键属性。通过员工身高分析案例,演示基础直方图、带折线辅助、堆叠直方图、不等距及多类直方图的实现代码与效果。
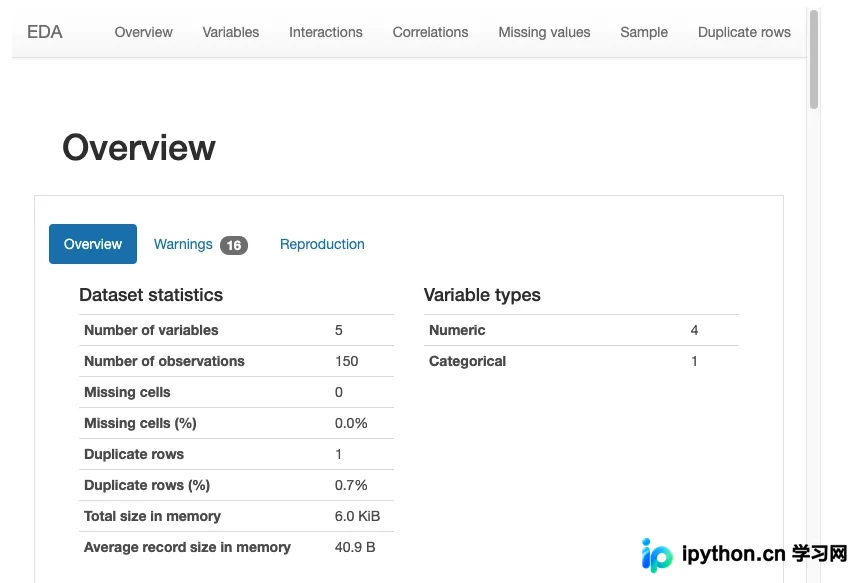
本文盘点Python数据挖掘中常用的五种AutoEDA自动化工具,包括Pandas Profiling、AutoViz、Dataprep、SweetViz和D-Tale。文章对比了各工具的功能特性、耗时情况及适用场景,帮助开发者快速选择适合的数据探索与分析方案。
本文介绍Python中利用Pandas库加速探索性数据分析的四种实用方法。包括通过创建groupby对象复用聚合结果以节省内存并提升速度,使用nlargest和nsmallest快速获取Top N或Bottom N记录,以及利用比较运算符及其包装器进行高效数据切片和条件列生成。这些技巧能显著简化数据处理流程,提高分析效率。