Python实现Excel文件横向合并:多文件数据整合方案
本文介绍如何使用Python将多个结构一致的Excel文件进行横向合并。通过读取第一列作为索引,利用glob获取文件列表,并结合pandas与xlrd库提取数据,最终将所有工作表按列拼接为一个新文件。适用于月度数据分析等场景,提供完整代码示例及注意事项。
2026-10-12
7

本文介绍如何使用Python将多个结构一致的Excel文件进行横向合并。通过读取第一列作为索引,利用glob获取文件列表,并结合pandas与xlrd库提取数据,最终将所有工作表按列拼接为一个新文件。适用于月度数据分析等场景,提供完整代码示例及注意事项。
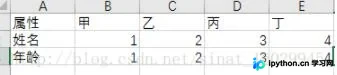
在使用 Python 的 Pandas 库处理数据时,导出 DataFrame 为 CSV 文件默认会包含行索引。本文介绍如何通过 to_csv 函数的 index=False 参数,在保存数据时直接隐藏索引值,使输出的 CSV 文件更加简洁。
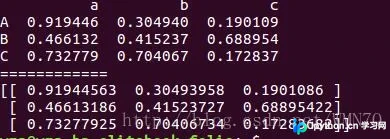
本文介绍在 Python 中将 DataFrame 转换为多维矩阵的方法。通过导入 pandas 和 numpy 库,创建示例 DataFrame,并使用 values 属性获取其多维矩阵表示。
本文详解Pandas在数据处理中的核心操作,涵盖缺失值(NaN)的检测与填充策略、基于多键的表关联合并(Merge)与纵向拼接(Concat),以及利用透视表进行多维统计。通过具体代码示例,展示如何高效完成数据清洗、多表关联及报表生成,解决日常数据分析中的常见痛点。
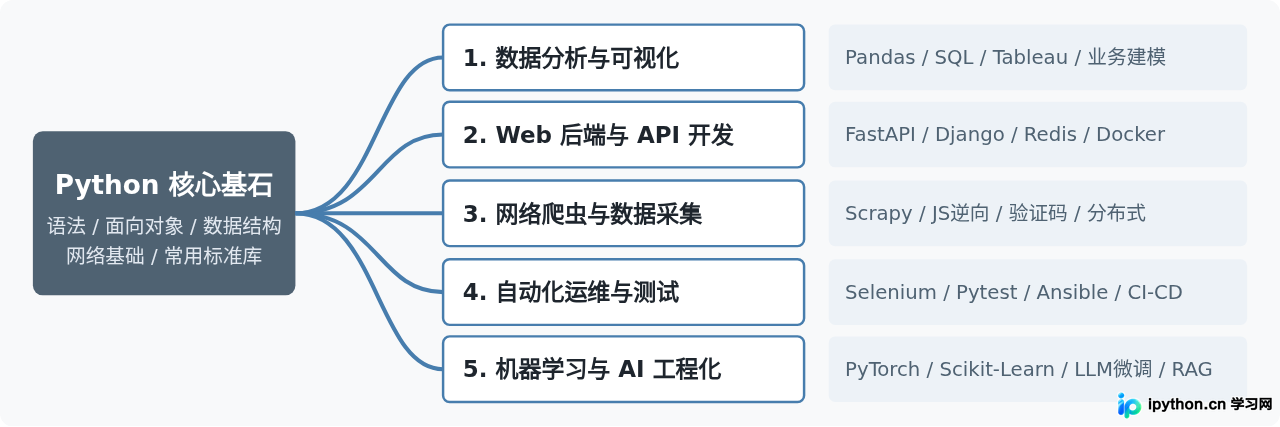
全面解析学完Python后的5大核心就业方向、各岗位技能要求、日常工作场景与主流薪资范围,帮助学习者根据自身条件合理选择职业路径。
针对Python初学者的选型指南,深入解析Anaconda与官方Python在设计定位、下载体积、安装流程及包管理上的核心区别,并提供具体的决策依据与验证方法。
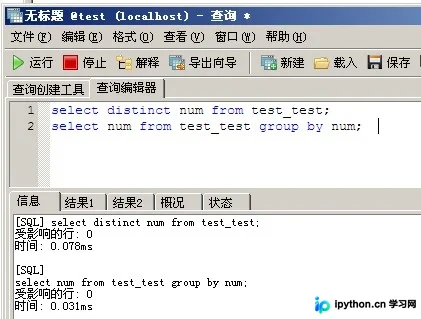
本文通过创建10万条数据的测试表,分别模拟无索引和有索引两种场景,使用Profiling工具精确测量MySQL中DISTINCT与GROUP BY的执行耗时。测试表明,在建立索引后两者执行极快,但综合来看GROUP BY始终略优于DISTINCT,推荐在实际开发中优先选用GROUP BY以提升查询效率。
本文介绍如何利用 SQL 窗口函数 ROW_NUMBER 结合随机排序,从包含班级和姓名的学生表中,精确抽取每个班级的任意 N 名学生。该方法通过生成随机序号并设定阈值,高效完成分层抽样任务,适用于班级点名、活动分组等场景。
本文详细梳理了SQL Server 2008的关键新特性,涵盖TVF/临时表/表变量/CTE的性能差异与适用场景。深入解析了sql_variant、日期时间类型演进、MERGE语句的同步逻辑,以及GROUPING SETS的高级聚合用法。同时提供了CTE递归查询和PIVOT/UNPIVOT行列转换的实际代码示例,助力开发者掌握高效SQL编写技巧。
本文系统梳理了 SQL 的核心语法,涵盖 DDL(数据定义)、DML(数据操作)、DQL(数据查询)及 DCL(数据控制)。通过具体实例详解建库建表、增删改查、聚合分组、多表连接及子查询等高频操作,并提供权限管理的标准用法。掌握这些结构化的查询语句,可高效应对日常数据库开发与维护任务。
本文介绍如何使用R语言及ggplot2包绘制高质量的主成分分析(PCA)图。通过iris数据集演示,涵盖数据准备、基础散点图绘制、类别着色及置信椭圆计算技巧(如inherit.aes参数处理),并包含轴标签百分比显示及自定义配色等样式微调方法。
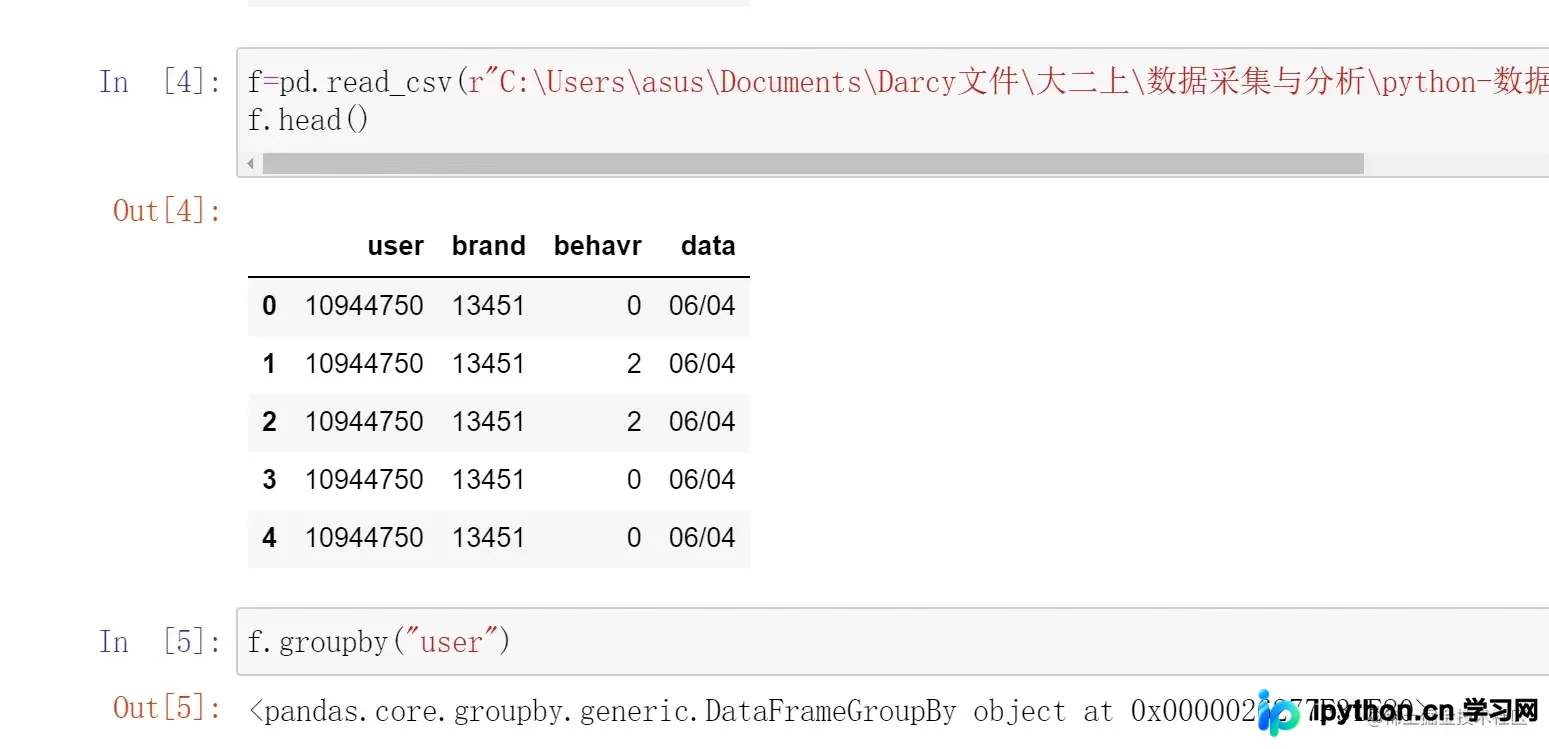
本文详解Pandas中groupby函数的核心用法,通过电商行为数据实例,演示如何按用户或商品分组统计浏览量与购买量。重点讲解利用Series除法计算商品转化率、处理缺失值(NaN)及排序提取Top N商品的方法,帮助读者快速掌握分组聚合技巧。