

数据科学常用Python编辑器:Jupyter Notebook是什么

如果你刚开始接触 Python 数据分析或机器学习,一定会频繁听到或看到一个名为 Jupyter Notebook 的工具。它与传统的代码编辑器大不相同:你不是把成百上千行代码一次性写在一个 .py 脚本中然后整篇运行,而是在一个类似网页记事本的环境里,把代码切成一个个小块,写一段运行一段,并且可以直接在代码正下方看到数据表格、统计图表和文字说明。简单来说,Jupyter Notebook 是一个基于 Web 的交互式计算环境,它将代码编写、执行输出、数据可视化和富文本叙述无缝融合在同一个文档中,是现代数据科学工作流中最核心的生产力工具之一。
一、Jupyter Notebook 的核心概念与运行架构
要理解 Jupyter Notebook,首先需要解构它的名字。“Jupyter”源于三个核心科学计算语言的名字缩写:Julia、Python 和 R;而“Notebook”(笔记本)则形象地传达了它的设计初衷——像科学家的实验记录本一样,不仅记录实验代码,还保留实验过程、中间数据、测试输出和分析心得。
与传统的桌面开发工具不同,Jupyter Notebook 采用了典型的客户端与服务端分离架构。当你在本地运行它时,主要由三个部分协同工作:
- Web 浏览器前端(Web UI):这是用户直接操作的可视化界面。你可以在浏览器标签页中新建笔记本、编写代码、编辑 Markdown 格式的说明文档,并接收即时返回的图表与文本。
- Jupyter Server(后台服务端):运行在本地计算机(或远程服务器)的轻量级服务进程。它负责监听请求、管理本地工作目录中的文件存取,并维护计算内核的生命周期。
- IPython Kernel(计算内核):独立运行的 Python 进程,负责实际接收、编译和执行 Python 代码。它常驻系统内存中,因此你定义好的变量、导入好的数据集或训练好的模型对象都会一直保留,直到你显式重启内核。
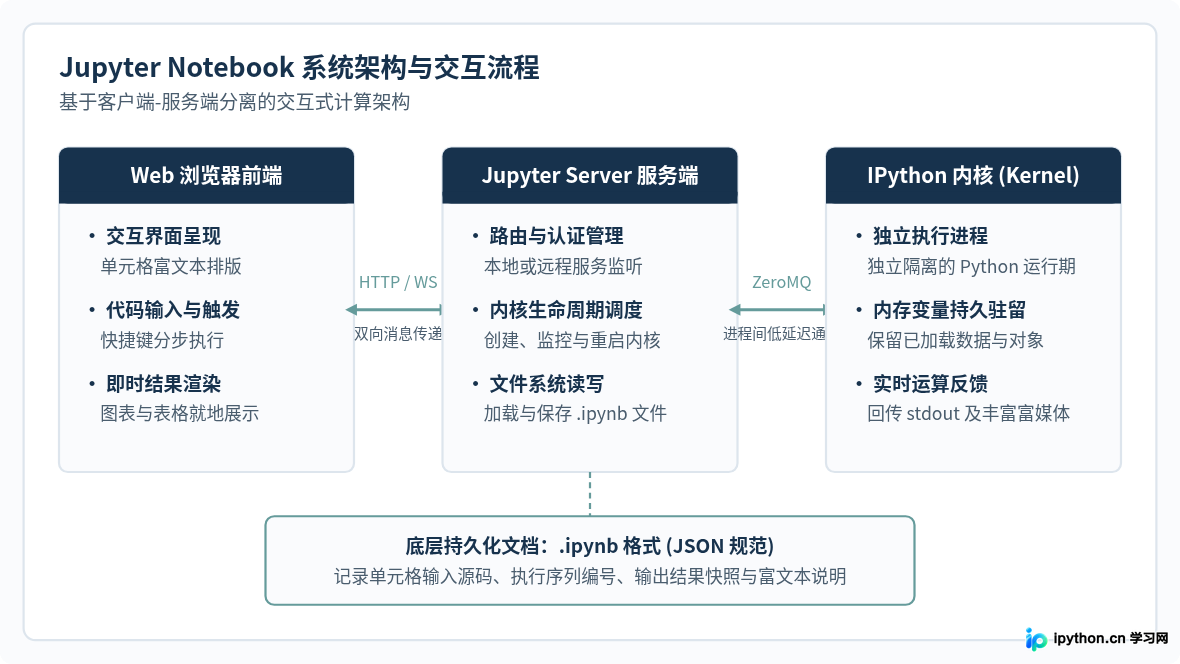
在存储层面,Jupyter Notebook 保存的文件后缀为 .ipynb。虽然在界面上呈现为图文混排的富文本,但其底层实际上是符合规范的标准 JSON 文本文件,完整记录了每一个单元格的代码源码、执行序号、静态输出快照(如 PNG 图片的 Base64 编码、HTML 表格片段)以及文档元数据。
二、为什么数据科学首选 Jupyter Notebook:核心机制与对比
传统软件工程通常使用 VS Code、PyCharm 或 Sublime Text 等编辑器,直接编写整份 .py 脚本,然后通过命令行一次性自顶向下运行。这种模式非常适合逻辑严密、模块化封装和长期部署的工程项目。但在数据科学研究中,开发模式截然不同——数据分析本质上是一个充满探索、试错与反复验证的过程。
数据科学家往往需要先加载一份几百兆乃至数吉字节的数据,观察前几行分布,清洗缺失值,尝试画出不同维度的散点图,再逐步调优模型参数。如果每次调整图表配色或修改一行特征衍生逻辑,都要把整个脚本重新运行一遍、重新耗费数分钟读取大文件,开发效率将大打折扣。
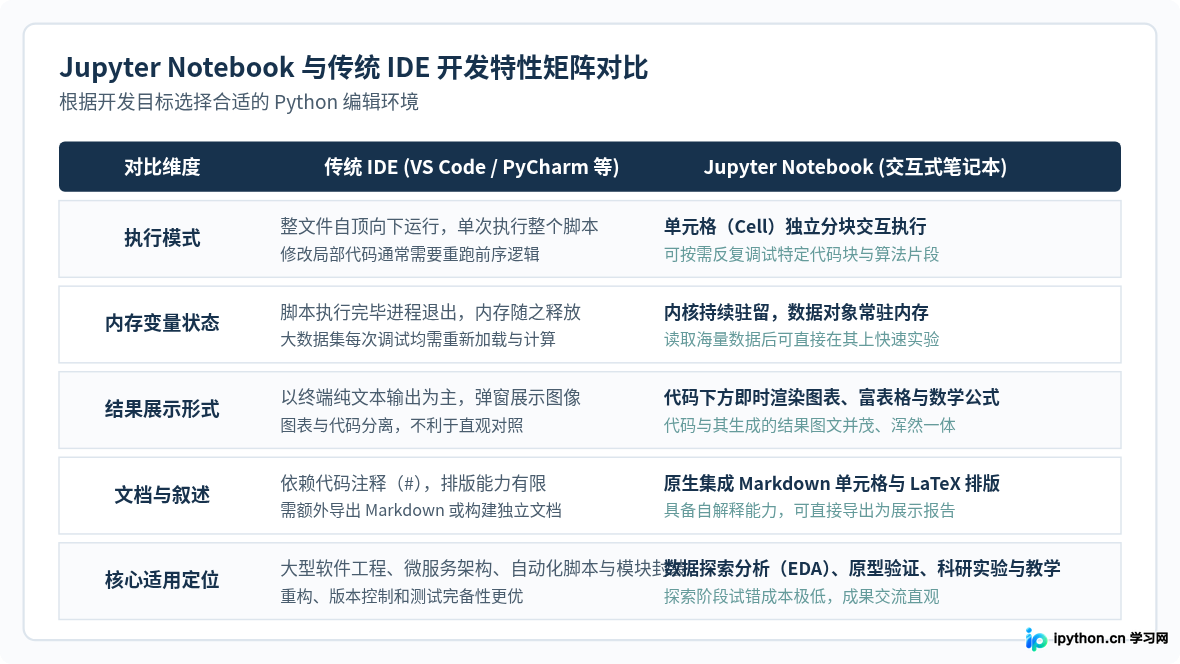
Jupyter Notebook 能够成为数据分析领域的标配工具,主要得益于以下三项关键能力:
- 单元格(Cell)独立执行:代码被划分到独立的单元格中。你可以单独执行第 5 个单元格来调试绘图样式,而无需重新运行前 4 个单元格的数据加载和预处理代码。
- 内存状态持续驻留:只要 Kernel 没有关闭,所有内存变量均保持活跃。这意味着读取进内存的大型 Pandas DataFrame 可以直接供后续所有单元格反复使用,极大地节约了磁盘 I/O 和重复计算的时间。
- 代码与结果图文混排:传统终端只能打印字符,而 Jupyter 能够直接在代码下方原地渲染 Matplotlib、Seaborn 或 Plotly 生成的高清图表,配合 Markdown 说明文字,整篇文档本身就是一份完整的分析报告。
三、快速上手:Jupyter Notebook 的基本操作与使用步骤
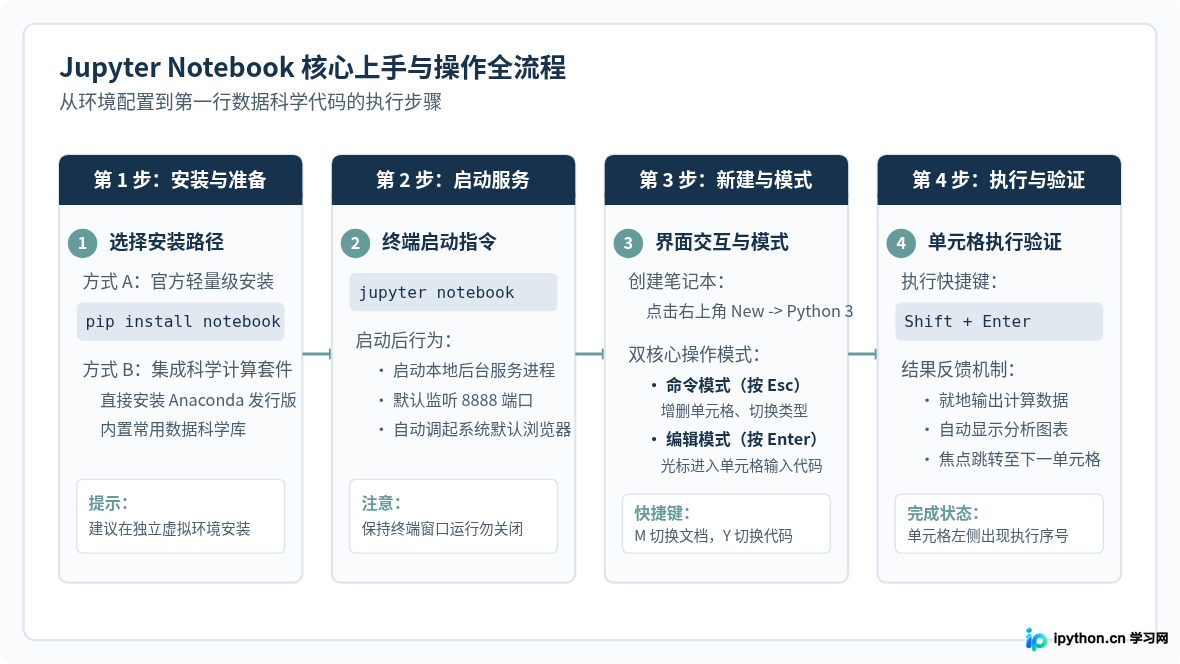
了解了基本原理之后,我们可以通过具体步骤在本地环境中安装并启动 Jupyter Notebook。整个操作流程清晰明确,主要分为环境准备、服务启动、新建交互文件与单元格编写执行四个阶段。
步骤 1:安装环境
如果你已经安装了 Python 环境,可以直接使用 pip 工具安装官方轻量包:
pip install notebook对于数据科学初学者,更推荐直接下载安装 Anaconda 发行版。Anaconda 会自动捆绑 Python 解释器、Jupyter Notebook 以及 NumPy、Pandas、Matplotlib 等数百个常用的科学计算核心库,免去了逐个配置依赖的繁琐操作。
步骤 2:启动本地服务
在你的工作目录打开命令行终端(Windows 用户可打开 PowerShell 或 Anaconda Prompt,macOS/Linux 用户打开 Terminal),输入以下命令启动服务:
jupyter notebook终端会输出类似 http://localhost:8888/?token=... 的本地地址,并自动调起系统默认浏览器打开 Jupyter 的工作台主页。此时请注意:启动服务的终端窗口必须保持打开状态,一旦关闭终端,后台服务与内核也将同步终止。
步骤 3:新建笔记本与理解操作模式
在浏览器页面右上角,点击 New 按钮并选择 Python 3,即可新建一个空白的笔记本。Jupyter Notebook 具有独特的“双操作模式”设计:
- 命令模式(Command Mode):当前单元格边框通常为灰色或蓝色,按键盘
Esc键进入。此时按键作用于单元格本身,例如按A在上方新增单元格,按B在下方新增,双击D删除当前单元格,按M切换为 Markdown 文档单元格,按Y切换为代码单元格。 - 编辑模式(Edit Mode):当前单元格边框变为高亮(通常为绿色),单元格内出现闪烁的光标,按
Enter键进入。此时键盘输入直接用于编写代码或文本。
步骤 4:编写第一段数据分析代码并执行
在一个代码单元格中输入简单的分析代码,例如生成数据序列并打印统计均值:
import math

data = [12, 24, 35, 48, 56, 72]
mean_val = sum(data) / len(data)
print(f"数据总数: {len(data)}, 平均值: {mean_val:.2f}")
输入完成后,按下快捷键 Shift + Enter。此时 Jupyter 会将代码提交给后台的 IPython Kernel 执行,结果将立即渲染在当前单元格的正下方,同时光标自动跳转到下一个单元格。单元格左侧的 In [1]: 标志着这是内核自启动以来的第 1 次执行。
实用技巧提醒:执行单元格的常用快捷键有两个:Shift + Enter 运行当前单元格并移动到下一单元格;Ctrl + Enter 运行当前单元格并保持光标停留在原地。
四、Jupyter Notebook 的核心优势与使用边界
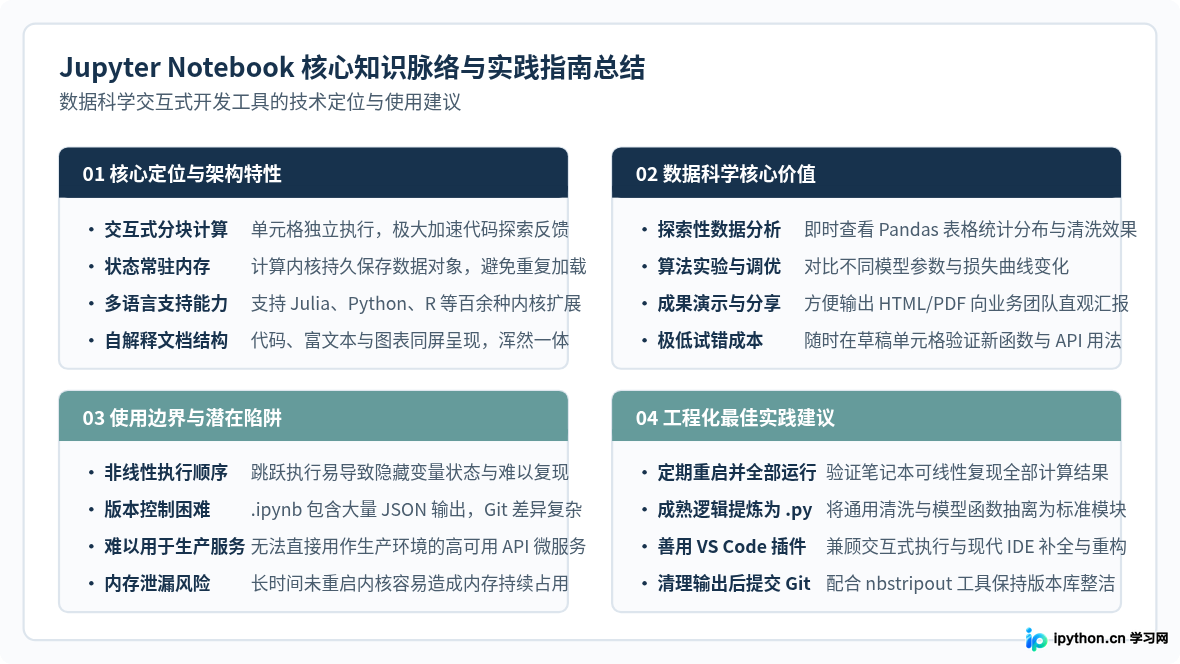
虽然 Jupyter Notebook 在探索性数据分析(EDA)、原型验证、科研实验和教学演示中优势显著,但它并非万能的通用软件开发环境。深入理解其适用边界,才能在项目中合理选型:
主要优势与适用场景
- 探索性数据分析(EDA):数据清洗、异常值排查与多维度统计,随调随看,极大提高分析洞察效率。
- 机器学习与深度学习实验:在长耗时的模型训练后,模型权重保留在内存中,可以随时测试不同的预测样本和评估指标。
- 教学演练与成果汇报:支持丰富的 Markdown 标题、LaTeX 复杂的数学公式以及高分辨率插图,可以直接作为交互式教程或技术演讲文稿。
潜在局限与工程化注意事项
- 非线性执行导致的隐式状态:由于单元格可以按照任意顺序运行(例如先运行第 3 个单元格,再回到第 1 个修改变量后运行第 2 个),如果不小心打乱了顺序,可能会产生“界面代码自顶向下看完全正常,但重新运行却报错”的幽灵状态。最佳实践是定期点击菜单栏的
Kernel -> Restart & Run All,验证整个笔记本是否能按线性顺序从头到尾正确执行。 - 版本控制(Git Diff)不够友好:
.ipynb文件保存了包括图表二进制在内的完整 JSON 内容,在 Git 中进行协同合并或代码审阅时,差异对比往往非常冗长。建议使用nbstripout等工具在提交流程中过滤掉输出数据,仅保留源码。 - 不适合大型工程代码重构:Notebook 缺少大型 IDE 强大的全项目重构、跨模块静态类型检查和微服务部署调试工具。因此在工业界标准流程中,通常“在 Notebook 中完成算法探索与可行性验证,确认逻辑无误后提炼封装为标准
.py模块与自动化测试用例”。
五、总结
Jupyter Notebook 凭借“交互式分块执行、内存对象持久驻留、代码与可视化结果同屏混排”三大核心特性,彻底重塑了数据探索与科学计算的工作方式。它让数据分析师和机器学习工程师能够以最小的试错成本迅速检验想法,直观呈现数据结论。
在实际工作中,你无需在传统 IDE 与 Jupyter 之间做非此即彼的二选一:目前 VS Code、PyCharm 等现代工具均已内置对 .ipynb 格式的原生支持。你可以充分发挥 Jupyter Notebook 探索性敏捷验证的长处,同时结合传统工程化工具进行生产模块封装,打造高效兼顾的数据科学开发体系。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









