

Python数据处理与数据清洗核心操作指南

本文以Python的pandas库为核心,演示数据处理的完整流程。从新增衍生列、控制小数精度、按指标排序筛选,到统一时间货币格式,逐步排查并清理缺失值、逻辑异常值与重复记录,最终输出符合分析要求的高质量数据集。
Python数据处理与清洗的流程解析
在数据分析流程中,原始数据往往包含格式不统一、字段缺失或逻辑矛盾等问题。利用Python内置的pandas模块,可以快速完成特征构造、格式转换与脏数据修复。以下按实际操作顺序演示标准化处理流程。
准备工作:环境确认与依赖加载
pandas是Python生态中专门用于结构化数据运算的第三方库。使用前需确保已安装,并在脚本顶部引入标准别名:import pandas as pd。
真实操作顺序
第1步:构造衍生列并控制输出精度
原始表格通常仅提供基础指标,业务分析常需组合计算。例如将口味评分与人均消费结合生成性价比得分,保留两位小数可避免浮点数溢出干扰排序。
import pandas as pd
df = pd.read_csv("原始文件路径")

# 构造新列
df["性价比评分"] = (df["口味评分"]/df["人均消费"])*40
df["氛围评分"] = (df["服务评分"]+df["环境评分"])/2

# 指定多列保留两位小数并覆盖原表
df[["性价比评分","氛围评分"]] = df[["性价比评分","氛围评分"]].round(2)
print(df)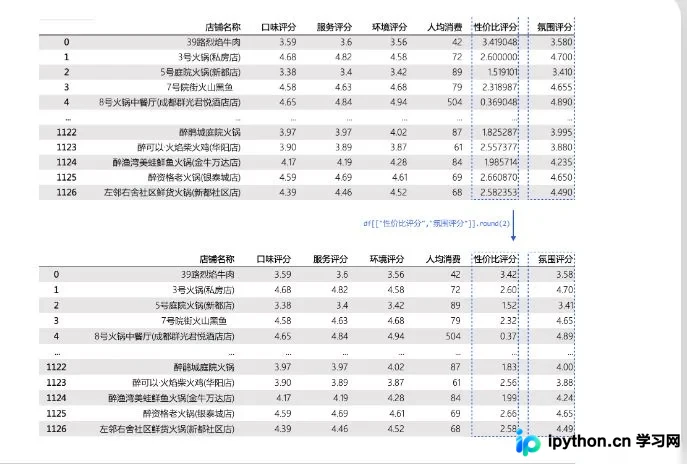
第2步:多指标排序与头部截断
生成评估分数后,通常只需关注排名靠前的样本。sort_values()支持升序或降序排列,head()可直接截取前N行进行可视化核对。
# 按性价比评分降序排列
df_sorted = df.sort_values(by="性价比评分", ascending=False)

# 提取名称与核心指标,查看Top 10
top_10 = df_sorted[["店铺名称","性价比评分"]].head(10)
print(top_10)
第3步:数据类型转换与结构概览
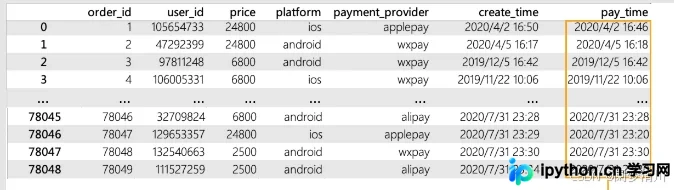
跨系统导出的文件常存在单位不统一或文本型时间戳。清洗的第一步是统一物理量纲,并将字符串转为标准日期对象以便后续区间比对。
# 价格单位由分转元
df['price'] = df['price'] / 100

# 文本时间串转换为 datetime 对象
df['create_time'] = pd.to_datetime(df['create_time'])
df['pay_time'] = pd.to_datetime(df['pay_time'])
第4步:定位缺失值并制定修复策略
调用info()可快速统计各列非空记录数。若某列数值显著低于总量,即存在缺失。
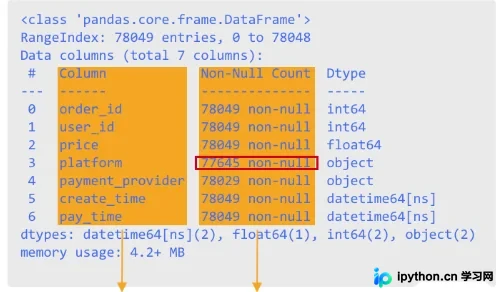
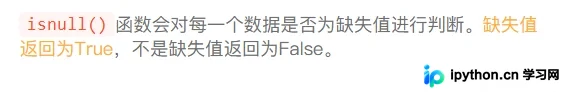
明确缺口后,使用isnull()配合布尔索引可精准定位行号:
第5步:执行删除或补全操作
数据量充足且该字段非核心结论依据时,直接剥离无效行;若缺失占比极高或该字段影响模型权重,则需注入占位符填补。
# 方案A:丢弃含空值的整行(inplace=True 原地修改)
drop_idx = df[df['payment_provider'].isnull()].index
df.drop(index=drop_idx, inplace=True)

# 方案B:使用固定字符串填充空缺
df['platform'].fillna("unknown", inplace=True)
第6步:拦截异常值与清理重复记录
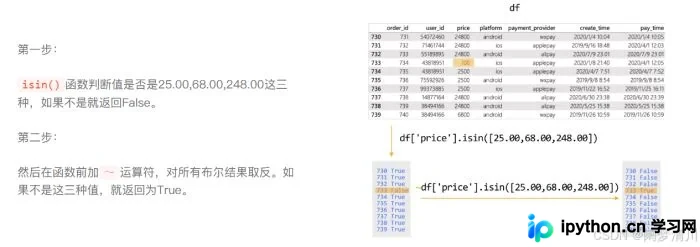
业务逻辑矛盾(如支付时间早于下单时间)或主键冲突会直接破坏分析结果。利用关系运算符与~取反符号可快速筛除违背常识的数据,duplicated()则负责去重校验。
# 逻辑校验:支付时间不得早于创建时间
df_wrong = df[df['pay_time'] < df['create_time']]

# 主键去重:保留首次出现的 order_id 记录
df_dups = df[df['order_id'].duplicated()]
# 确认无误后可使用 df.drop_duplicates(subset=['order_id'], keep='first', inplace=True) 彻底清理
完成状态判断与注意事项
当info()显示所有列非空计数一致,describe()无负数或越界极值,且主键唯一性检验通过后,即可判定数据清洗流程闭环。建议在操作前后备份原始副本,并使用inplace参数谨慎执行覆盖。
简要总结
掌握pandas的组合计算、精度控制、格式转换与布尔过滤,能够高效解决绝大多数表格预处理痛点。合理搭配缺失值填充策略与去重逻辑,可显著提升下游建模或报表生成的准确率。以上就是Python数据处理和数据清洗核心操作的详细内容,更多关于Python pandas高级应用技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









