

PHP正则解析CSS图片并自动下载保存到本地
本文介绍使用PHP脚本批量获取CSS文件中引用的图片地址,并通过正则匹配与文件读写功能将远程图片下载保存到本地的完整流程。核心步骤包括读取CSS源码、利用preg_match_all提取图片URL、校验目录权限及写入本地文件,解决静态资源本地化需求。
2026-10-14
3

本文介绍使用PHP脚本批量获取CSS文件中引用的图片地址,并通过正则匹配与文件读写功能将远程图片下载保存到本地的完整流程。核心步骤包括读取CSS源码、利用preg_match_all提取图片URL、校验目录权限及写入本地文件,解决静态资源本地化需求。
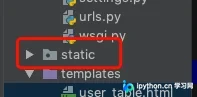
本文详解Django项目中手动创建static文件夹并配置CSS资源的方法。涵盖从创建空文件夹、修改settings配置文件,到添加Bootstrap本地文件及在HTML模板中正确引用的完整步骤,帮助开发者解决静态资源加载问题。
本文详解原生JavaScript获取DOM元素最终样式的多种方法。通过对比 ele.style、getComputedStyle() 和 currentStyle,阐述各自特性及浏览器兼容性差异。文章提供完整代码示例,并封装了一个兼容 IE6+ 与现代浏览器的通用工具函数,帮助开发者在跨环境开发中准确读取计算后的 CSS 值。
在博客园中,通过CSS的fixed属性将图标固定在屏幕右下角,利用JavaScript的setInterval和scrollBy方法实现平滑滚动到页面顶部,提升用户体验。
本文介绍如何利用CSS的@media print规则优化网页打印效果。通过定义独立的打印样式表,可控制页面断点(page-break-after)、隐藏屏幕专用UI元素,并结合ActiveX或现代浏览器API实现打印预览与调用。重点解决报表导出时的布局错乱与多余内容干扰问题,确保纸质输出清晰专业。
本文详细介绍Django模板语言(DTL)中加载CSS、JS及图片等静态文件的标准流程。涵盖{% load static %}的使用、settings.py中INSTALLED_APPS与STATIC_URL的配置、app内static目录规范、STATICFILES_DIRS全局路径设置,以及未启用staticfiles时的URL映射方案,帮助开发者解决静态资源加载问题。
本文详解如何使用Python的Beautiful库结合CSS选择器高效抓取京东商品信息。通过解析搜索URL参数、利用urllib.quote编码关键词,并编写具体的CSS提取逻辑,快速获取商品名称、链接、图片及价格。适合希望掌握轻量级网页解析技术的开发者参考。
Jupyter Notebook默认使用宋体,在高分辨率屏幕上显示效果不佳。本文介绍如何通过修改Jupyter用户目录下的custom.css文件,将代码、输出及界面元素字体统一设置为Consolas和微软雅黑,从而提升高分屏下的视觉清晰度和阅读体验。
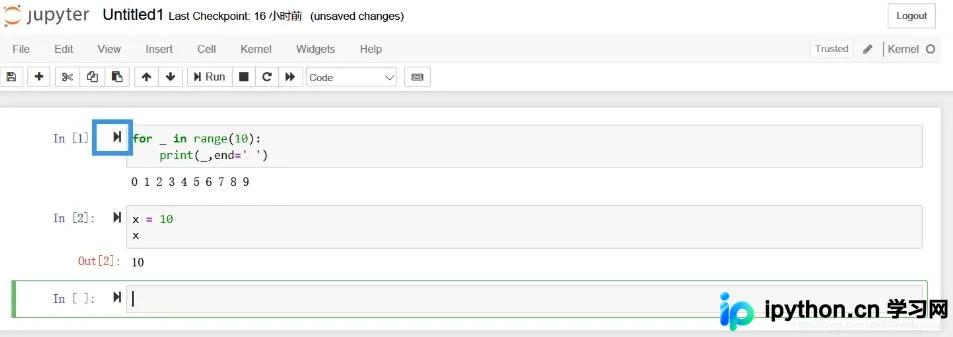
本文介绍在Jupyter Notebook中清除单元格输出的两种方法:使用IPython的clear_output函数以及通过easydl库简化操作。同时,详细讲解如何通过修改CSS文件隐藏输入框前的运行按钮,优化界面显示效果。
本文详解Python爬虫中PyQuery模块的基本用法。PyQuery基于lxml,提供类似jQuery的API解析HTML/XML。内容涵盖模块安装、三种初始化方式(字符串、URL、文件)、丰富的CSS选择器(标签、类、ID、属性、伪类)及DOM操作(查找、过滤、添加/移除Class)。通过豆瓣新书爬取实例,演示如何定位元素、提取文本属性及处理分页逻辑,适合Python初学者快速掌握网页数据抓取技巧。
本文梳理了 CSS 文字特效的实现方法。首先解析历史上用于 Internet Explorer 的专有滤镜(如 glow、blur、dropshadow)的原理及局限,并指出其兼容性差的问题。随后重点介绍现代标准 CSS3 技术,包括 filter 属性(用于高斯模糊、阴影等)、text-shadow(用于投影)、background-clip 和 mask-image(用于蒙版)。提供跨浏览器兼容的示例代码,帮助开发者在无需 JavaScript 的情况下实现高质量的视觉设计效果。
本文详细讲解在Django项目中如何正确配置并调用本地的CSS和JavaScript文件。通过创建static目录、修改settings.py中的STATICFILES_DIRS以及在前端HTML中正确引用路径,解决静态资源加载问题。