

Python多进程写入同一文件:解决GIL限制与数据竞争
本文探讨Python多进程处理大文件时的性能瓶颈与解决方案。针对GIL导致的单线程限制,介绍利用multiprocessing库实现多进程并行处理。重点讲解如何通过回调函数机制优雅解决多进程写入同一文件时的资源争用问题,避免加锁导致的性能下降及Windows环境下的文件句柄错误,提供完整代码示例与注意事项。
2026-10-13
6

本文探讨Python多进程处理大文件时的性能瓶颈与解决方案。针对GIL导致的单线程限制,介绍利用multiprocessing库实现多进程并行处理。重点讲解如何通过回调函数机制优雅解决多进程写入同一文件时的资源争用问题,避免加锁导致的性能下降及Windows环境下的文件句柄错误,提供完整代码示例与注意事项。
本文深入解析Python全局解释器锁(GIL)对多线程性能的影响,区分计算密集型与I/O密集型任务的特征。针对GIL限制,提出使用multiprocessing模块进行多进程并行处理及C扩展释放GIL的解决方案,帮助开发者根据任务类型选择最优并发策略。
本文详解Python多线程编程中互斥锁Threading.Lock的应用。通过实例分析线程共享资源导致的“线程不安全”问题,阐述互斥锁锁定/非锁定状态机制如何保证数据正确性,并展示Lock类的acquire与release方法及超时参数timeout的使用,帮助开发者实现线程同步。
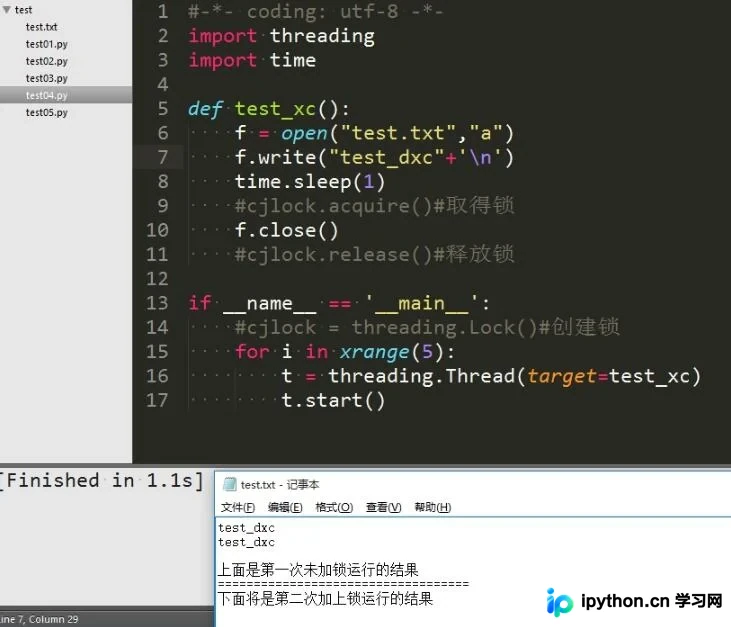
本文探讨Python多进程中主进程与子进程默认无法共享全局变量的机制,并详细解析实现数据共享的四种核心对象:Value、Array、Manager字典及列表。同时对比介绍进程间通信的两种常用方式,即用于单向通信的Queue和用于双向通信的Pipe,帮助开发者高效处理并发数据同步问题。
本文详细讲解如何使用Python基于C/S模式实现聊天室功能。首先介绍最简单的半双工通信模型,双方轮流发送消息;随后深入探讨全双工实现方案,通过多线程技术使服务器和客户端能同时收发数据。文章提供完整的服务器与客户端代码示例,帮助开发者掌握Socket编程基础及并发处理技巧。
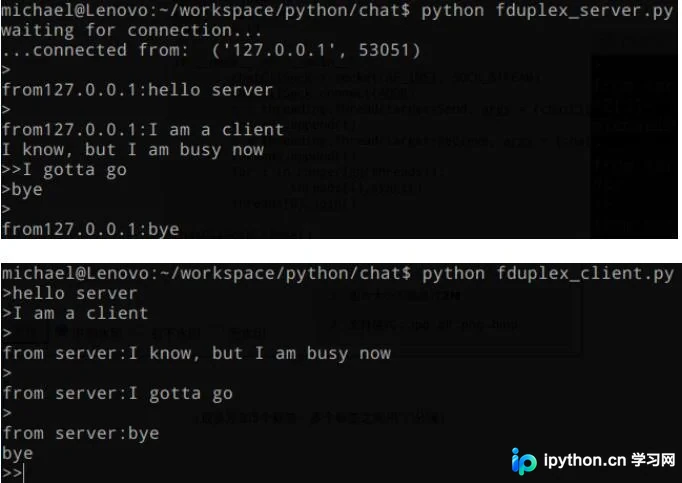
本文详细解析Java实现多线程的两种方式:继承Thread类和实现Runnable接口。重点比较两者的区别,指出实现接口能避免单继承局限性并共享资源的优势。通过同步代码块synchronized解决线程安全问题,并提供完整的Ticket售票模拟代码示例,帮助开发者掌握正确的多线程开发模式。
本文介绍PHP在不依赖底层多线程模块的情况下,通过改变URL参数和Shell脚本实现并发处理的技巧。利用Apache对相同进程的处理机制差异,演示如何并行执行耗时任务,并结合Linux Shell批量调用PHP以模拟高并发场景,适用于无需修改服务器配置的快速测试与轻量级异步需求。
本文介绍如何使用 Python 3.x 编写基于 XML 数据的 HTTP 请求脚本,适用于 B/S 架构下的 WEB 服务通信测试。文章详细讲解了利用 urllib.request 发起请求、多线程并发处理、类与方法定义等核心技术,并提供了包含配置文件和源码的完整示例,旨在帮助开发者快速实现功能验证及初步的压力测试。
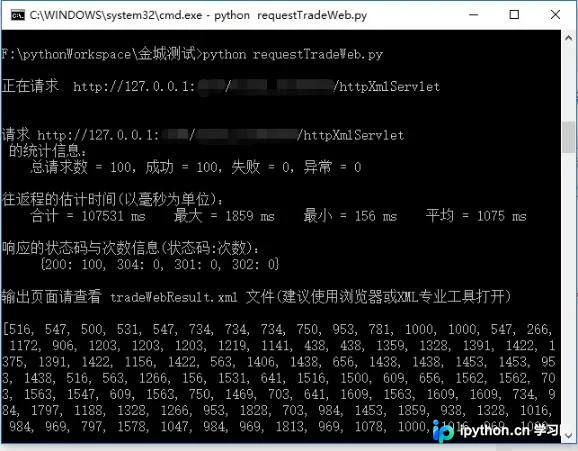
针对树莓派无显示器且需移动使用的场景,本文介绍如何使用Python脚本在开机后自动获取本机IP地址,并通过SMTP协议发送至指定邮箱。内容涵盖网络接口遍历、IP提取、邮件发送函数实现,以及通过修改/etc/profile实现脚本开机自启的完整配置步骤,帮助开发者便捷管理远程设备网络状态。
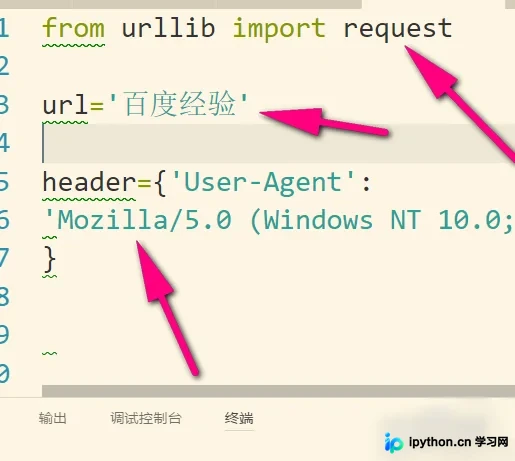
本文详解Python3爬虫中请求头Header的构建方法。通过浏览器开发者工具Network面板提取User-Agent,结合Request类构造GET或POST请求,并演示使用urlopen发送请求的完整流程,帮助开发者有效伪装浏览器身份。
本文详细介绍Python爬虫中处理非200状态URL的重试机制。提供Python 2.7与3.5版本的同步requests实现及异步aiohttp方案,并封装可复用的重试装饰器。代码涵盖错误捕获、递归重试逻辑及异常处理,适用于需要提高爬虫稳定性的场景。
本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。