

Python协程返回值获取方法详解
本文介绍在Python中如何通过asyncio库从协程获取返回值。核心步骤包括使用get_event_loop()获取事件循环对象,并调用run_until_complete()执行协程直至完成,从而捕获协程返回的具体结果。
2026-10-13
6

本文介绍在Python中如何通过asyncio库从协程获取返回值。核心步骤包括使用get_event_loop()获取事件循环对象,并调用run_until_complete()执行协程直至完成,从而捕获协程返回的具体结果。
本文介绍如何利用Python多线程技术实现两个LED灯同时点亮。通过继承threading.Thread类创建独立线程分别控制蓝灯(引脚13)和红灯(引脚12),避免Shell脚本的繁琐操作。文章提供了详细的GPIO接线方案及完整Python代码,展示线程创建、启动及资源清理的全过程,适用于毕业设计中的多传感器并发执行场景。
本文分析Python多线程调用exit时无法退出的问题,指出SystemExit异常被捕获导致需两次Ctrl+C退出。通过在线程启动前设置setDaemon(True),可将线程设为守护线程,从而解决该问题,确保程序正常退出。
本文介绍Python中多线程程序因异常导致线程停止时的自动重启方案。通过threading模块的setName和enumerate方法,记录初始线程组并定期对比,发现缺失线程时立即重新创建并启动,确保程序稳定运行。
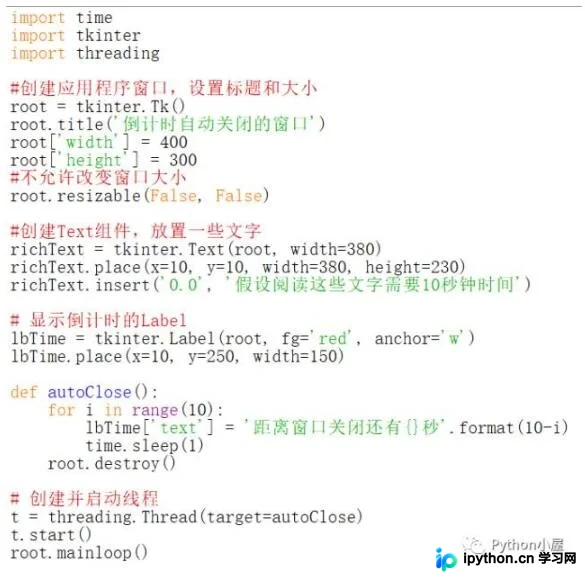
本文介绍如何在Python中使用tkinter库结合多线程技术,实现窗口在运行指定时间后自动关闭的功能。通过调用destroy()方法并配合线程控制,可有效管理GUI应用的生命周期,适用于需要限时展示信息的场景。
本文介绍使用Python多进程与队列机制批量将域名解析为IP的方法。通过拆分域名列表、多进程并发解析并写入文件,利用锁机制防止写入冲突,实现高效批量处理。
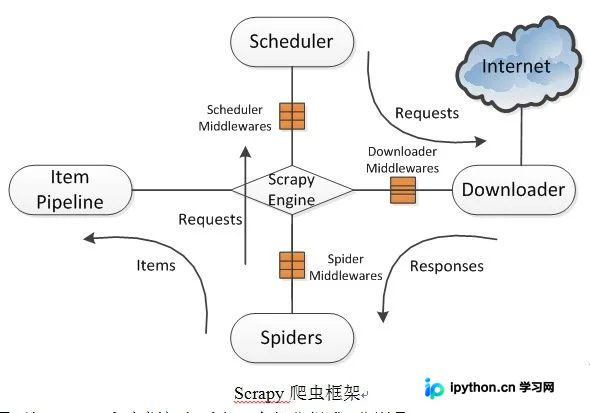
本文深入解析Scrapy网络爬虫框架的工作原理,详细阐述引擎、调度器、下载器、蜘蛛及管道五大核心组件的交互流程。同时提供基于Scrapy创建爬虫项目的完整命令行操作指南,涵盖项目结构解析、关键配置文件说明及程序执行方法,帮助开发者快速掌握Scrapy的数据采集与处理流程。
本文介绍利用Python threading模块实现多线程并行统计指定文件夹下所有CSV文件行数的方法。通过自定义线程类封装文件读取逻辑,结合os模块遍历目录,最终汇总各文件行数。该方法适用于需要快速处理大量CSV文件的场景,代码包含完整的类定义、线程启动及结果收集过程。
本文介绍使用Python实现类似MapReduce的大数据分析流程,涵盖大文件切分、Mapper映射及Reducer归约三个核心步骤。通过正则表达式提取日志日期并统计频次,结合多线程技术处理切分后的文件,最终输出按日期排序的统计结果,适用于系统日志的批量处理场景。
本文详细解析Python中threading.Thread类的核心用法。涵盖通过回调对象或重写run()方法两种线程指定方式,深入讲解start()、join()、isAlive()等关键方法的执行逻辑与阻塞机制。同时完整列举构造函数参数(group、target、name、args、kwargs)及守护线程、线程命名等高级特性,帮助开发者掌握Python多线程编程的最佳实践。
本文详解如何使用Python的subprocess模块调用ping命令判断IP是否可达,并结合threading实现多线程并发检测。针对基础版本存在的线程竞争问题,进一步介绍利用Queue队列进行优化的方案,通过FIFO机制提升并发处理的稳定性与效率。
本文介绍利用Python高效检测网段内在线IP的两种方案。针对设备众多、重复维护场景,分别采用threading模块实现多线程并发ping,以及gevent资源池进行异步IO处理。通过对比两种代码实现,帮助开发者快速掌握批量网络连通性检测技巧,提升运维效率。