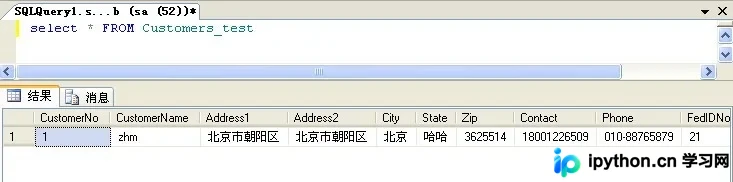
Python连接SQL Server 2008数据库实战:pyodbc配置与中文乱码解决
本文详解Python使用pyodbc库连接SQL Server 2008数据库的完整流程,涵盖连接字符串配置、游标操作及事务提交。重点解决中文数据显示为乱码问题,通过指定UTF-8字符集参数实现正确显示,并提供完整代码示例供参考。
2026-10-13
6

本文详解Python使用pyodbc库连接SQL Server 2008数据库的完整流程,涵盖连接字符串配置、游标操作及事务提交。重点解决中文数据显示为乱码问题,通过指定UTF-8字符集参数实现正确显示,并提供完整代码示例供参考。
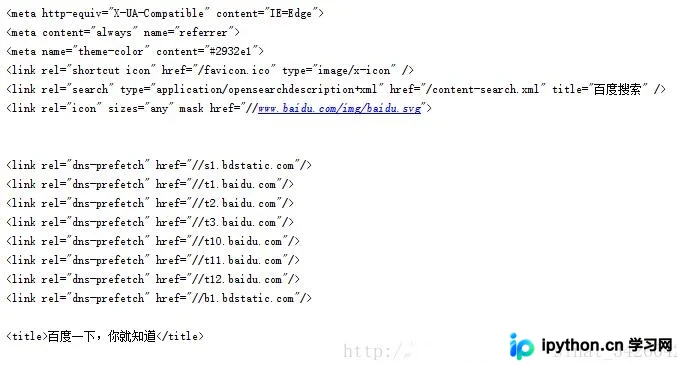
本文分析Python爬虫中中文显示乱码的根本原因,即默认Unicode解析与系统编码格式不匹配。通过示例代码展示如何利用urllib获取网页,将UTF-8内容解码后重新编码为系统默认格式,从而完美解决中文输出乱码问题,适用于百度等常见网页抓取场景。
本文介绍如何解决Pandas中使用to_json()导出中文数据时出现的\uXXXXXX乱码问题。通过设置force_ascii=False参数,可直接在to_json中保留中文。此外,文章还演示了如何将DataFrame转换为Python原生列表,利用json.dumps的ensure_ascii=False参数生成格式化的JSON数组,并提供了完整的封装类源码供参考。

本文介绍Python及Pandas在处理文件读写时遇到的编码问题。通过记事本另存为UTF-8,或在Pandas中指定encoding参数(如gb2312),可有效解决Excel打开或写入时的中文乱码现象。
本文针对Python3爬虫抓取网页时出现的中文乱码问题,提供基于urllib库的编码处理方案。通过获取系统默认编码并手动解码响应内容,可有效解决数据展示异常,确保抓取结果正确显示中文。
本文总结Python 2.7环境下处理中文编码的实用技巧。通过设置默认编码、使用unicode函数处理文件路径,以及利用codecs模块写入BOM头,可有效解决文件名及Excel打开时的中文乱码问题。
本文介绍在Python中使用open打开包含中文的文件时出现乱码的解决方法。通过先以gbk格式解码再转换为utf-8编码,可正确输出中文字符。示例代码展示了具体实现步骤,适用于处理常见编码不一致问题。
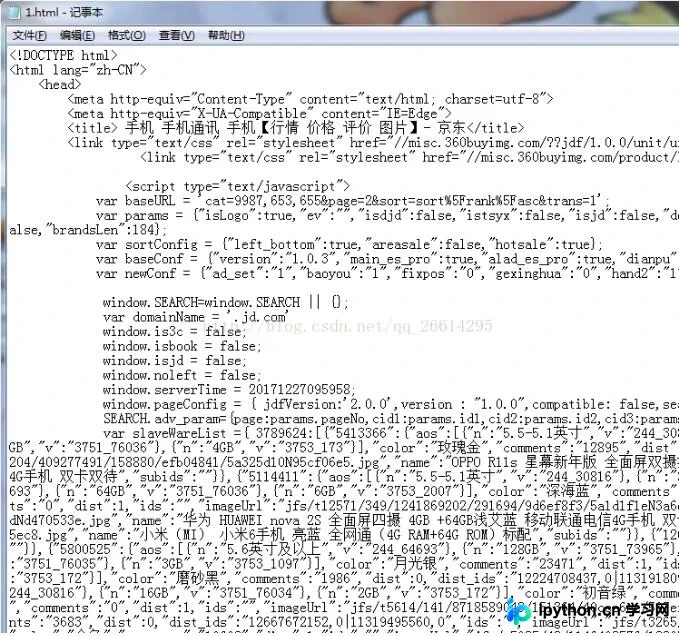
本文深入解析Python处理中文乱码的核心原理,重点区分“字符”与“字节”的概念。通过对比Python、Perl及Ruby在编码处理上的差异,解释str与unicode的区别,以及encode和decode的实际作用,帮助开发者从根本上理解并解决编码问题。
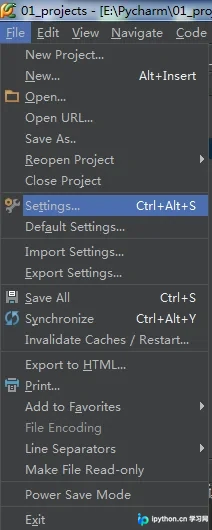
本文介绍在PyCharm中运行Python代码时出现中文乱码的两种解决方案。首先建议在文件头部添加编码声明及sys模块设置;若无效,则通过修改IDE全局设置中的控制台编码为UTF-8来解决。
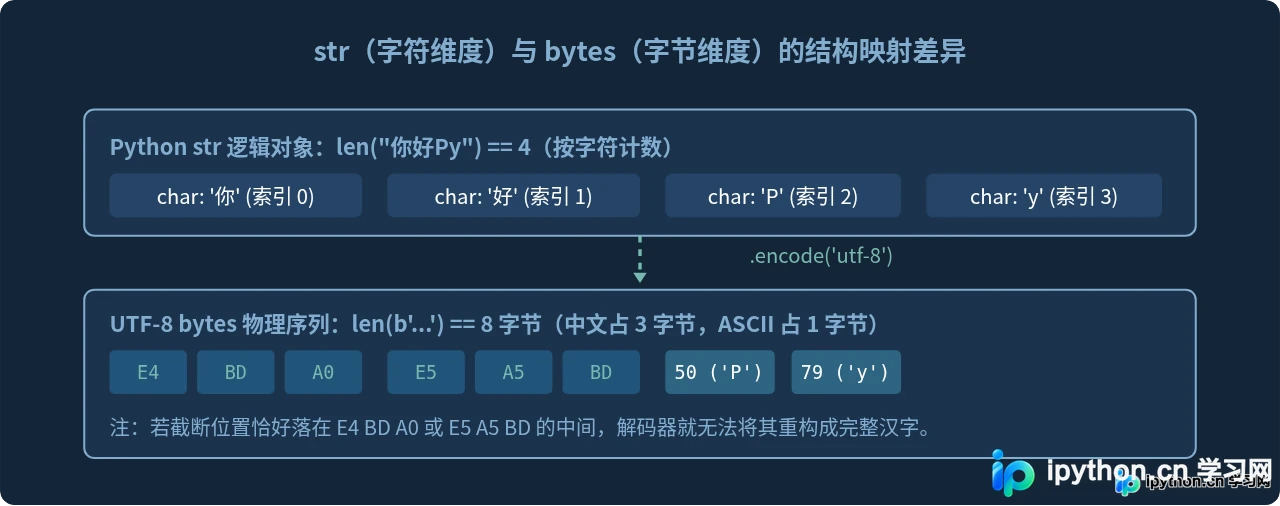
针对Python截取中文字符串时出现的乱码、UnicodeDecodeError问题,深入解析str字符长度与bytes字节长度的区别,并提供按字符切片、安全按字节截断及网络封包处理的完整解决方案。
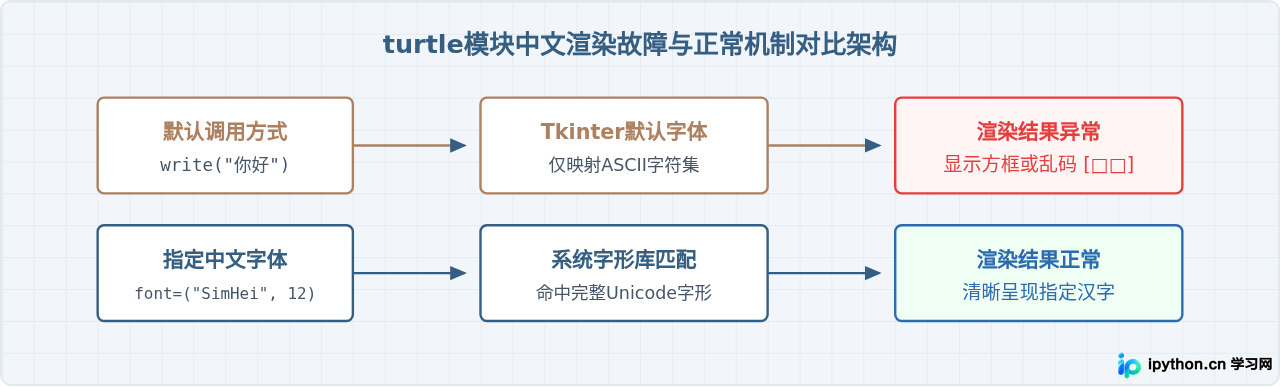
针对Python标准库turtle模块绘制中文时出现方框、问号或乱码的情况,系统分析根本原因,并提供精准设置中文字体名称、编码规范及跨平台兼容方案。
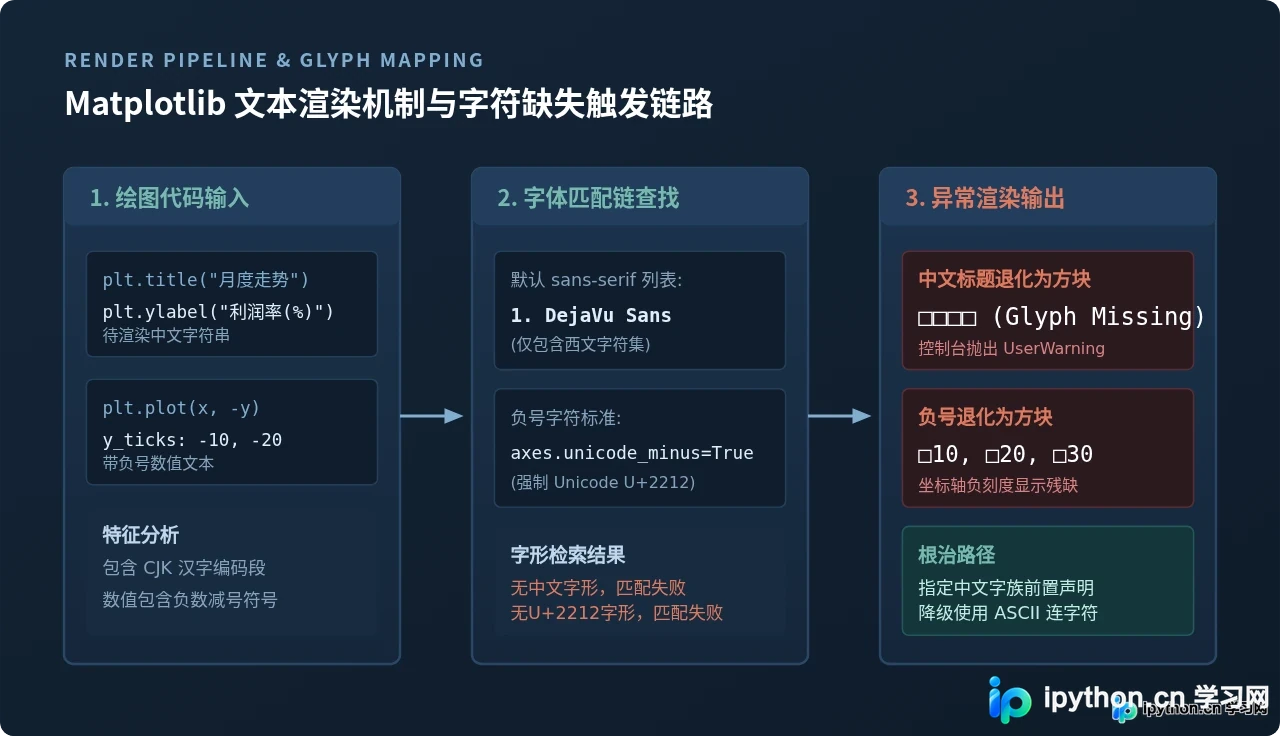
针对Python使用Matplotlib绘图时出现的中文显示方块与负号乱码问题,系统讲解字符编码与字体回退机制,提供跨平台全局配置代码、字体缓存排查步骤及专业级图表美化技巧。