Python3处理乱码与\xe6\x97\xa0\xe6\xb3\x95字符编码转换详解
本文深入解析Python3中字符串与字节流的区分机制,详细演示如何使用encode和decode方法处理\xe6\x97\xa0\xe6\xb3\x95格式的乱码。通过raw_unicode_escape编码及str()构造函数,提供将字节串转换为可读汉字的实用代码示例,并涵盖从网络抓取网页时处理中文乱码的实际应用技巧。
2026-10-13
6

本文深入解析Python3中字符串与字节流的区分机制,详细演示如何使用encode和decode方法处理\xe6\x97\xa0\xe6\xb3\x95格式的乱码。通过raw_unicode_escape编码及str()构造函数,提供将字节串转换为可读汉字的实用代码示例,并涵盖从网络抓取网页时处理中文乱码的实际应用技巧。
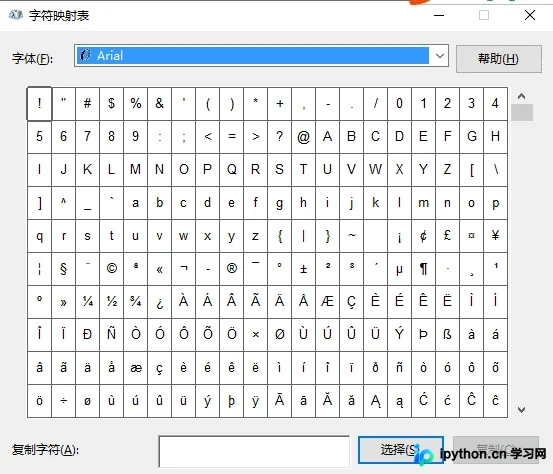
本文介绍了在Python中打印特殊符号的两种方法。一是通过Windows系统自带的字符映射表(charmap)查找并输入符号;二是利用Python内置的chr()函数,根据Unicode编码值直接打印出如Σ、箭头及❋等特定符号。
本文详解Python文件操作核心知识,涵盖ASCII、GBK到UTF-8的字符编码演变及Python2与Python3的差异。深入解析r、w、a及t、b模式的组合用法,介绍with语句的文件上下文管理。重点对比全量加载与逐行处理两种文件修改方式,并系统讲解无参、有参及空函数的定义规范与应用场景。
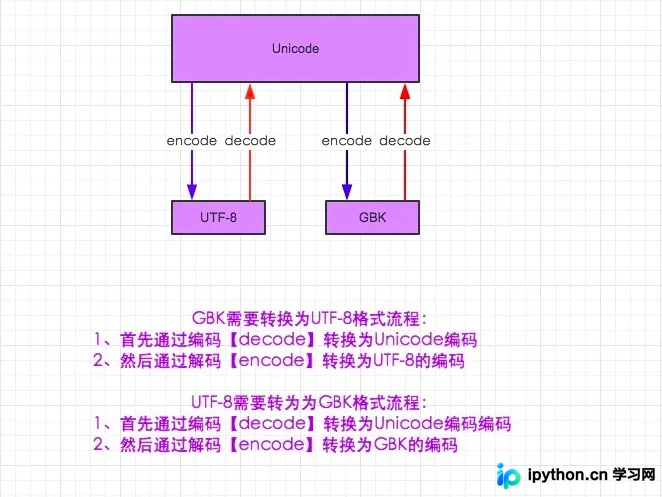
本文梳理了从ASCII到UTF-8的字符编码发展史,重点解析Python2与Python3在字符串处理上的核心差异。通过具体代码示例,展示了Python2中字节串与Unicode互转的decode/encode流程,以及Python3中字符串直接编码为字节串的新机制,帮助开发者理解不同版本下的编码转换逻辑。
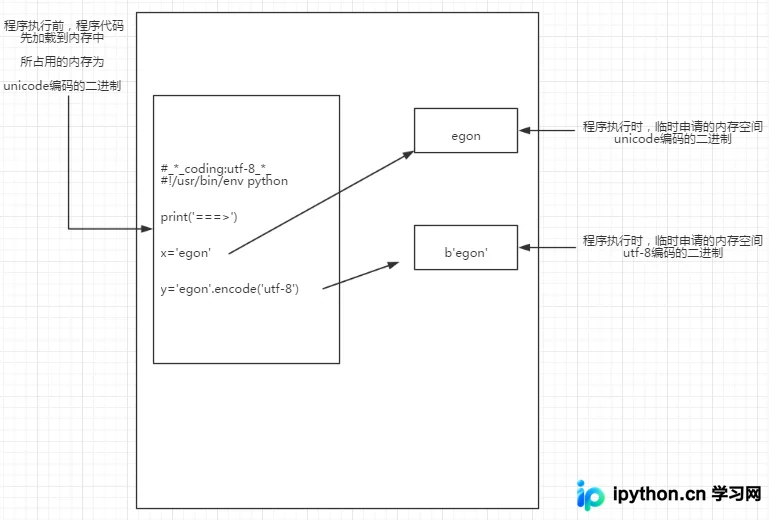
本文深入解析Python字符编码机制,阐述ASCII、GBK、Unicode及UTF-8的发展与区别。重点讲解Python解释器执行流程中文件读写与内存编码转换原理,对比Python2与Python3在字符串类型(str/bytes/unicode)及默认编码策略上的核心差异,帮助开发者避免编码错误。
本文详细对比了Python 2与Python 3在版本迭代、函数接口及字符编码处理上的核心差异。重点解析了print函数变更、第三方库支持现状,以及Python 3中str与bytes类型的明确分离机制,帮助开发者理解从Python 2迁移至Python 3的技术要点与编码优化逻辑。
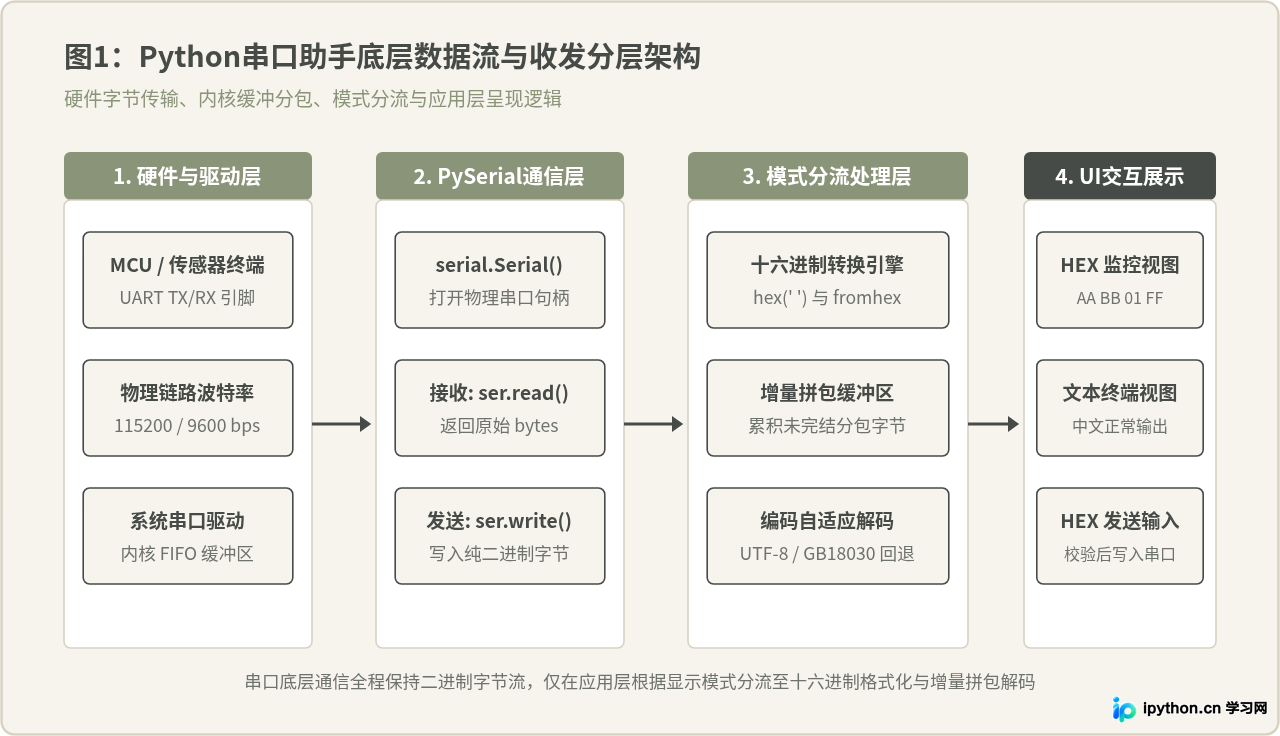
深入解析Python串口助手源码中十六进制收发的实现细节与串口乱码的根源,提供健壮的HEX数据清洗、字节流分包拼接与字符集安全解码实用技巧。
当 PHP 环境未启用 mbstring 扩展时,处理 UTF-8、GBK 等多字节字符易出现乱码或截取不全。本文提供两套实用方案:第一套通过正则匹配统计中文字符长度并模拟 substr 进行安全截取;第二套封装支持 GB2312、GBK、UTF-8 和 Big5 编码的通用截取函数,自动添加省略号后缀,确保前端显示完整且无乱码。
本文深入解析 Python 字符编码机制,对比 Python2 与 Python3 在默认编码及内存处理上的差异,重点阐述 .py 文件头编码声明的作用。同时详细介绍文件处理的两种模式:字符方式(t)与二进制方式(b),强调 encoding 参数的使用场景及资源释放规范,帮助开发者避免乱码并高效管理文件资源。
本文详细解析Python3中全角(DBC)与半角(SBC)字符的转换原理及实现方法。通过解析字符编码差异,提供完整的转换函数代码,涵盖数字、字母及常见标点符号的互转逻辑,并特别指出中文及特殊符号的处理边界,适用于学生答题数据清洗等场景。
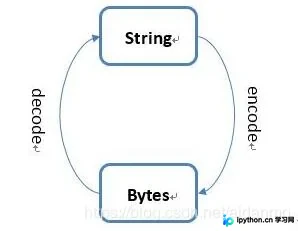
本文深入解析Python3如何解决Python2遗留的字符编码问题。通过对比Python2中ASCII默认编码及str/unicode混淆的缺陷,阐述Python3将默认编码设为UTF-8,并清晰区分str(文本)与bytes(二进制)类型。文章详细说明了bytes类型的定义、操作限制及与str的转换方法,包括encode和decode的具体应用,帮助开发者避免编码错误。
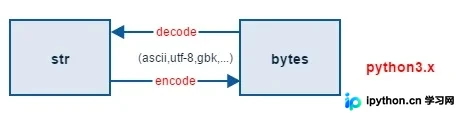
本文详细解析Python中字符编码转换的原理与操作。重点对比Python 2与Python 3在字符串处理上的差异,通过具体代码示例演示GBK与UTF-8编码的互转过程。文章涵盖encode与decode的使用场景,以及不同版本中字符串类型的变化,帮助开发者解决乱码问题。