

Python串口助手源码中十六进制收发与乱码处理技巧

bytes)。所谓“十六进制收发”,核心是业务层对输入输出数据完成字节与十六进制字符串的双向规范化解析;而串口乱码的根源,则是底层离散分包切片机制破坏了多字节字符编码(UTF-8 或 GBK)的完整性。本文将结合底层通信模型与可运行的 Python 源码,深入剖析十六进制数据格式清洗、边界校验、增量解码缓冲与编码自适应回退的关键技巧。
一、串口底层通信模型与数据流分层架构
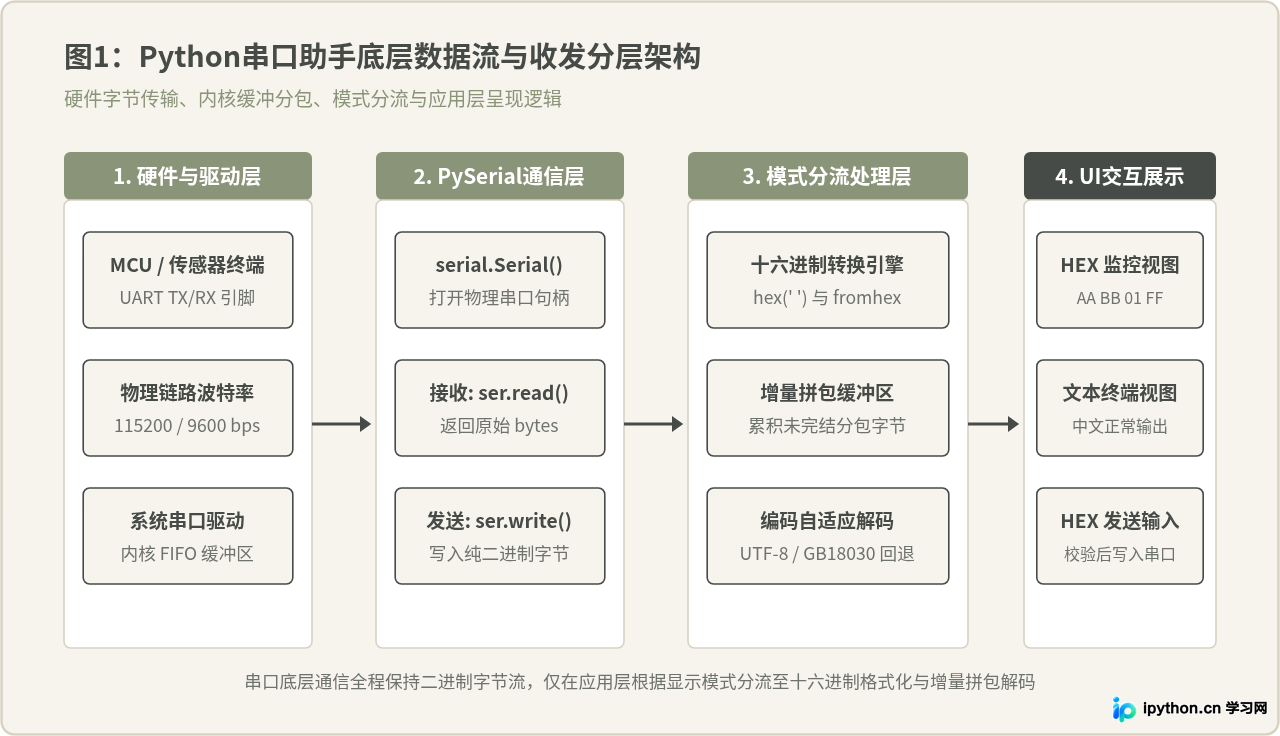
许多初学者在实现串口助手时,常将串口视作普通的文本控制台,直接在界面调用 ser.write(text.encode()) 发送数据,或直接对 ser.read() 返回的数据执行 decode('utf-8')。这种做法忽略了串口通信的分层特性。无论是通过 USB 转串口芯片(如 CH340、CP2102)还是原生 UART,物理线路和操作系统驱动层流动的始终是原始字节序列。
为了构建稳定高效的串口助手源码,程序架构必须将“底层通信传输”与“应用层格式化表现”明确解耦。串口接收线程负责持续从内核 FIFO 缓冲区读取原始 bytes;随后根据用户勾选的呈现模式(HEX 显示或文本显示)分流至对应的处理通道。同样,发送逻辑必须先将用户输入的格式化文本清洗并打包为标准二进制字节,再交付 PySerial 写入硬件。
二、十六进制发送(HEX Send)源码实现与格式清洗技巧
常见误区认为“发送十六进制只需将字符串转为 hex 字符串”。如果在发送输入框填入 "AA BB 01",若直接执行 ser.write("AA BB 01".encode('utf-8')),实际通过串口发出的是 8 个 ASCII 字符(对应十六进制字节 0x41 0x41 0x20 0x42 0x42 0x20 0x30 0x31),单片机收到后无法识别预期的 3 字节协议帧。
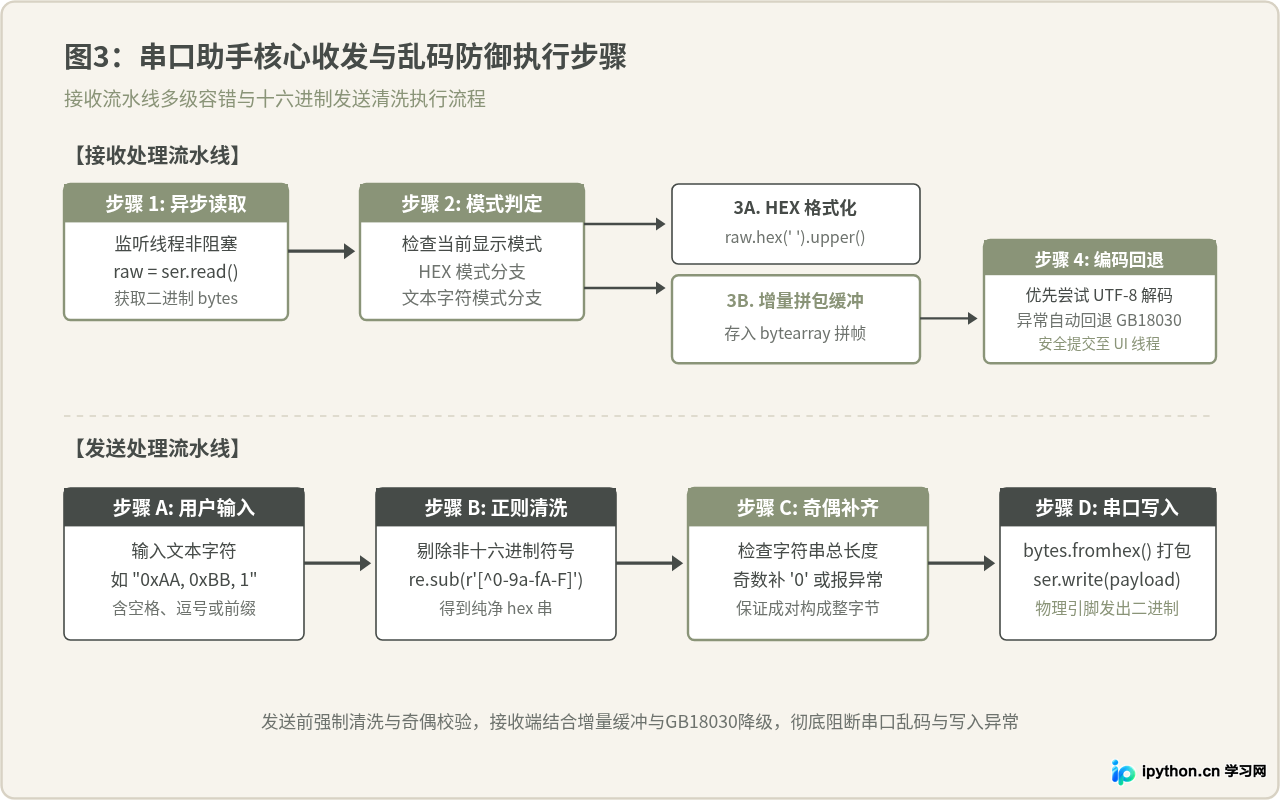
真正的 HEX 发送逻辑,是将用户输入的文本解析为物理内存中的二进制字节流。真实应用中,用户输入可能混杂多种字符,例如带有 0x 前缀、逗号、连续空格、制表符甚至末尾多余字符。因此,发送处理函数必须包含健壮的“清洗”、“奇偶校验”与“打包”环节。
有人认为“只要长度为奇数,末尾补一个零即可”。这种做法看似宽容,但往往隐藏严重危害。例如用户原本想输入
0x0A 0x0B,却少输了一个字符变成 0A 0,如果自动补成 0A 00,就篡改了命令含义。更严谨的做法是:在前导补零(若只输入单字符)或直接抛出明确提示,由用户确认输入完整性。
以下为 Python 源码中推荐的格式清洗与转换函数:
import re

def clean_and_parse_hex(hex_input: str) -> bytes:
    """
    清洗用户输入的十六进制字符串,并转换为严格的 bytes 二进制序列。
    支持过滤 0x 前缀、空格、逗号、分号及换行符。
    """
    if not isinstance(hex_input, str):
        raise TypeError("输入必须为字符串")

    # 1. 移除 0x/0X 前缀,以及所有非 16 进制字符(包括空格、逗号等)
    cleaned = re.sub(r'0[xX]|[^0-9a-fA-F]', '', hex_input)
    if not cleaned:
        return b''

    # 2. 奇偶长度校验:一个完整字节由两位十六进制数字构成
    if len(cleaned) % 2 != 0:
        raise ValueError(
            f"十六进制字符串长度为奇数 ({len(cleaned)}),"
            f"无法构成完整字节序列。请核对最后一位数据:'{cleaned[-1]}'"
        )

    # 3. 使用标准库高效转换为二进制 bytes
    try:
        return bytes.fromhex(cleaned)
    except ValueError as err:
        raise ValueError(f"十六进制转换失败: {err}") from err
在 GUI 事件响应中调用该函数后,再通过 ser.write(payload) 将转换后的字节流写入串口。这样能杜绝无效输入导致的下位机协议解析超时。
三、十六进制接收(HEX Receive)源码实现与实时格式化
在接收端,底层读取到的 bytes 数据需要被直观展示在监控窗口。若直接输出 bytes.__repr__()(例如 b'\xaa\xbb\x01'),可读性较差,且不利于与外部协议文档对照。
十六进制接收展示的核心是规范格式化。Python 3.8+ 提供了内置的 bytes.hex(sep) 方法,支持指定单字节之间的分隔符。配合大写转换,可直接输出符合工业标准的 "AA BB 01" 样式。此外,在高波特率(如 921600 bps)持续传输时,若每个单字节到达都触发一次 UI 重绘,将导致主线程界面严重卡死。合理的做法是在接收子线程中以块(chunk)为单位读取,并适度合并刷新。
def format_hex_receive(raw_bytes: bytes, sep: str = ' ', uppercase: bool = True) -> str:
    """
    将串口接收到的原始 bytes 格式化为规整的十六进制字符串。
    示例输出: 'AA BB 01 FF'
    """
    if not raw_bytes:
        return ""

    # 利用 bytes.hex 内置分隔符功能,避免手动循环遍历
    hex_str = raw_bytes.hex(sep)
    return hex_str.upper() if uppercase else hex_str
四、串口中文字符乱码的三大根本原因深度剖析
串口调试中最令开发者困扰的问题之一是中文乱码。乱码并非随机故障,而是以下三种明确机制导致的确定性结果:
-
1. 物理层波特率与时钟采样失配:
波特率代表每秒传输的符号数。如果发送端配置为 115200 bps,而接收端误设为 9600 bps,接收端 UART 采样时钟周期将完全错位,读入的数据会彻底沦为毫无规律的伪随机字节。此场景不仅文本乱码,十六进制监视器中也会呈现大量
0x00或混乱字节。 -
2. 字符集编码失配(GBK/GB2312 vs UTF-8):
国内大量的嵌入式工程(如 Keil MDK 默认编译设置、传统 STM32 固件)源码文件多采用 GB2312 或 GBK 编码存储字符串,固件运行时向串口输出的中文也是 GBK 编码(双字节表示一个汉字)。而现代 Python 3 默认环境普遍采用 UTF-8 编码(常见汉字占三字节)。如果上位机直接使用
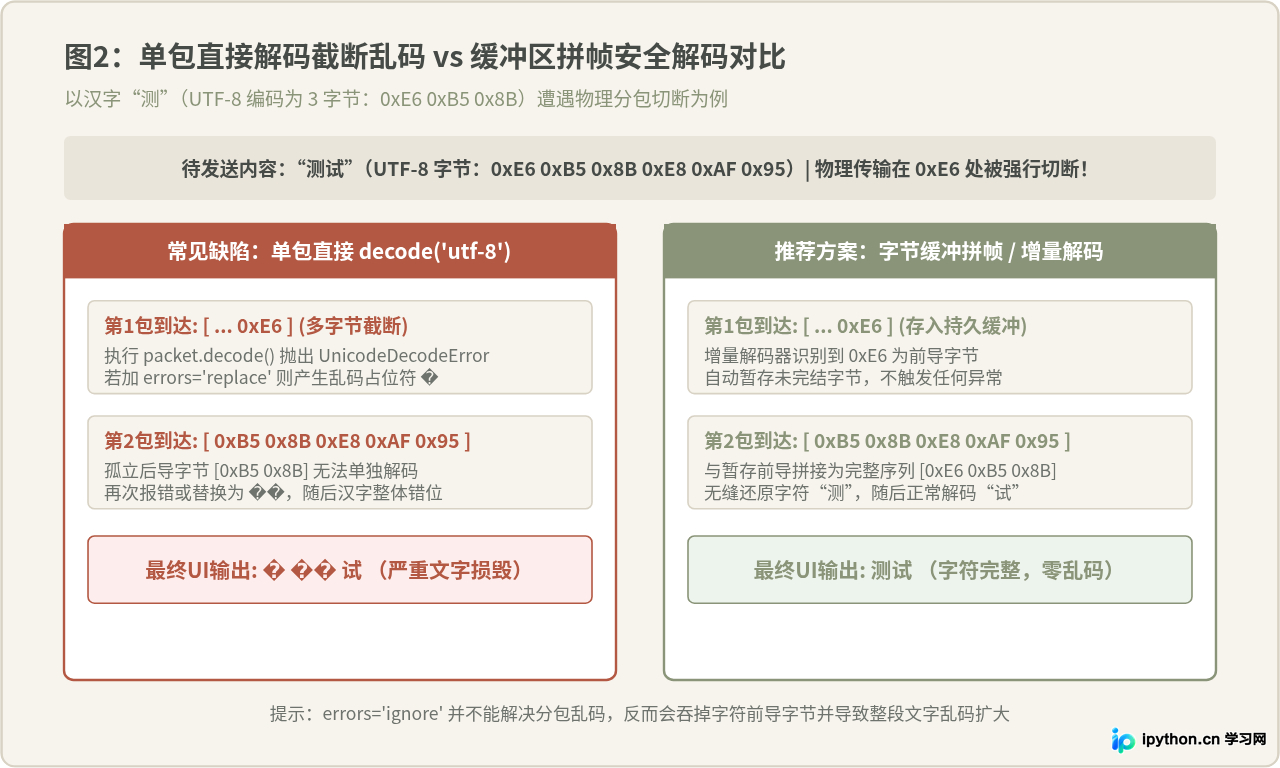
chunk.decode('utf-8')解码 GBK 字节,由于两者编码算法完全不同,必然触发UnicodeDecodeError。 - 3. 串口数据流分包截断(最隐蔽的核心根源): 这是导致偶发性乱码的最主要诱因。UART 传输是逐个字节进行的,操作系统的驱动根据读取间隔返回数据。一个标准的 UTF-8 汉字需要 3 个连续字节。若在多字节序列传输过程中恰好触发了一次读取切片,前 1 或 2 个字节进入第一包,剩余字节进入第二包。
errors='ignore' 不是解决乱码的正解?很多开发者遇到
UnicodeDecodeError 时,第一反应是在 decode() 中加上 errors='ignore'。在单次静态字符串转换时,它确实能忽略非法字节。但在流式传输中,如果第 1 包末尾的汉字前导字节 0xE6 被 ignore 静默吞掉,下一包送达的 0xB5 0x8B 就变成了失去前导的孤儿字节,同样会被作为无效编码抛弃。结果不仅该汉字丢失,还可能破坏后续字节的对齐,导致整句话多处文字缺失或错位。
五、基于增量解码与定界拼包的抗乱码实战方案
为了彻底消除串口接收过程中的偶发乱码与编码冲突,源码设计必须结合两大核心防御机制:
-
标准库增量解码器(Incremental Decoder):
Python
codecs模块提供了codecs.getincrementaldecoder('utf-8')()。该解码器具有状态记忆能力,当传入的数据包末尾包含不完整的多字节序列时,它会自动将悬挂字节保留在内部缓冲区,暂不输出,等待下一个数据包送达后自动合并解码。 -
字符编码自适应探测与回退机制:
由于无法预先确定接入的单片机是 UTF-8 还是 GBK/GB18030,接收器应优先尝试 UTF-8 严格解码;若在完整帧上触发解码异常,平滑降级至超集编码
GB18030。GB18030 完全向下兼容 GBK 和 GB2312,能覆盖绝大部分国内微控制器的输出。
以下是具备抗乱码、增量缓冲与回退功能的完整 Python 处理核心类:
import codecs
import serial

class RobustSerialReceiver:
    """
    高可用串口接收处理器:支持 HEX 模式与抗分包乱码增量文本模式
    """
    def __init__(self, port: str, baudrate: int = 115200, timeout: float = 0.05):
        self.ser = serial.Serial(port=port, baudrate=baudrate, timeout=timeout)
        # 初始化 UTF-8 增量解码器,保持跨分包的多字节字符上下文
        self.utf8_decoder = codecs.getincrementaldecoder('utf-8')()
        # 内部字节缓冲队列,用于换行拼帧或回退诊断
        self.buffer = bytearray()

    def read_stream(self, is_hex_mode: bool = False) -> str:
        """
        单次轮询读取。返回解码完成的字符串或格式化的十六进制文本。
        """
        # 1. 检查物理缓冲区是否有数据待读取
        in_waiting = self.ser.in_waiting
        if in_waiting <= 0:
            return ""

        # 读取全部就绪字节
        raw_chunk = self.ser.read(in_waiting)
        if not raw_chunk:
            return ""

        # 2. 十六进制模式:直接进行标准十六进制格式化
        if is_hex_mode:
            return raw_chunk.hex(' ').upper() + ' '

        # 3. 文本模式:使用增量解码器防御截断乱码
        try:
            # final=False 明确通知解码器当前处于数据流中,暂存未完成的前导字节
            decoded_text = self.utf8_decoder.decode(raw_chunk, final=False)
            return decoded_text
        except UnicodeDecodeError:
            # 4. 若 UTF-8 解码彻底不兼容(例如设备实为 GBK 编码输出)
            # 重置增量解码器状态,并将当前数据转为 GB18030 尝试平滑降级
            self.utf8_decoder.reset()
            try:
                return raw_chunk.decode('gb18030', errors='replace')
            except Exception:
                # 终极兜底:使用无损单字节编码 latin1 输出,防止抛出未捕获异常中断通信
                return raw_chunk.decode('latin1', errors='replace')

    def close(self):
        if self.ser and self.ser.is_open:
            self.ser.close()
六、总结与工程最佳实践对照
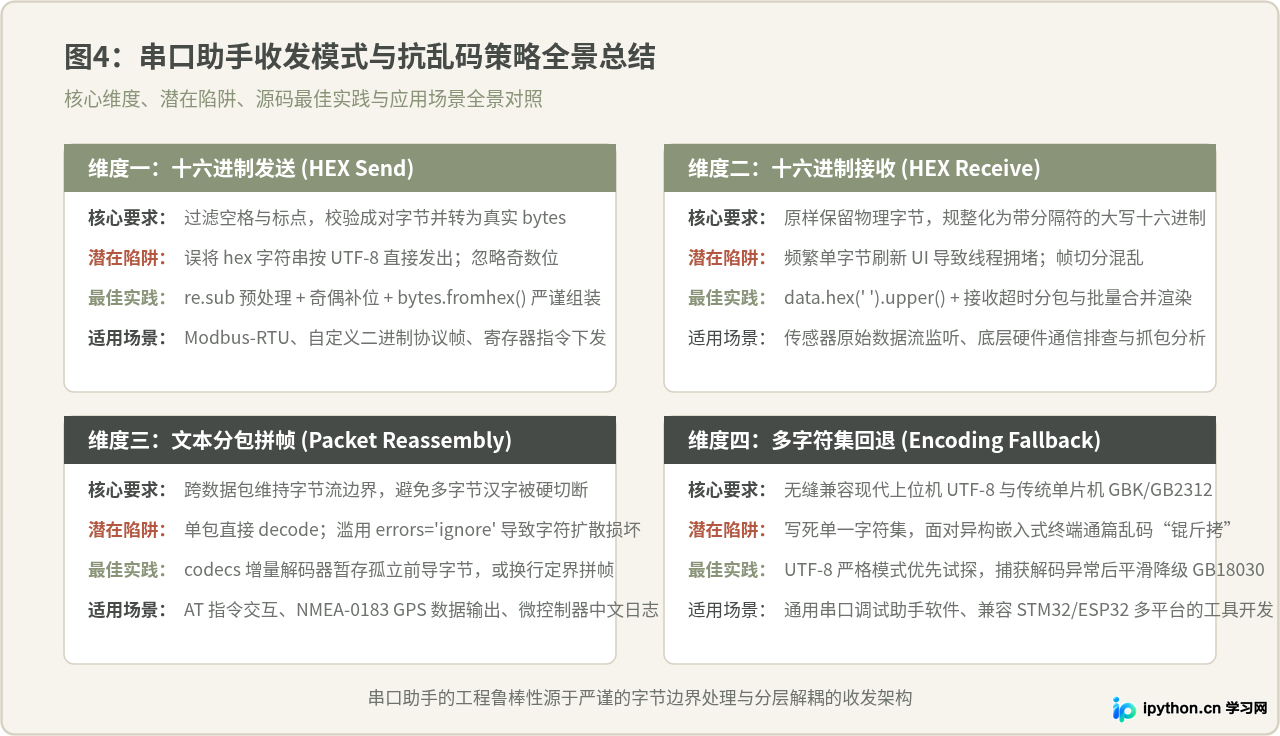
开发成熟的 Python 串口调试助手源码,关键在于时刻牢记底层数据流的无类型二进制本质。十六进制收发的本质是“格式清洗与二进制转换”,乱码防治的本质是“边界维护与编码自适应”。只要坚持在发送端做足奇偶与非十六进制字符清洗,在接收端采用增量解码与字符集回退机制,即可从源码架构层面杜绝绝大部分串口通信异常。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









