Python判断字符串只含字母:isalpha、正则与ASCII遍历对比
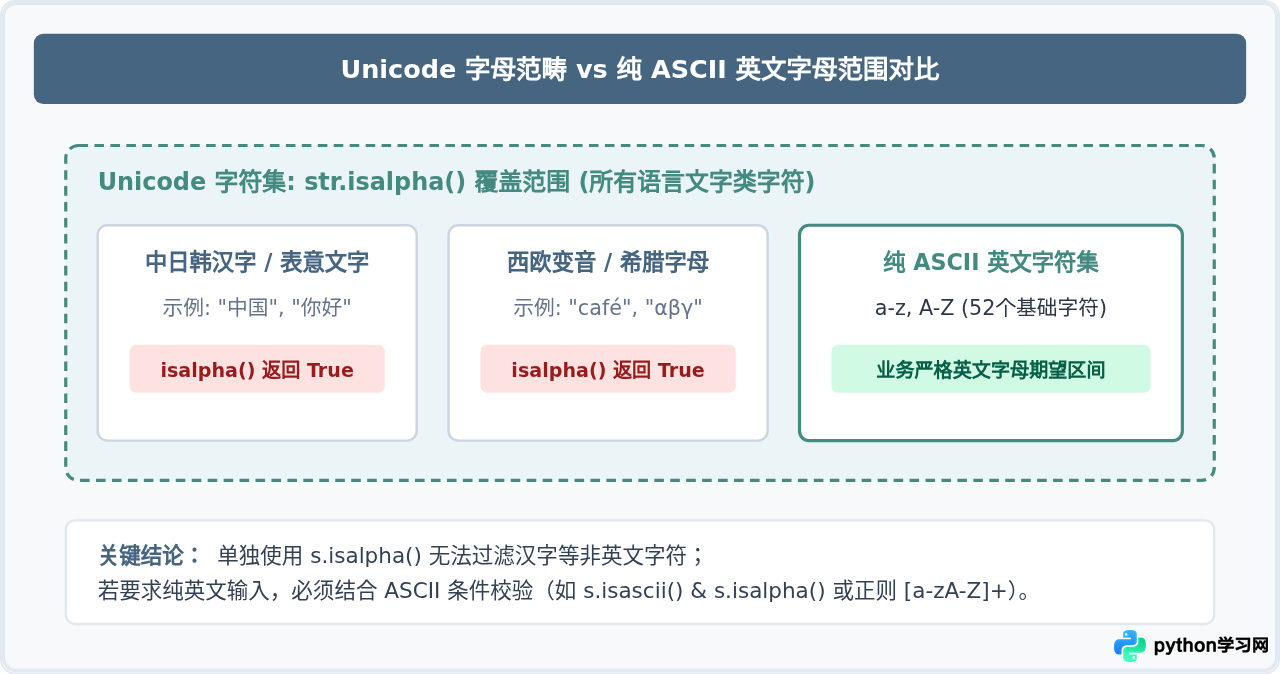
深入对比Python中判断字符串是否只含字母的三种核心方案:str.isalpha()、正则表达式与ASCII遍历,剖析Unicode与ASCII定义差异、空串陷阱及性能表现,提供清晰的选型指南与代码示例。
2026-10-22
33

深入对比Python中判断字符串是否只含字母的三种核心方案:str.isalpha()、正则表达式与ASCII遍历,剖析Unicode与ASCII定义差异、空串陷阱及性能表现,提供清晰的选型指南与代码示例。
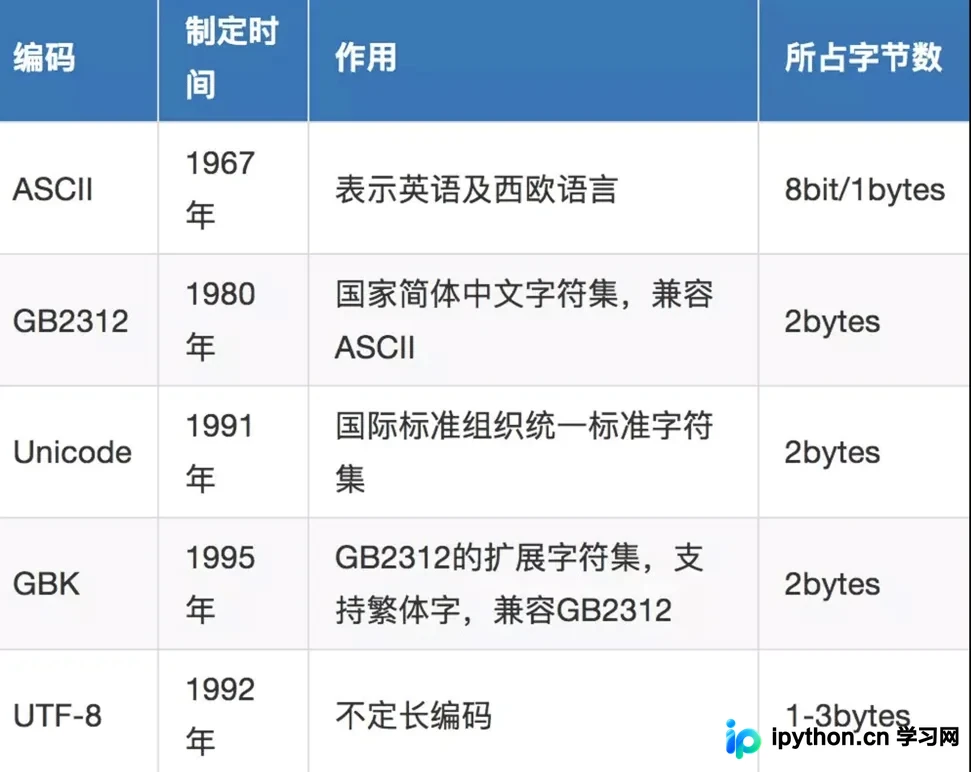
本文详细解析Python中常见的四种编码格式:ASCII、Unicode、UTF-8及GBK。从Python2默认ASCII到Python3默认UTF-8的演变出发,阐述各编码的字节占用、适用范围及存储效率差异,帮助开发者理解字符编码原理并解决乱码问题。
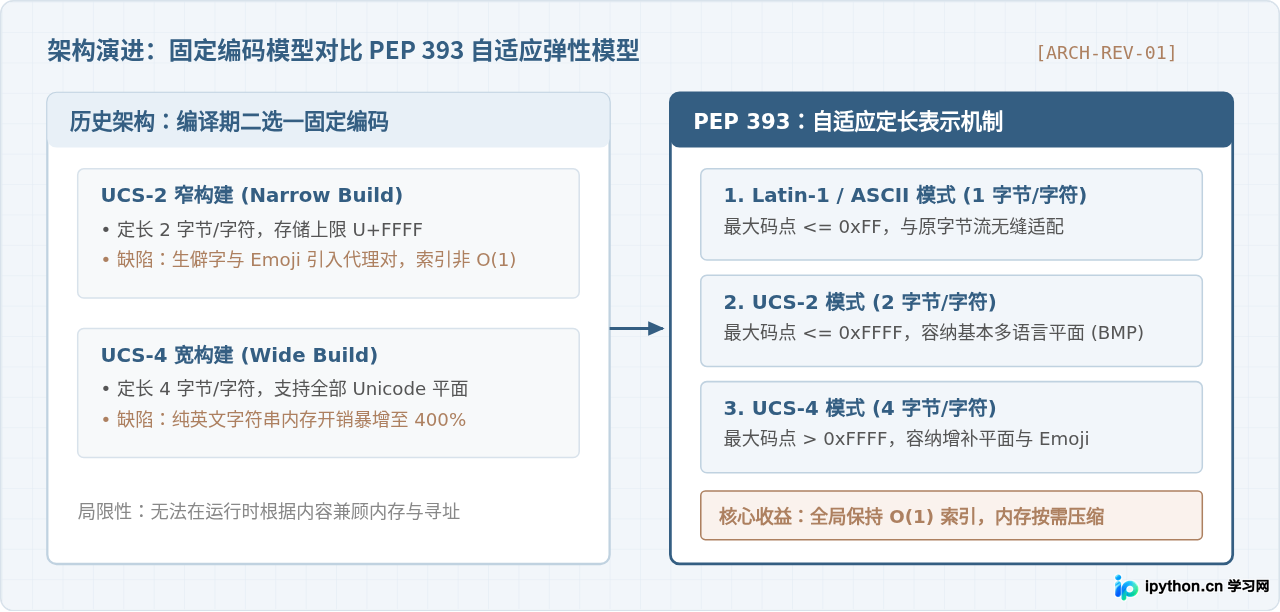
深入解析Python 3中PEP 393灵活字符串表示(Flexible String Representation)底层机制,详解ASCII、Latin-1、UCS-2与UCS-4四种存储形态的自适应切换、C结构体布局及内存优化原理。
本文详细解析C#中的字符串编码机制,重点讲解GB2312的区位码原理及汉字遍历方法。通过 BitConverter 和字节数组操作,演示如何生成指定汉字。同时阐述全角字符与半角 ASCII 的转换规律,解决 StreamReader 读取文本时的乱码问题,确保数据处理的准确性。
本文介绍如何利用Python的encode()和decode()函数实现ASCII码与中文字符的相互转换,以及Unicode编码字符串向UTF-8格式的转换。通过具体代码示例展示了使用unicode_escape编解码器的技巧,帮助开发者理解相关原理并解决实际的字符编码转换问题。
本文通过自动化脚本测试,详解PHP变量名的实际可用字符范围。发现PHP不仅支持常规的字母、数字和下划线,还扩展到了Latin-1字符集的高位字节(0x7F-0xFF),这是神盾等代码加密技术常用到的特性。文章提供了完整的测试代码及结果分析,帮助开发者理解非常规变量名的构成。
本文介绍如何在Python中将英文字母转换为对应的数字。核心方法是使用内置的ord()函数,该函数接收单个字符作为参数,返回其对应的ASCII或Unicode数值。文章详细说明了ord()函数的语法、参数及返回值,并通过示例展示了具体用法,同时提及了与chr()函数的对应关系。