

C#中字符串编码处理与GB2312全角字符生成

在C#开发中,正确处理字符串编码是避免乱码的关键。本文深入解析GB2312编码的结构,介绍基于区位码的汉字生成方法,并详细说明全角字符与半角ASCII的转换逻辑,帮助开发者掌握不同编码间的处理技巧。
理解GB2312编码结构
GB2312是简体中文系统的标准编码,其核心概念是“区位码”,由“区”和“位”组成。区代表大的范围,位相当于偏移量。每个汉字在GB2312中占用两个字节:
- 高位字节的范围是
0xB0到0xF7。 - 低位字节的范围是
0xA1到0xFE。
虽然汉字排列大致遵循拼音顺序,但并非简单的连续数值映射。例如,“啊”字作为GB2312中的第一个汉字,其区位码为 1601(对应十六进制 0xB0A1)。需要注意,虽然可以通过循环遍历区间来生成汉字,但不能简单地认为 0x11 到 0x99 就能覆盖所有字符。实际上,GB2312共包含6768个汉字。
使用代码生成GB2312汉字
由于C#运行环境通常使用小端字节序(Little-Endian),在操作字节时需特别注意顺序。以下代码展示了如何将字节序列转换为GB2312字符串:
// 示例:将ushort转换为字节数组并输出汉字
ushort u = 0xa1b0;
byte[] chs = BitConverter.GetBytes(u);
Console.Write(Encoding.GetEncoding("GB2312").GetString(chs));
上述代码执行后会在屏幕输出汉字“啊”。若要输出GB2312中的所有汉字,可以按区号和位号进行双重循环遍历:
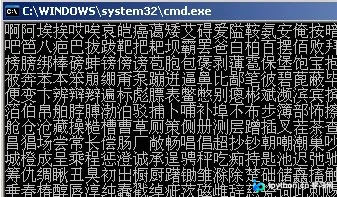
// GB2312汉字遍历
for (byte i = 0xB0; i <= 0xF7; i++)
{
     for (byte j = 0xA1; j <= 0xFE; j++)
     {
         Console.Write(Encoding.GetEncoding("GB2312").GetString(new byte[] { i, j }));
     }
}
全角字符与ASCII的关系
ASCII是美国信息交换标准码,范围从 0 到 127。在GB2312中,除了汉字,还包含了字母符号,分为全角和半角两种形式:
- 半角字符:直接使用ASCII码值。
- 全角字符:外观上占两个字节宽度,第一个字节固定为
163(即0xA3),第二个字节为半角字符码值加128。
例如,半角 A 的ASCII值为 65,对应的全角 A 的两个字节分别为 163 和 193(128 + 65)。基于此规律,可以使用以下代码遍历生成所有ASCII字符的全角版本:

// 生成ASCII对应的全角字符
for (byte k = 0x00; k < 0x7f; k++)
{
     byte[] ch = new byte[2];
     ch[0] = 163;
     ch[1] = (byte)(128 + k);
     Console.Write(Encoding.GetEncoding("GB2312").GetString(ch));
}
读取文本文件时的编码处理
在不同操作系统下,文本文件的默认保存编码有所不同。例如在Windows XP环境下,默认通常是ANSI编码。需要注意的是,ANSI编码是一个依赖于系统的概念:在简体中文系统下它代表GB2312,而在日文系统下则可能代表JIS等本地编码。
C#开发者在使用 StreamReader 读取文本时,最容易遇到的问题是文件内容与当前系统默认编码不一致导致的乱码。为了避免这种情况,建议在初始化时显式指定编码格式:
// 明确指定使用系统默认编码(ANSI/GB2312)
StreamReader sr = new StreamReader(Application.StartupPath + @"\config.txt", System.Text.Encoding.Default);
当文件编码已知为UTF-8或其他特定格式时,应将 System.Text.Encoding.Default 替换为相应的 Encoding.UTF8 或 Encoding.GetEncoding(...),以确保正确解码。
以上就是C#字符串编码处理与GB2312全角字符生成的详细内容,更多关于C#编码技术的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









