

Python字符串底层存储机制:ASCII与UCS4自适应原理

在 Python 3 中,所有字符串(str)在逻辑上都是 Unicode 序列,用户可以透明地索引和切片任意字符而无需关心多字节编码细节。为了兼顾 O(1) 的常数级随机访问性能与极佳的内存紧凑性,CPython 自 3.3 版本引入了 PEP 393(灵活字符串表示,Flexible String Representation)。本文将深入剖析 Python 字符串底层的自适应存储机制,从 ASCII、UCS-1、UCS-2 到 UCS-4 的演变路径、C 结构体布局,到运行时的形态检测与编码决策过程。
一、PEP 393 演进背景与设计目标
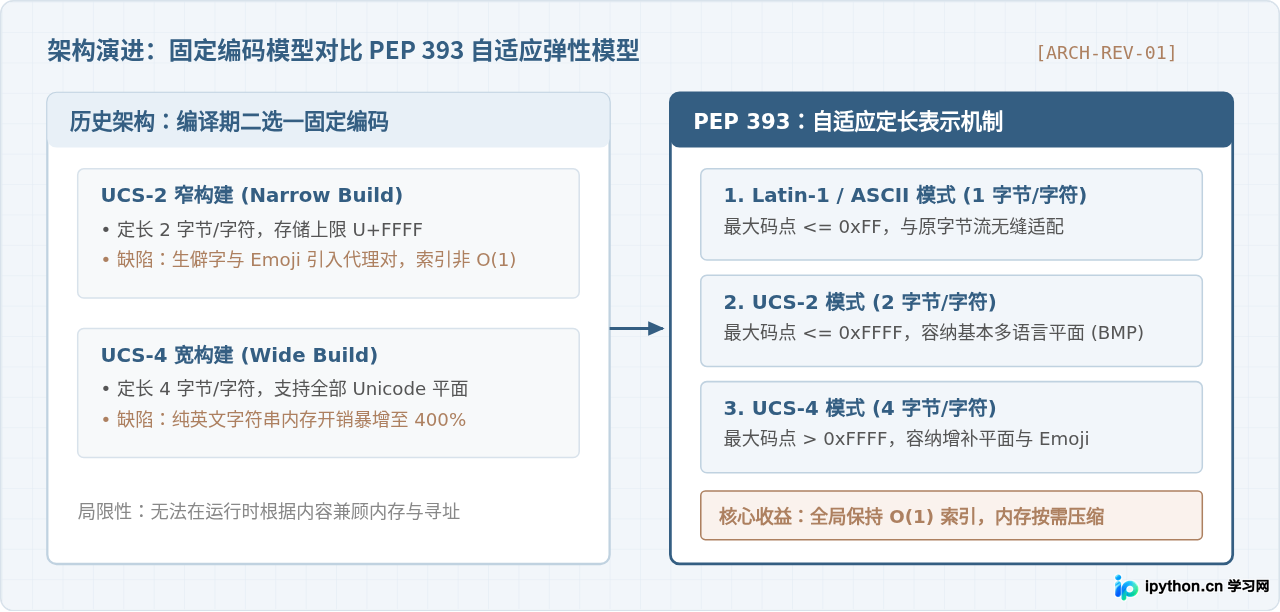
在 PEP 393 之前,CPython 在编译阶段必须二选一:构建为“窄构建”(Narrow Build,基于 UTF-16/UCS-2,每个字符占 2 字节)或“宽构建”(Wide Build,基于 UCS-4,每个字符占 4 字节)。窄构建无法高效处理码点超出 U+FFFF 的辅助平面字符,常需代理对(Surrogate Pairs),破坏了通过下标按字符直接定位的特性;宽构建虽然支持所有字符的常数级寻址,但会导致大量以纯 ASCII 字符构成的文本浪费高达 3 倍的内存空间。
PEP 393 确立的自适应机制彻底解决了该矛盾:字符串对象由内部机制根据其实际包含的最高码点(Max Char)动态决定全串统一定长表示,既保证了物理数组上的定长步长寻址,又实现了尽可能紧凑的内存占用。
二、底层 C 结构体与内存排布
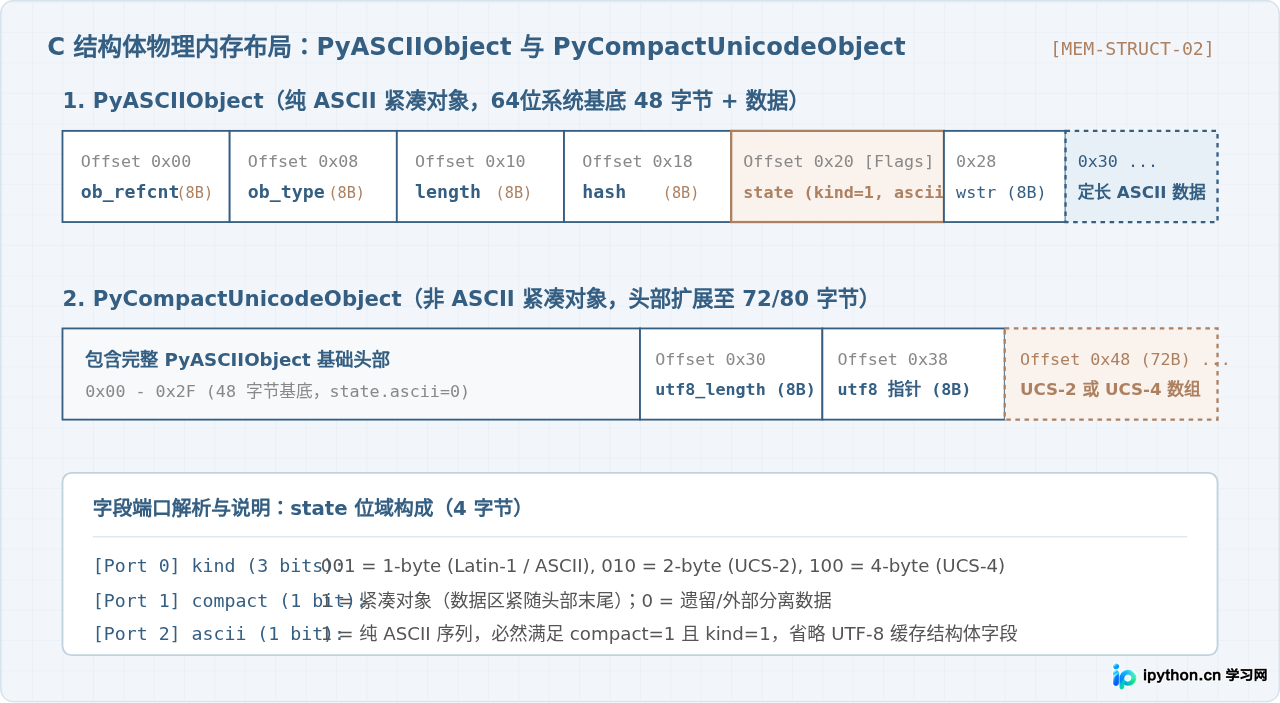
在 CPython 源码(Include/cpython/unicodeobject.h)中,str 对象的头部采用继承与内联变长数据结合的设计。结构体的形态可划分为四种状态,其共用核心标志位 state 记录具体物理存储规格:
- PyASCIIObject:专门存储纯 ASCII 字符串。纯 ASCII 字符串不需要存储 UTF-8 缓存指针,数据缓冲区紧随头部末尾连续分配。
- PyCompactUnicodeObject:存储非纯 ASCII 的紧凑字符串(Latin-1、UCS-2 或 UCS-4)。头部包含 UTF-8 数据的指针与长度,字符字符数组仍紧随其后。
- PyUnicodeObject:非紧凑遗留形态(支持外部缓冲引用或切片视图共享)。
三、自适应决策:从输入字符到物理形态的转换过程
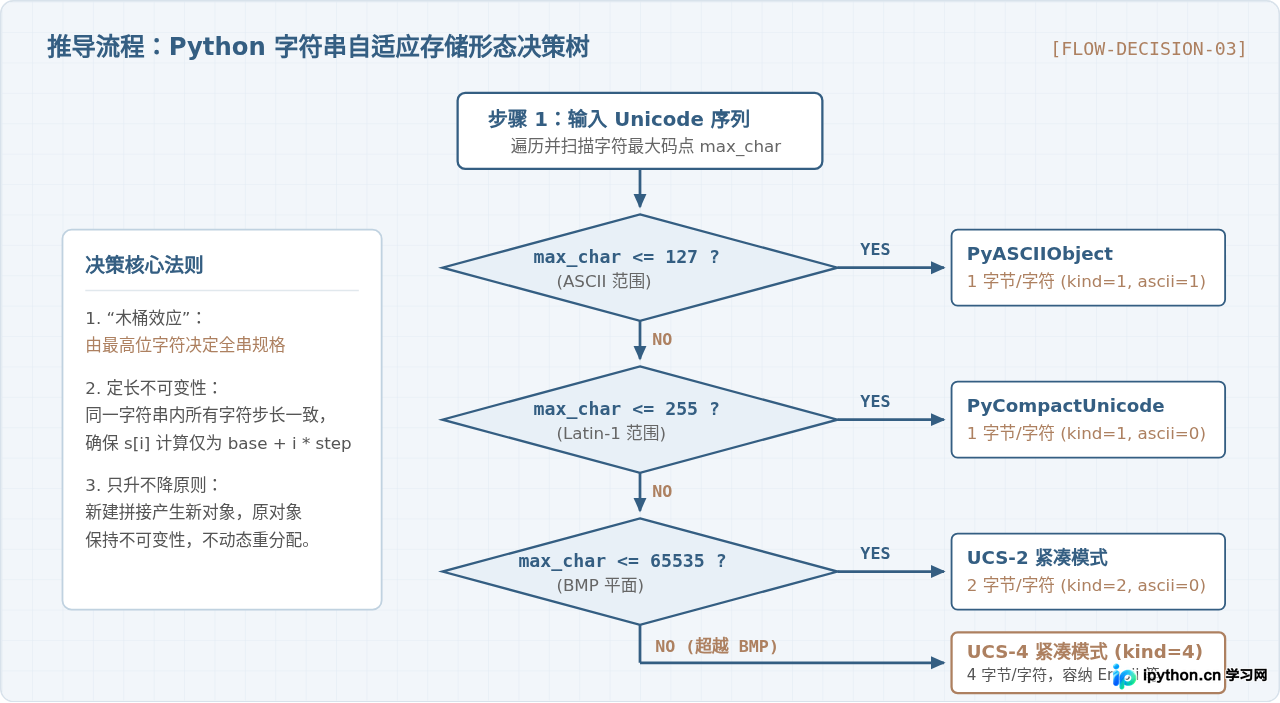
当 Python 构建一个新字符串时(例如通过字面量解析、拼接或编码解码),解释器如何确定物理分配规格?其核心逻辑遵循以下三步处理流程:
- 扫描最大码点(Max Char Detection):检查输入数据中所有字符的最大 Unicode 码点数值
max_char。 - 匹配物理类型枚举:
max_char <= 0x7F (127):判定为纯 ASCII。分配PyASCIIObject结构,kind = PyUnicode_1BYTE_KIND,字符定长步长为 1 字节。max_char <= 0xFF (255):判定为 Latin-1。分配PyCompactUnicodeObject,kind = PyUnicode_1BYTE_KIND,字符步长为 1 字节。max_char <= 0xFFFF (65535):判定为 UCS-2。分配PyCompactUnicodeObject,kind = PyUnicode_2BYTE_KIND,字符步长为 2 字节(涵盖常用中文汉字、日韩文字)。max_char > 0xFFFF:判定为 UCS-4。分配PyCompactUnicodeObject,kind = PyUnicode_4BYTE_KIND,字符步长为 4 字节(涵盖 Emoji 表情、古典汉字及数学特殊符号)。
- 一次性连续内存分配:根据计算好的字符步长
S与字符数量N,分配sizeof(Header) + S * (N + 1)字节的空间(额外 1 个字符位用于末尾的\0空终止符,以保持与 C 库函数兼容)。
四、代码实测:验证字符串底层内存大小
我们可以利用 Python 标准库的 sys.getsizeof() 函数,在 64 位 CPython 解释器中实际验证上述机制与内存开销。
import sys

# 1. 纯 ASCII 字符串
s_ascii = "a" * 10
# 基础头部: 48 字节, 数据: 10 * 1 字节, 末尾 \0: 1 字节 => 48 + 10 + 1 = 59 字节
print("ASCII 10 字符大小:", sys.getsizeof(s_ascii))

# 2. 含有非 ASCII 的 Latin-1 字符 (如 U+00E9 即 é)
s_latin1 = "é" * 10
# 紧凑头部: 72 字节 (64位), 数据: 10 * 1 字节, 末尾 \0: 1 字节 => 72 + 10 + 1 = 83 字节 (或依据编译器对齐至 84/88)
print("Latin-1 10 字符大小:", sys.getsizeof(s_latin1))

# 3. 包含中文常用字符 (BMP 平面, 码点 <= 0xFFFF)
s_ucs2 = "中" * 10
# 紧凑头部: 72 字节, 数据: 10 * 2 字节, 末尾 \0: 2 字节 => 72 + 20 + 2 = 94 字节
print("UCS-2 10 字符大小:", sys.getsizeof(s_ucs2))

# 4. 包含 Emoji (码点 > 0xFFFF)
s_ucs4 = "🐍" * 10
# 紧凑头部: 72 字节, 数据: 10 * 4 字节, 末尾 \0: 4 字节 => 72 + 40 + 4 = 116 字节
print("UCS-4 10 字符大小:", sys.getsizeof(s_ucs4))
如果在长度为 10000 的纯 ASCII 文本中插入了一个 Emoji(例如
s = "a" * 10000 + "🎉"),整个字符串对象都会被提升至 UCS-4 模式。此时前 10000 个原先只需 1 字节的 ASCII 字符,其在底层缓冲区中也全部按 4 字节(高位补零)对齐存储,总体内存占用会瞬间从约 10KB 膨胀至 40KB。
五、性能与内存特性全景对比总结
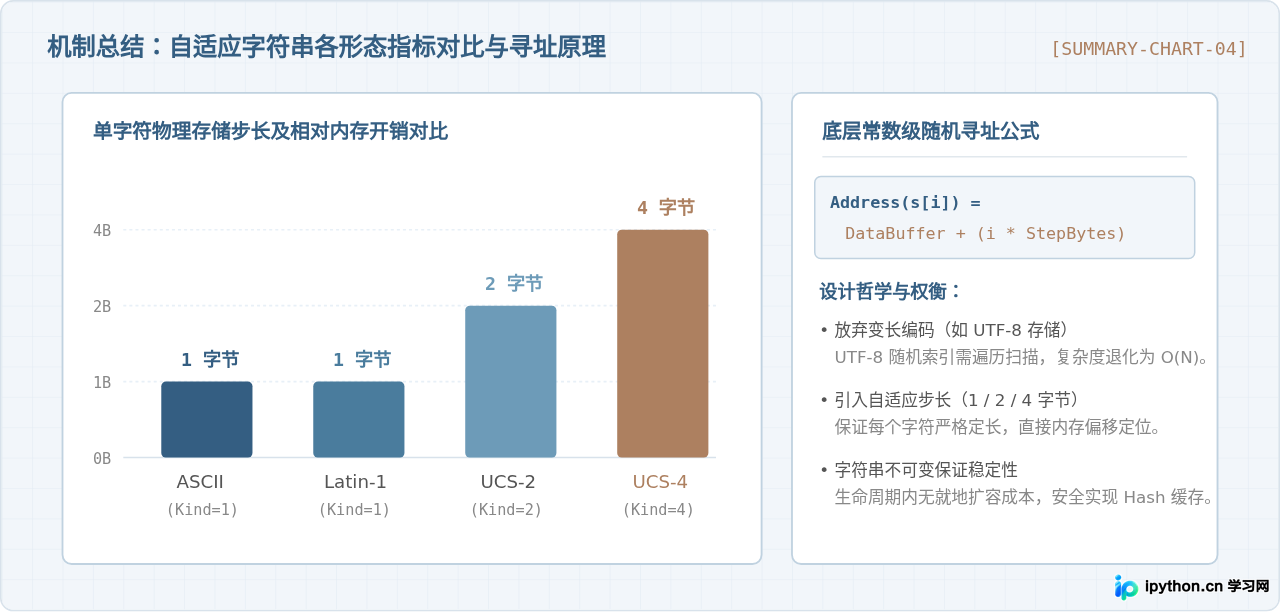
| 形态类别 | 适用最高码点范围 | 单字符字节开销 | 底层 C 结构体 | 索引复杂度 | 代表性字符 |
|---|---|---|---|---|---|
| ASCII | 0x00 - 0x7F (0 - 127) |
1 字节 | PyASCIIObject |
O(1) |
a, z, 0, 9, @ |
| Latin-1 | 0x80 - 0xFF (128 - 255) |
1 字节 | PyCompactUnicodeObject |
O(1) |
é, ñ, ü, © |
| UCS-2 | 0x0100 - 0xFFFF (256 - 65535) |
2 字节 | PyCompactUnicodeObject |
O(1) |
中, 文, あ, Ω |
| UCS-4 | 0x10000 - 0x10FFFF |
4 字节 | PyCompactUnicodeObject |
O(1) |
😀, 🚀, 𠮷 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









