Python实现李航《统计学习方法》感知机算法详解
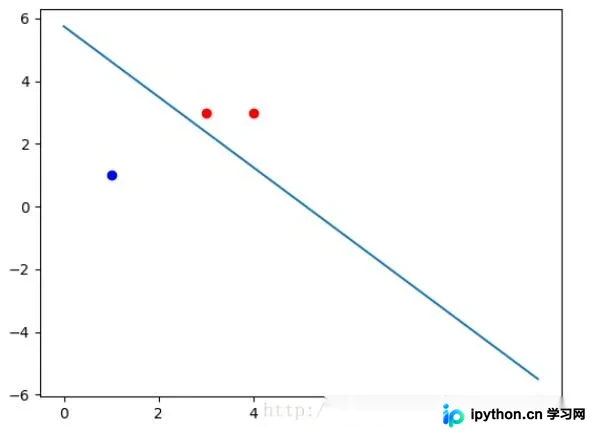
本文通过Python代码演示李航《统计学习方法》中感知机算法的具体实现。以正例(3,3)、(4,3)和负例(1,1)为例,展示数据可视化及模型训练过程。代码使用NumPy进行向量运算,通过迭代更新权重w和偏置b,最终绘制决策边界,帮助读者理解感知机工作原理。
2026-10-13
6

本文通过Python代码演示李航《统计学习方法》中感知机算法的具体实现。以正例(3,3)、(4,3)和负例(1,1)为例,展示数据可视化及模型训练过程。代码使用NumPy进行向量运算,通过迭代更新权重w和偏置b,最终绘制决策边界,帮助读者理解感知机工作原理。
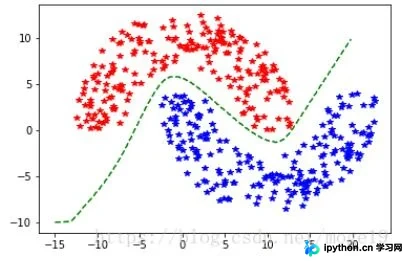
本文详细解析了使用Python实现多层感知器(MLP)处理双月数据集的完整过程。内容涵盖从生成非线性可分的双月数据、定义Sigmoid激活函数,到构建包含输入层、隐藏层和输出层的BP神经网络模型。通过反向传播算法优化权重,最终可视化展示决策边界与分类结果,为理解基础神经网络原理提供直观代码示例。
本文详细解析了PHP中利用header函数实现页面跳转的几种常用方法,包括立即跳转与延迟提示跳转。文章指出了执行header函数时可能遇到的输出前置问题,并提供了封装好的通用跳转函数代码,帮助开发者规避常见错误,确保跳转逻辑稳定运行。
本文梳理Java开发者必经的五个学习阶段:掌握Java语法、面向对象及IO等多线程基础;熟悉MySQL等主流数据库操作;夯实HTML/CSS前端基础;理解Servlet、JSP及MVC模式的Web开发核心;最后深入Struts、Hibernate和Spring等企业级框架。此路线旨在帮助初学者构建扎实的技术栈,逐步胜任实际项目需求。
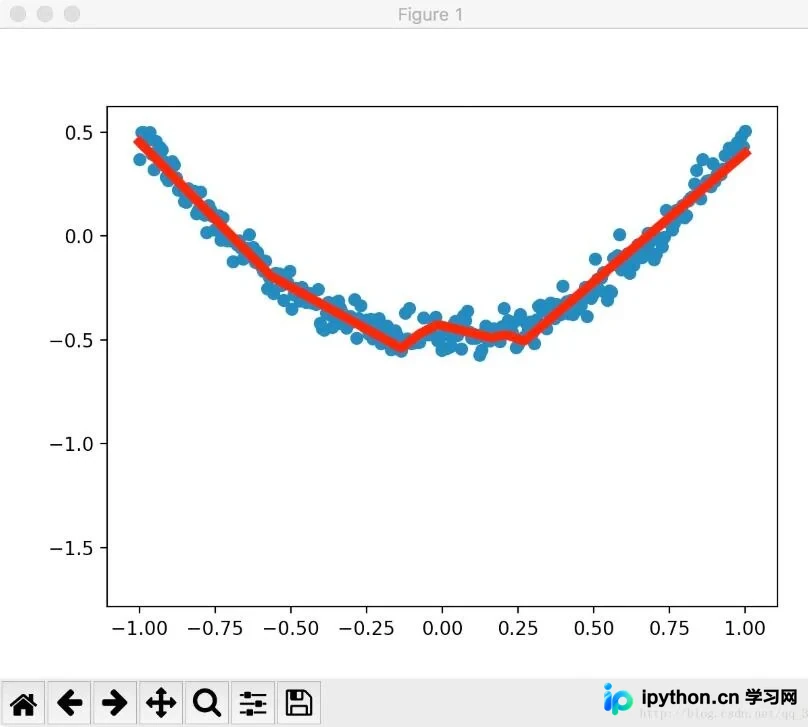
本文介绍如何使用Python的Matplotlib库对TensorFlow模型训练过程中的数据进行可视化分析。通过动态绘图展示预测结果与真实数据的对比,帮助开发者直观监控模型优化过程。文中包含关键代码示例及注意事项,如变量初始化方法的更新,为AI初学者提供实用的调试与展示技巧。
本文深入解析Java中对象克隆clone()方法与普通赋值引用的核心区别。通过Student类示例演示如何实现Cloneable接口并重写clone方法,对比直接赋值修改属性对原对象的影响与独立克隆对象的隔离性。重点讲解Object类的finalize、clone机制及标记接口的作用,帮助开发者避免共享状态导致的意外修改问题。
本文详细介绍Python中NumPy库的基础应用,涵盖数组创建、维度转换(ndim/shape)、等差/等比数列生成及初始化方法。作为深度学习的核心计算库,掌握NumPy是理解TensorFlow等框架中张量概念的关键,适合AI初学者入门学习。
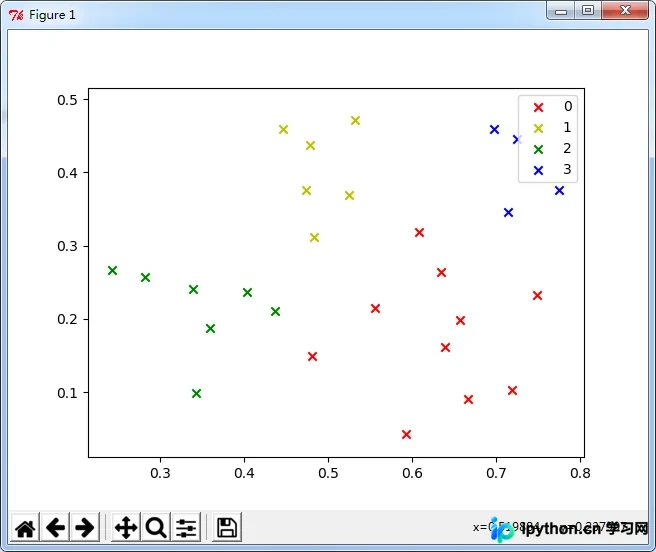
本文详细介绍Python中DBSCAN密度聚类算法的实现原理与操作步骤。涵盖ε-邻域、核心对象、密度直达与可达等核心概念,并提供完整的Python代码示例及运行结果图,帮助开发者快速掌握基于密度的聚类方法。
本文介绍了一种使用Python实现的基于信息增益的决策树归纳方法。通过加载属性、训练数据和类别描述文件,构建决策树节点并进行分类测试。代码展示了如何计算信息增益以选择最优分裂属性,并评估分类器的准确率。适合对机器学习和决策树算法感兴趣的开发者参考。
本文介绍在Python中如何对图像数据集及其对应标签进行同步随机打乱。通过读取训练路径下的图片文件和标签CSV,利用numpy的permutation生成索引序列,确保图片顺序与标签顺序一致。示例代码展示了使用skimage处理图像尺寸及保存打乱后数据的过程,适用于机器学习模型训练前的数据准备阶段。
本文详细解析Python中决策树算法的实现过程。从数据集的列表存储结构入手,讲解决策树节点类的构建与数据拆分逻辑。重点阐述如何利用基尼不纯度或信息熵评估分裂质量,并通过加权平均处理缺失数据分类。最后介绍基于最小信息增益的剪枝策略,以优化模型泛化能力,提供从理论到代码的完整实现参考。
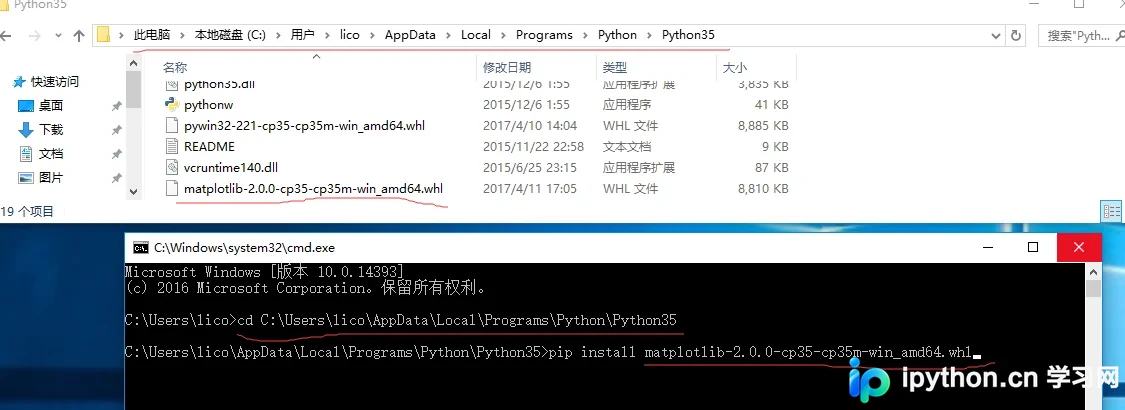
本文详细记录了在 Windows 10 系统中配置 Python 3.5.1 环境,并依次安装 easy_install、pip 以及 TensorFlow 和 Matplotlib 的全过程。内容涵盖环境变量配置、依赖组件处理及常见报错解决方案,旨在帮助初学者顺利搭建深度学习基础开发环境。