

Python实现K近邻算法:基于KD树的优化搜索
本文详细解析K近邻算法的核心要素,包括k值选择、距离度量及分类决策规则。重点介绍利用KD树优化训练数据搜索效率的方法,涵盖KD树的构建原理、递归构造算法以及最近邻和K近邻搜索的具体实现。通过Python代码示例,展示了从数据预处理、KD树构建到预测结果输出的完整流程,帮助读者理解并掌握这一经典分类算法的高效实现。
2026-10-13
6

本文详细解析K近邻算法的核心要素,包括k值选择、距离度量及分类决策规则。重点介绍利用KD树优化训练数据搜索效率的方法,涵盖KD树的构建原理、递归构造算法以及最近邻和K近邻搜索的具体实现。通过Python代码示例,展示了从数据预处理、KD树构建到预测结果输出的完整流程,帮助读者理解并掌握这一经典分类算法的高效实现。
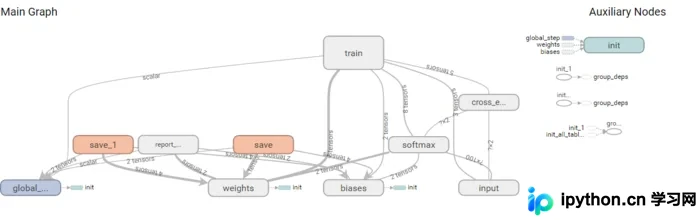
本文详细展示了如何使用TensorFlow实现线性支持向量机(SVM)。内容涵盖基础变量定义与损失函数构建、面向对象类的封装实现,以及无需外部数据文件即可运行的随机数据集生成方案。通过完整代码示例,帮助开发者理解线性SVM在TensorFlow中的核心逻辑与可视化方法。
本文通过Python代码演示梯度下降法在单变量线性回归中的应用。文章解释了损失函数的定义、对参数求导的过程以及迭代更新公式,并结合具体样本数据展示如何求解最优斜率k。适合希望直观理解梯度下降原理的初学者参考。
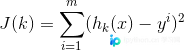
本文介绍了在C#开发中将手机号码中间四位数字替换为星号(如138****1234)的两种常用实现方式。通过对比正则表达式和字符串截取替换法,展示了代码示例及逻辑解析,帮助开发者在数据安全与隐私保护场景下快速集成相关功能。
本文详细解析使用TensorFlow进行文本分类的完整流程。从数据预处理、One-Hot编码,到构建包含隐藏层的神经网络,深入讲解RELU与Softmax激活函数的选择依据及偏置项作用。通过具体代码示例,展示如何设置训练参数、计算交叉熵误差并使用Adam优化器进行梯度下降,最终实现高准确率的文本分类模型。
本文解析 PHP 面向对象编程中 `$this` 关键字的核心作用与使用场景。通过购物车类的实际代码示例,说明如何借助 `$this` 在类方法内部访问当前对象属性和调用其他方法。文章重点阐述 `$this` 代表“当前对象”的语义,并对比 `self` 与父类调用的差异,帮助开发者理解对象内部状态维护的机制。
本文介绍在TensorFlow中如何正确更改变量的值。核心方法是使用tf.assign()创建更新操作,并必须在Session中通过run()执行该操作才能在图中生效。直接对Python变量赋值无效,且若传入非Tensor类型会导致AttributeError。
本文介绍TensorFlow中创建常量张量及生成随机数张量的核心函数。详细解析tf.constant的赋值与形状指定,以及random_normal、truncated_normal和random_uniform在正态分布、截断正态分布和均匀分布中的参数设置与应用场景,帮助开发者掌握基础数据初始化方法。
本文介绍TensorFlow中占位符placeholder的作用及feed_dict的数据馈送机制。通过解析参数定义、数据类型、形状设置及名称规范,结合字符串、数值及矩阵运算实例,展示如何高效构建计算图并避免节点冗余,适用于神经网络训练场景。
本文详解 PHP 8 JIT(即时编译器)的工作原理,包括如何识别热代码路径、生成机器码及缓存机制。提供通过 php.ini 配置 tracing 模式和缓冲区大小的具体步骤,并介绍如何利用严格类型和纯函数编写 JIT 友好代码以提升 CPU 密集型任务的性能。
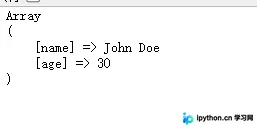
本文详解两种在PHP中将XML数据转换为关联数组的主流方法。方法一利用simplexml_load_string结合json_decode实现快速转换;方法二通过DOMDocument遍历节点,适用于复杂结构处理。附带处理CDATA及外部实体加载的安全建议。
本文总结了PHP中常用的数据格式与类型判断方法,涵盖基本类型(字符串、数字、布尔值)、复杂结构(数组、对象)及特定格式(日期、邮箱、URL、IP、手机号、身份证、JSON、XML等)。通过实际代码示例,详细解析了strlen、empty、is_*系列函数以及filter_var、preg_match等验证技巧,帮助开发者在数据处理前准确校验输入合法性。