Python爬取豆瓣Top250电影数据完整教程
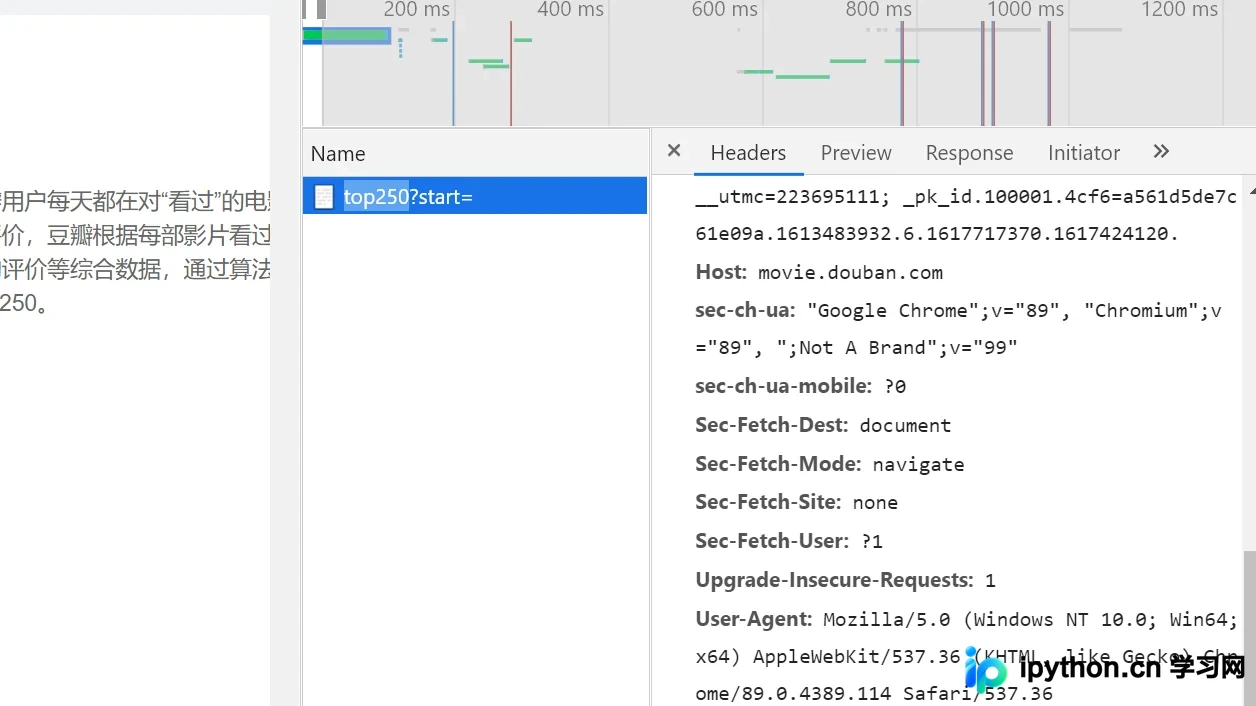
本文详细介绍如何使用Python爬取豆瓣电影Top250数据。通过urllib.request获取HTML源码,利用BeautifulSoup和正则表达式解析电影名称、评分及链接,最后使用xlwt库将结果保存为Excel文件。教程涵盖反爬处理、分页逻辑及数据清洗,适合Python初学者学习网络爬虫基础。
2026-10-15
25

本文详细介绍如何使用Python爬取豆瓣电影Top250数据。通过urllib.request获取HTML源码,利用BeautifulSoup和正则表达式解析电影名称、评分及链接,最后使用xlwt库将结果保存为Excel文件。教程涵盖反爬处理、分页逻辑及数据清洗,适合Python初学者学习网络爬虫基础。
本文详解如何在主流浏览器中调试JavaScript代码。通过F12打开开发者工具,利用Script面板设置断点、使用F9/F10/F11快捷键逐行追踪变量状态;同时在代码中插入`debugger;`语句,实现自动触发断点并跳转至VS等IDE进行深度分析,解决复杂逻辑排查难题。
本文讲解 PHP 在异步或并发调用中因未指定输出编码导致的“错误 c00ce56e”的成因与解决方法。只需在执行处添加 header('content-type:text/html; charset=UTF-8') 即可明确字符集,有效避免此项操作无法完成的异常。
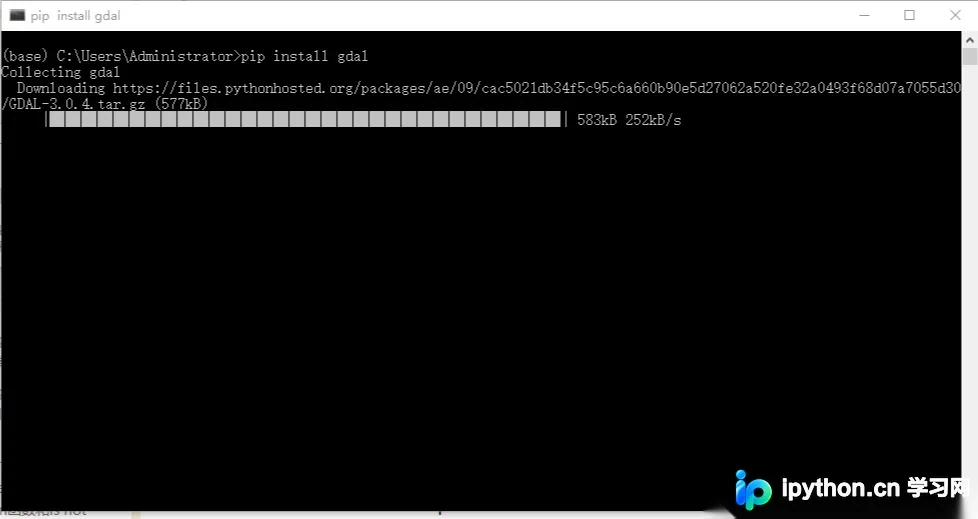
本文详细介绍在 Python Anaconda3 环境中安装 GDAL 库的三种常用方法。首先尝试直接使用 pip 或 conda 命令在线安装;若失败,则通过 Anaconda Prompt 查询 Python 版本,匹配对应版本的 GDAL whl 文件进行离线安装。文章涵盖版本匹配规则、安装命令及验证步骤,帮助用户解决依赖冲突问题。
本文介绍如何在 C# 中调用 Windows API SetCursorPos 函数移动鼠标光标到指定屏幕坐标。包含 P/Invoke 声明示例、参数说明及 ClipCursor 区域限制的处理机制,帮助开发者实现自动化界面操作或游戏辅助工具中的鼠标定位功能。
本文介绍四个Python自动化实用案例:利用PyAutoGUI模拟鼠标移动保持在线状态,使用Selenium实现网站自动登录,通过zipfile模块自动打包备份文件,以及结合PRAW库将YouTube视频自动发布至Reddit。涵盖环境配置、核心代码逻辑及关键参数说明,帮助开发者简化重复性工作流程。
本文介绍两种常用的 JavaScript 数组去重方法。第一种利用 for 循环结合 indexOf 检查元素是否已存在于新数组,保留原始顺序;第二种先对原数组进行排序,再比较相邻元素去除重复项。两者均通过修改 Array 原型链实现,适用于理解基础算法逻辑。
本文面向具备编程基础的开发者,简明梳理PHP核心基础知识。涵盖环境配置要点、基础语法标记、变量与常量命名规则、三类数组操作、常用运算符、条件与循环结构,以及函数与类的面向对象基础用法,帮助快速建立PHP代码结构认知。
本文详细介绍Python调用JavaScript代码的四种常用方式。通过PyExecJS利用本地JS环境执行,js2py实现纯Python解释器转换,Node.js命令直接调用,以及PyV8封装Chrome V8引擎。文章对比了各方案的优缺点及适用场景,适用于Web爬虫参数加密逆向等实际需求。
本文梳理了原生JavaScript中查找HTML元素的四种核心方法:通过ID精确获取、通过标签名批量检索、通过Name属性查找表单,以及为兼容旧浏览器封装的getByClass辅助函数。掌握这些基础API是进行DOM交互开发的关键。
本文详细解析MySQL中FOUND_ROWS()与ROW_COUNT()函数的区别。前者用于SELECT查询匹配的行数,后者针对UPDATE/DELETE操作。关键误区在于:若UPDATE前后值未变,ROW_COUNT返回0,这与Oracle行为不同。通过代码示例说明其实际计数逻辑及注意事项。
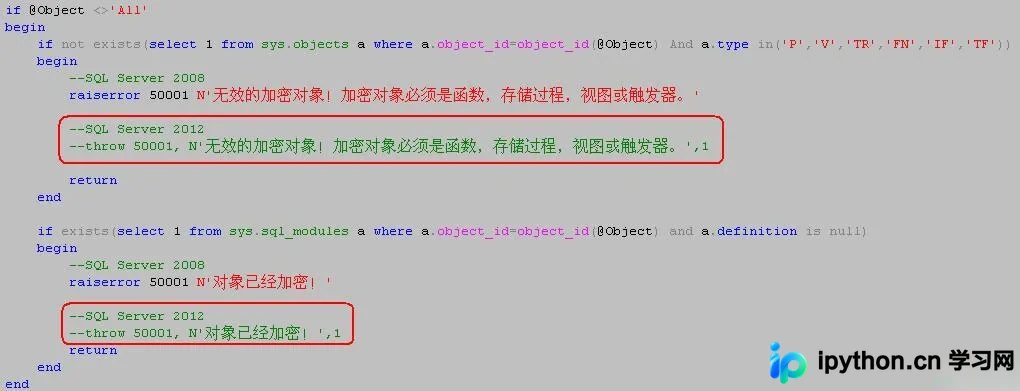
本文深入解析SQL Server存储过程加密(WITH ENCRYPTION)与解密机制,提供完整的自动加密和解密存储过程源码。详细演示如何通过查询sys.sysobjvalues表结合异或运算还原代码,并说明使用DAC(专用管理员连接)执行解密的必要步骤及测试环境搭建方法。