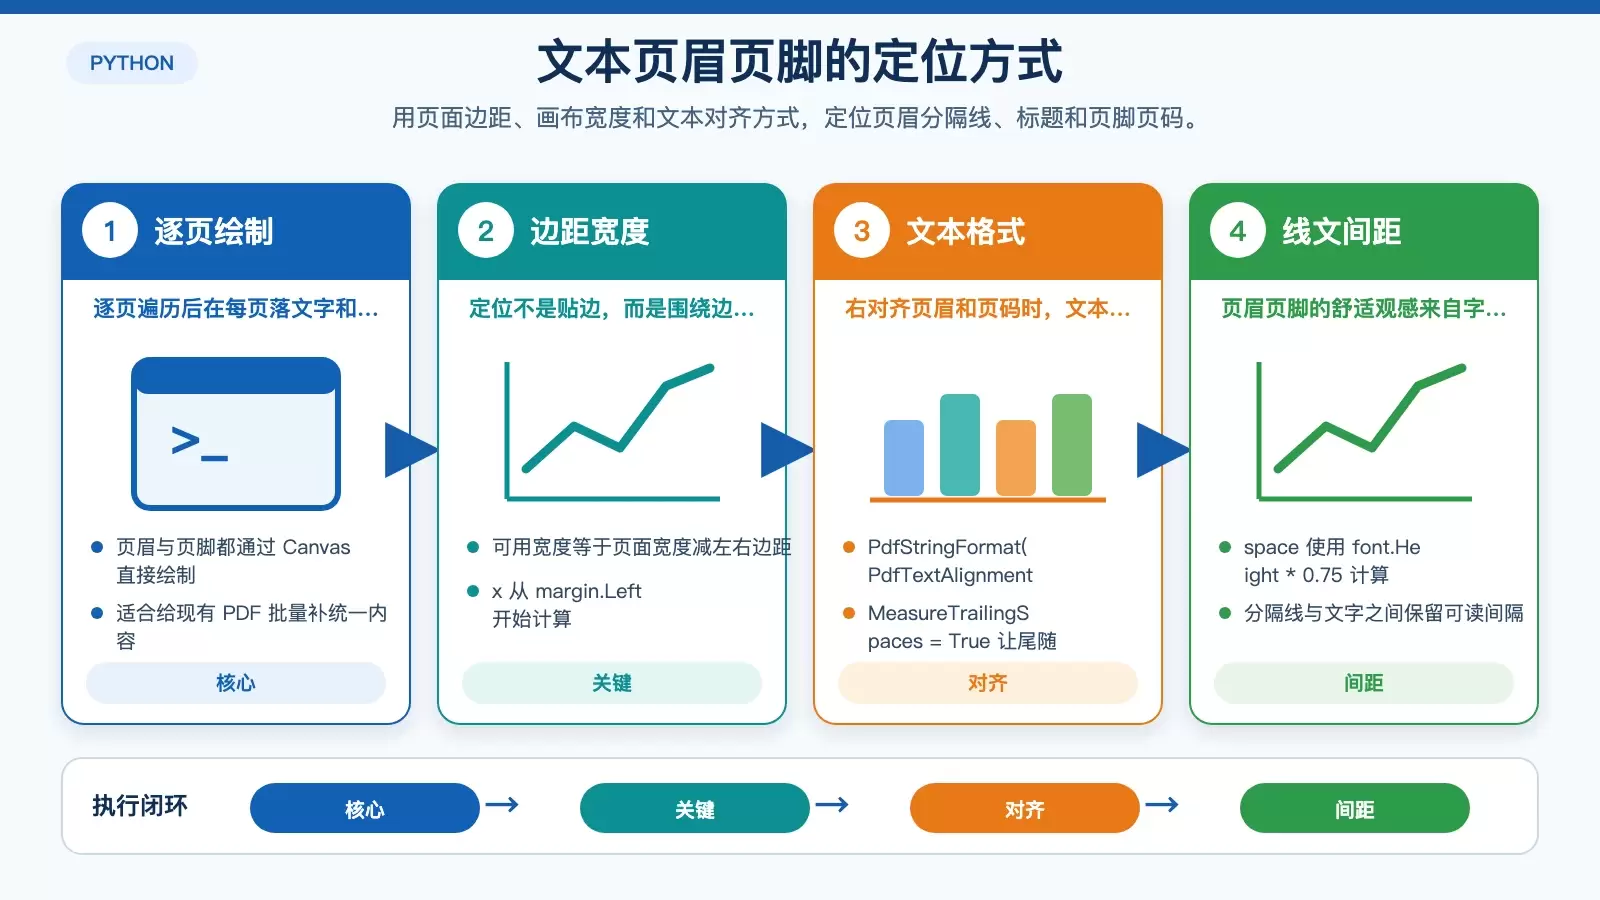
使用 Python 为 PDF 添加文本页眉和页脚
本文用 Spire.PDF 梳理 Python 给 PDF 添加页眉页脚的几种常见做法,包括逐页绘制文本、插入 Logo、按页面定制不同页眉,以及用页面模板自动生成页码。重点保留坐标、字体、模板和自动字段这些实现细节,方便你判断哪种方式更适合批量生成或正式文档场景。
2026-08-22
90

本文用 Spire.PDF 梳理 Python 给 PDF 添加页眉页脚的几种常见做法,包括逐页绘制文本、插入 Logo、按页面定制不同页眉,以及用页面模板自动生成页码。重点保留坐标、字体、模板和自动字段这些实现细节,方便你判断哪种方式更适合批量生成或正式文档场景。
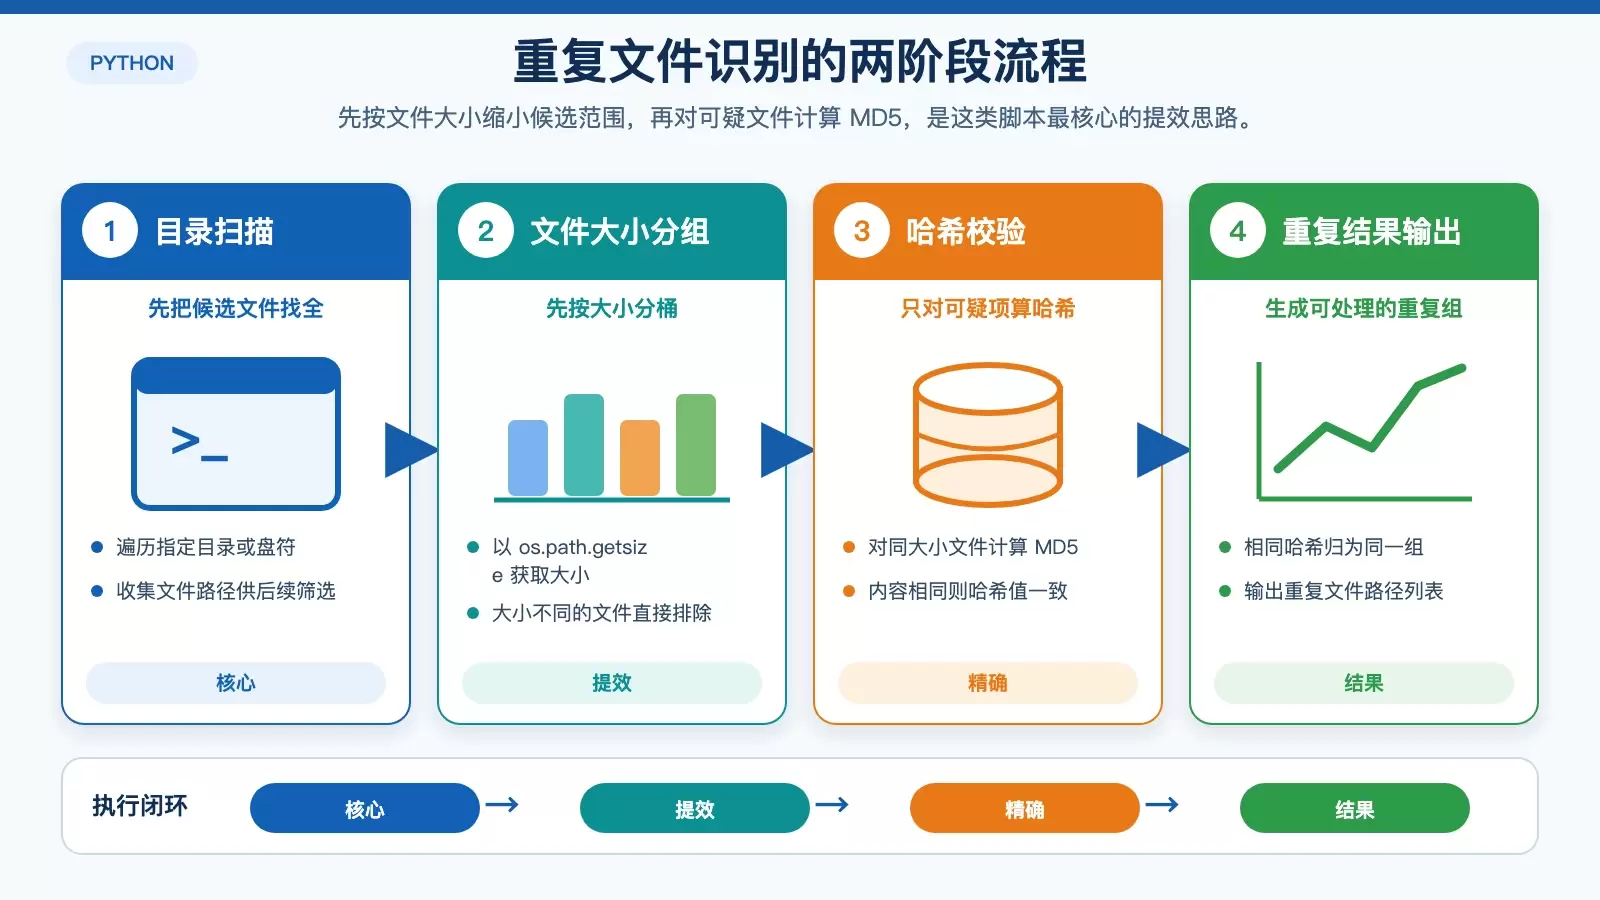
这篇文章用 Python 搭一个重复文件清理工具,核心思路是“先按文件大小筛选,再用 MD5 精确比对”。文中保留关键脚本与优化方法,并补充删除策略、权限处理、性能调优和 GUI 扩展,方便按实际场景落地。
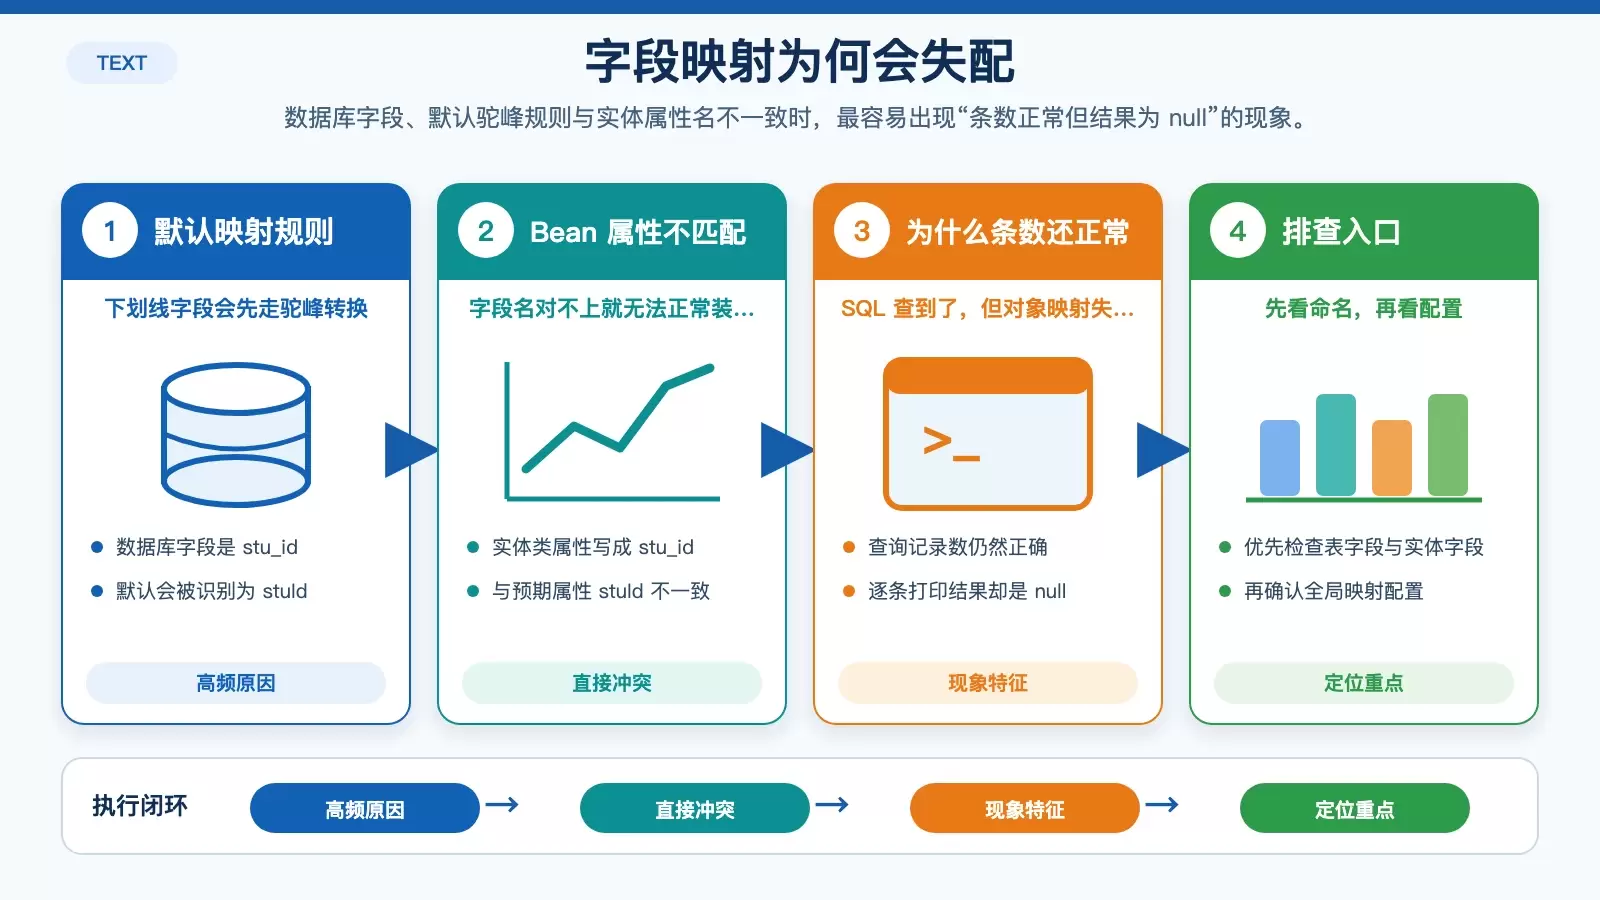
MyBatis-Plus 查询结果“条数正确但每项都是 null”,通常不是 SQL 没查到,而是结果映射阶段出了问题。最常见的原因是下划线字段与默认驼峰映射冲突,其次还要检查 Bean 的 setter、Lombok 生效情况,以及是否需要关闭 `map-underscore-to-camel-case`。
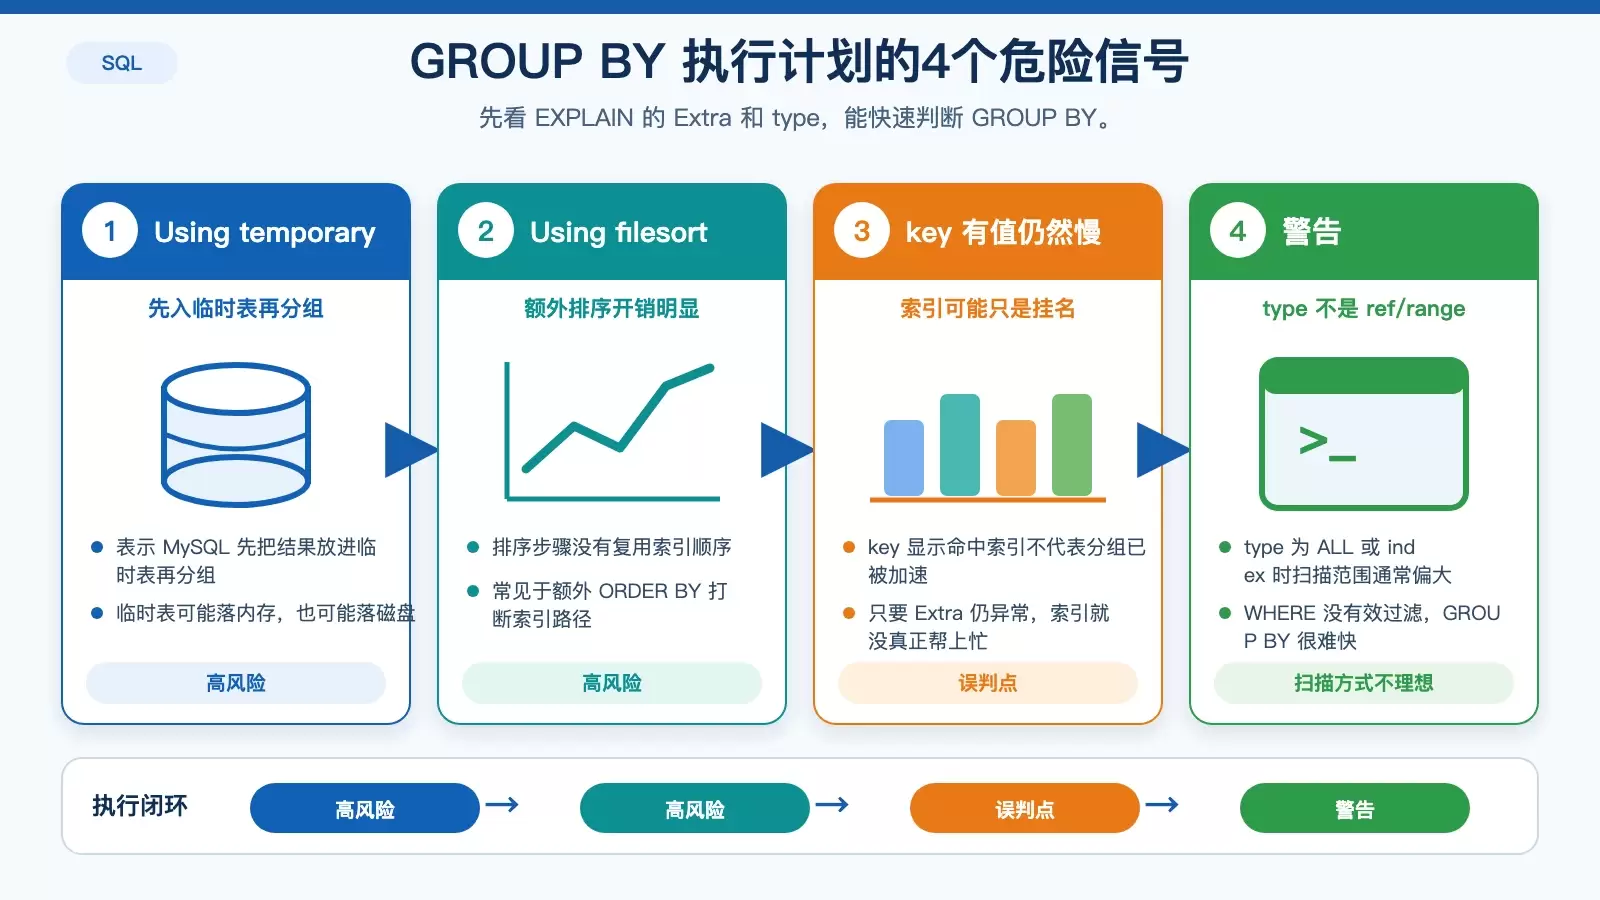
GROUP BY 查询变慢,常见根因不是数据量大,而是执行计划没走上正确的索引路径。排查时先看 EXPLAIN 的 Extra 列,再结合联合索引顺序、覆盖情况、类型转换和 DISTINCT 替代场景逐项定位。 遇到 GROUP BY 查询变慢时,很多优化都停留在“补个索引试试”这一层,结果往往不稳定。
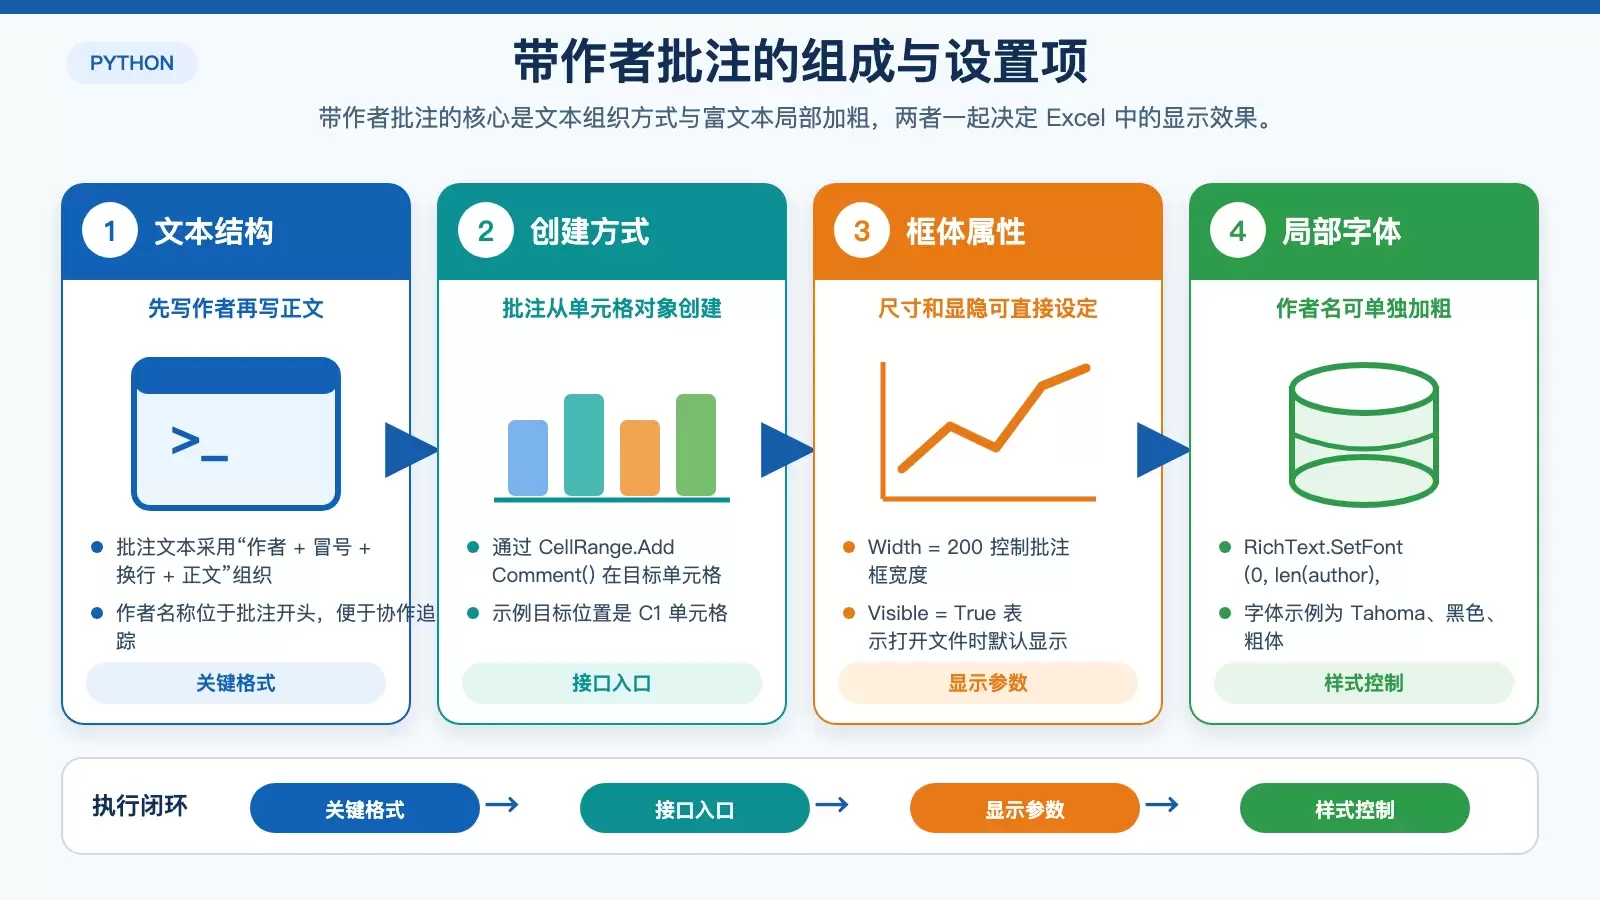
这篇文章用 Spire.XLS for Python 梳理了 Excel 批注的常见自动化操作,包括添加作者批注、设置富文本和外观、批量读取,以及修改和删除。文中保留了关键代码与接口说明,也补充了批量处理时最容易踩到的索引问题。
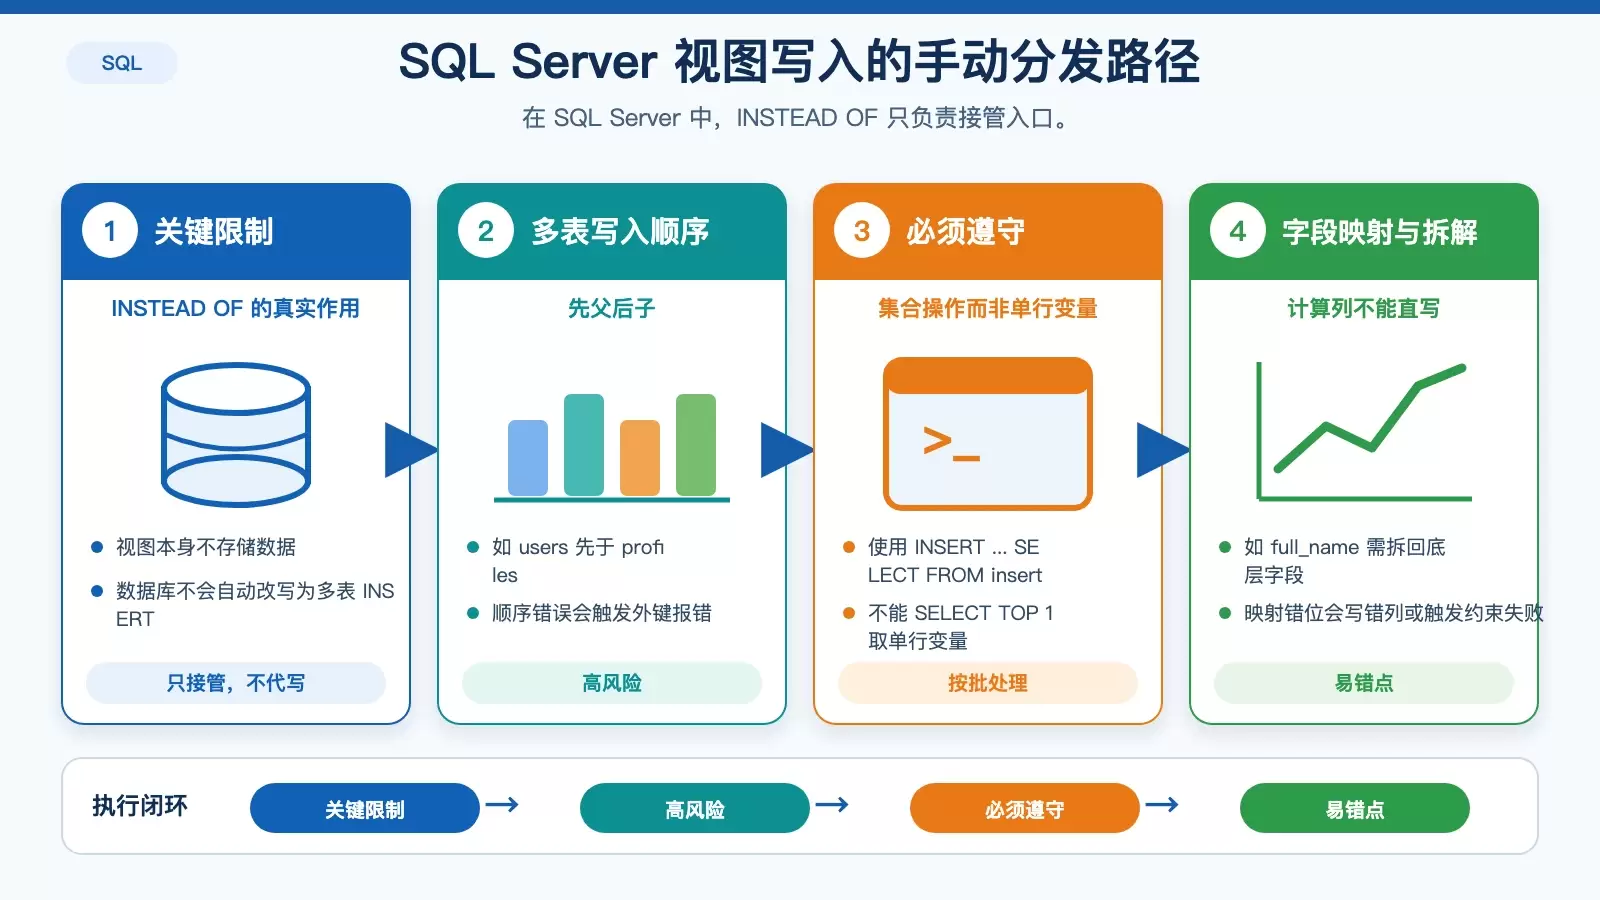
复杂视图之所以不能像表一样直接更新,核心不在语法,而在数据库是否愿意替你拆解 DML。SQL Server 允许借助 INSTEAD OF 触发器接管写入,但所有分发表、字段映射和校验都要手写;MySQL 则直接禁止在视图上创建触发器。
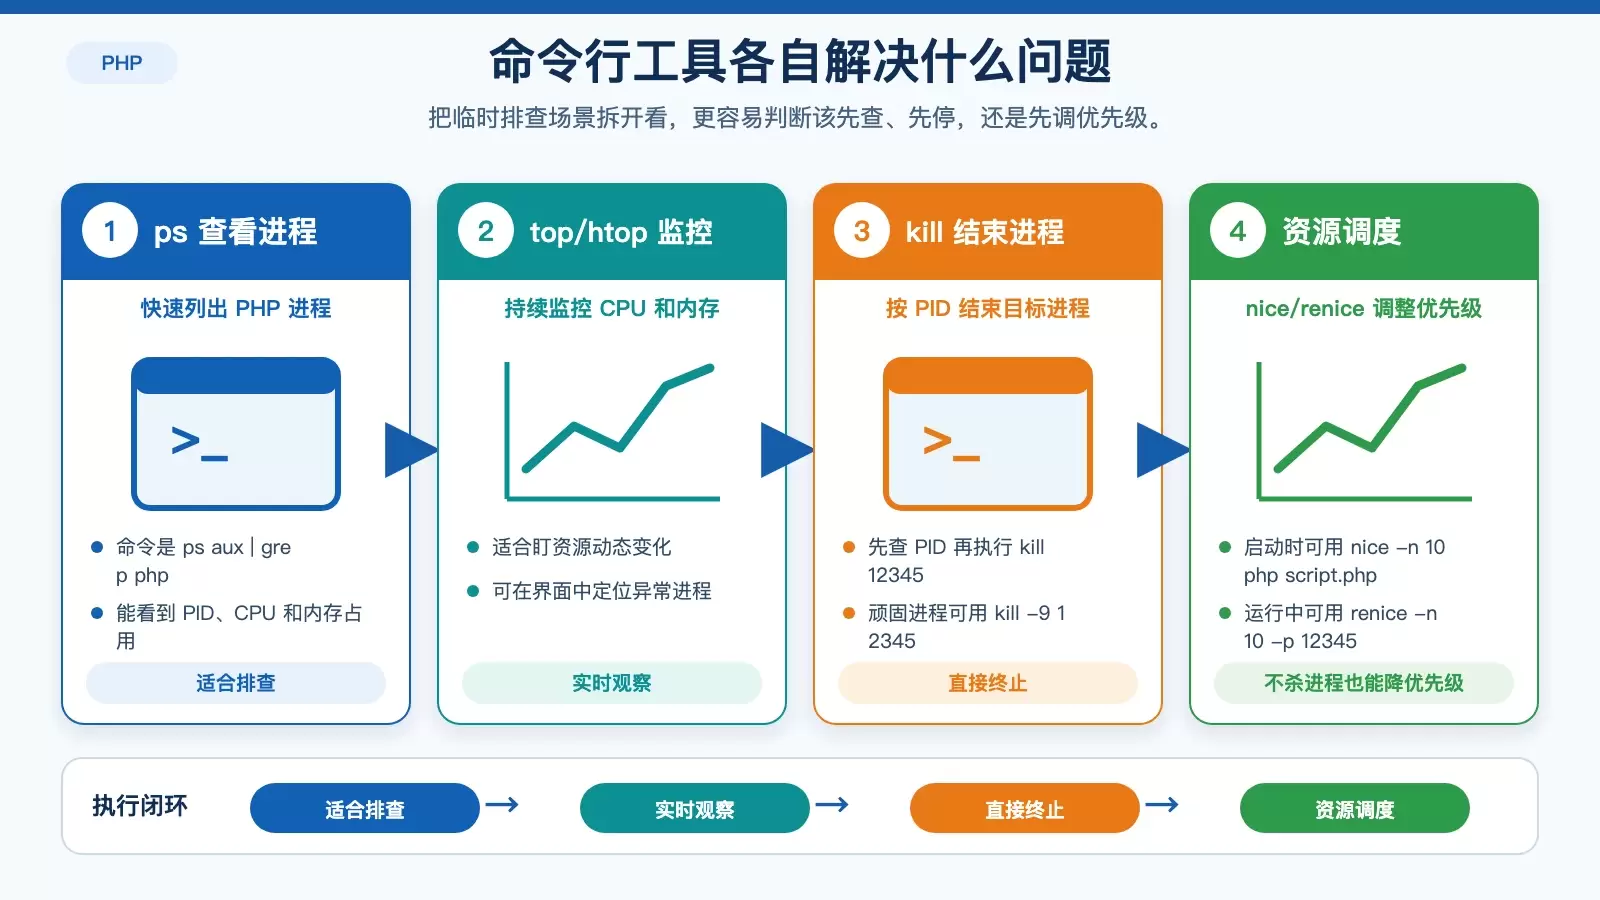
Linux 上管理 PHP 进程并不只有一种做法:临时排查可以靠命令行,常驻服务更适合交给 Supervisor 或 Systemd,自定义需求则能用脚本和 PHP 扩展补位。本文按使用场景拆解几类常见方案,帮你判断该用哪一种。
本文围绕 Java 中超大整数计算的常见问题,系统梳理 BigInteger 的适用场景、创建方式、运算与比较规则,并总结几个最容易踩坑的细节。看完后你可以更快判断:什么时候该用 BigInteger,怎么写才不出错。
Rust 能显著降低内存错误,但并不意味着 Linux 上写的 Rust 程序就不会泄漏。本文按“动态检测、趋势分析、代码审查、定向验证”四条线梳理 Valgrind、heaptrack、massif 与 Rust 生态工具的用法,帮助你判断该先用哪类工具、看什么结果、哪些代码最值得重点排查。
计算商品销量占分类总量的比例,核心是把分母写成 `SUM(sales) OVER(PARTITION BY category)`,再处理好整数除法、零值分母和版本兼容。本文按“正确写法、避坑、防精度误判、旧版替代方案”梳理,方便直接落到查询里。
C# 的 `struct` 常被拿来和 `class` 对比,但真正影响代码行为的,是它“值类型”的特性。本文从定义方式、赋值复制、可包含的方法类型,到与类在传递和继承上的差异,梳理结构的核心用法与判断边界。
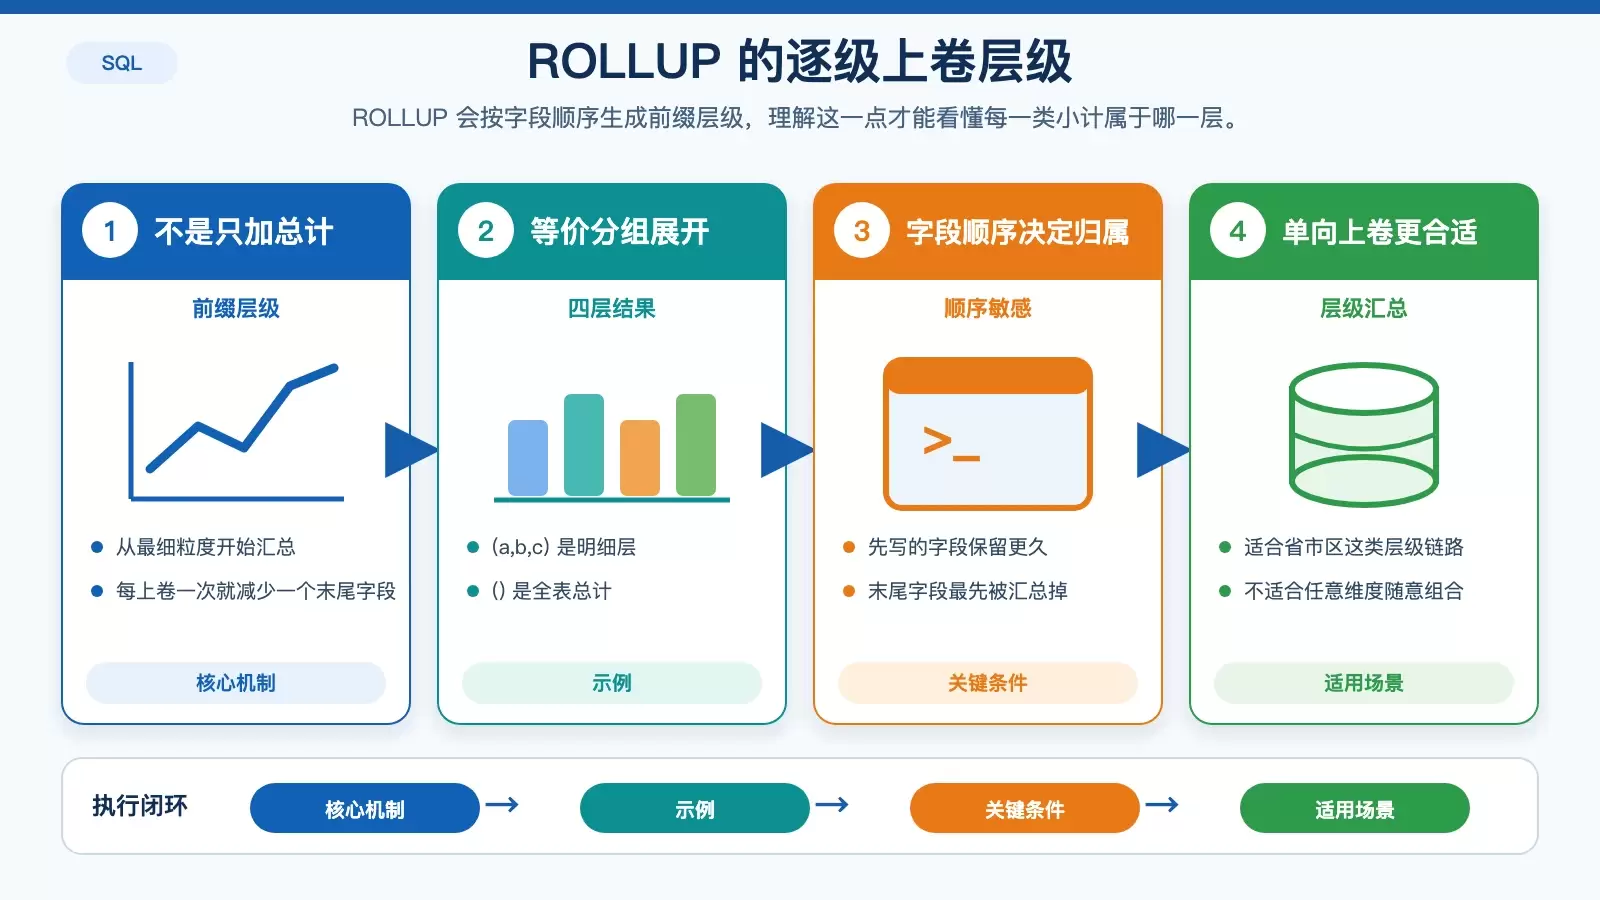
本文围绕 SQL 中的 ROLLUP 用法展开,说明它如何按字段顺序生成小计与总计、如何识别结果中的汇总行,以及何时该改用 CUBE 或 GROUPING SETS。文中保留关键 SQL 写法,并补充了大表场景下的使用注意点。 在报表、经营分析和分层汇总场景里,很多人知道 ROLLUP 能“顺手带出总计”,但真正写到查询里时,往往会被层级顺序、 NULL 含义和标签显示。