


在报表、经营分析和分层汇总场景里,很多人知道 ROLLUP 能“顺手带出总计”,但真正写到查询里时,往往会被层级顺序、NULL 含义和标签显示方式绕住。本文按“先理解结果层级,再处理汇总行识别,最后判断适用边界”的顺序梳理 ROLLUP,读完你可以判断它适不适合当前报表,并避免把小计行当成脏数据误删。
ROLLUP 生成的分组层级怎么理解
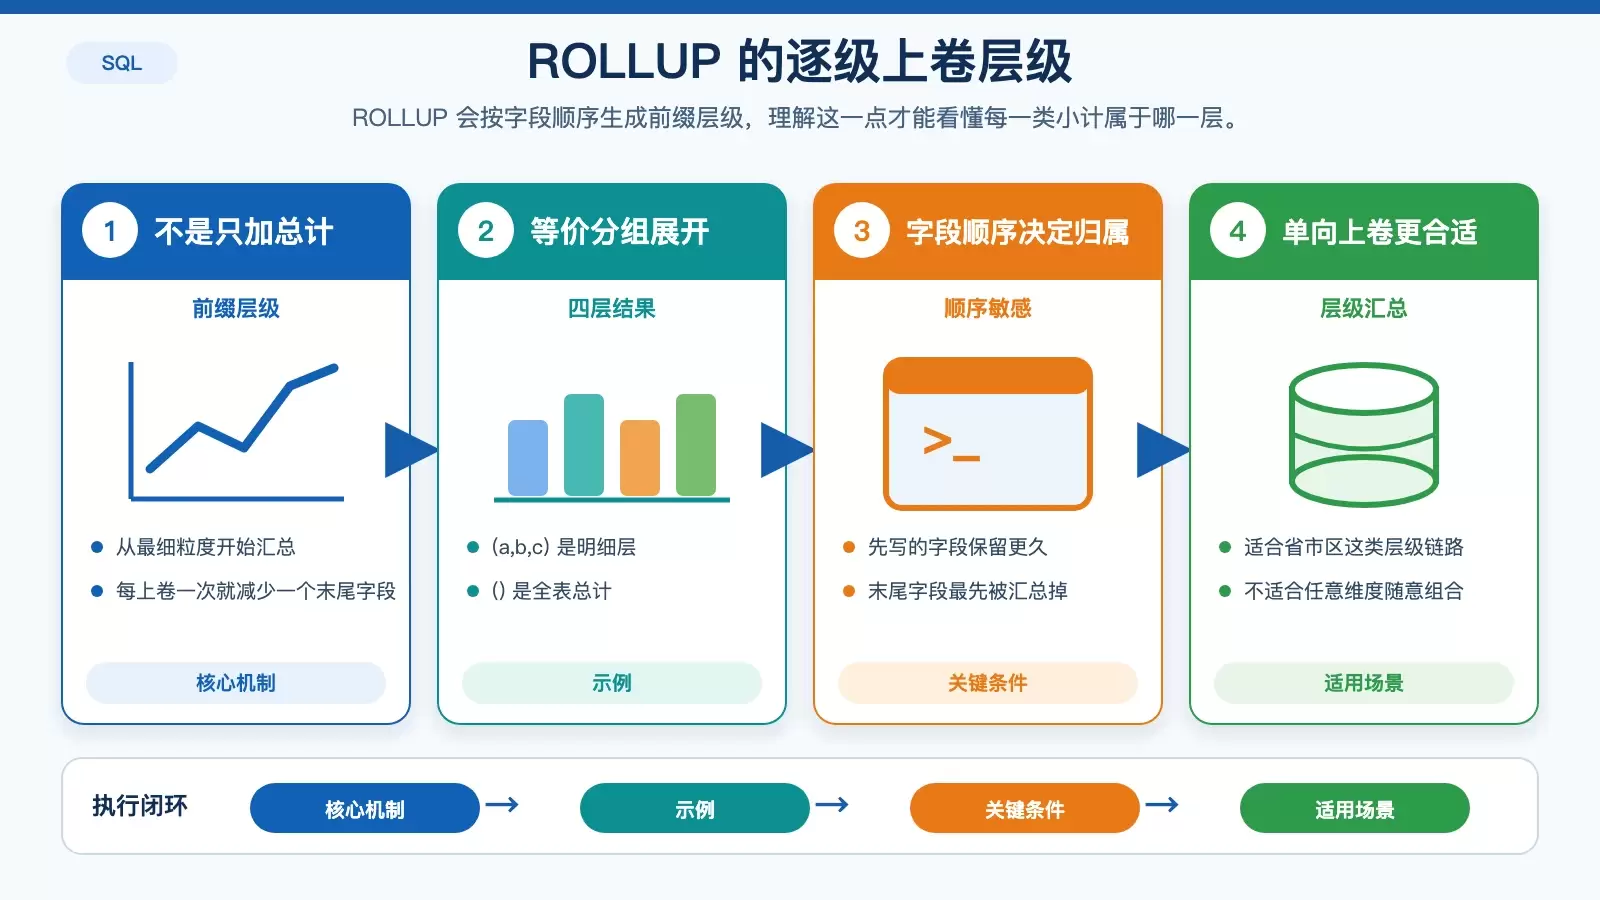
ROLLUP 不是只在结果末尾补一行“总计”,而是会按照字段顺序逐级上卷,生成从最细粒度到最粗粒度的一组层级聚合。
例如:
GROUP BY ROLLUP(a, b, c)它等价于依次生成以下几层:
GROUP BY a, b, c:明细层GROUP BY a, b:按c上卷后的小计GROUP BY a:按b、c继续上卷后的小计GROUP BY ():全表总计
这里最关键的是字段顺序。ROLLUP(a, b, c) 生成的是“前缀组合”,也就是从 a+b+c、a+b、a 一路往上汇总。如果顺序改了,小计所属层级也会跟着变化,结果含义就不一样了。
ROLLUP 结果里的 NULL 到底表示什么
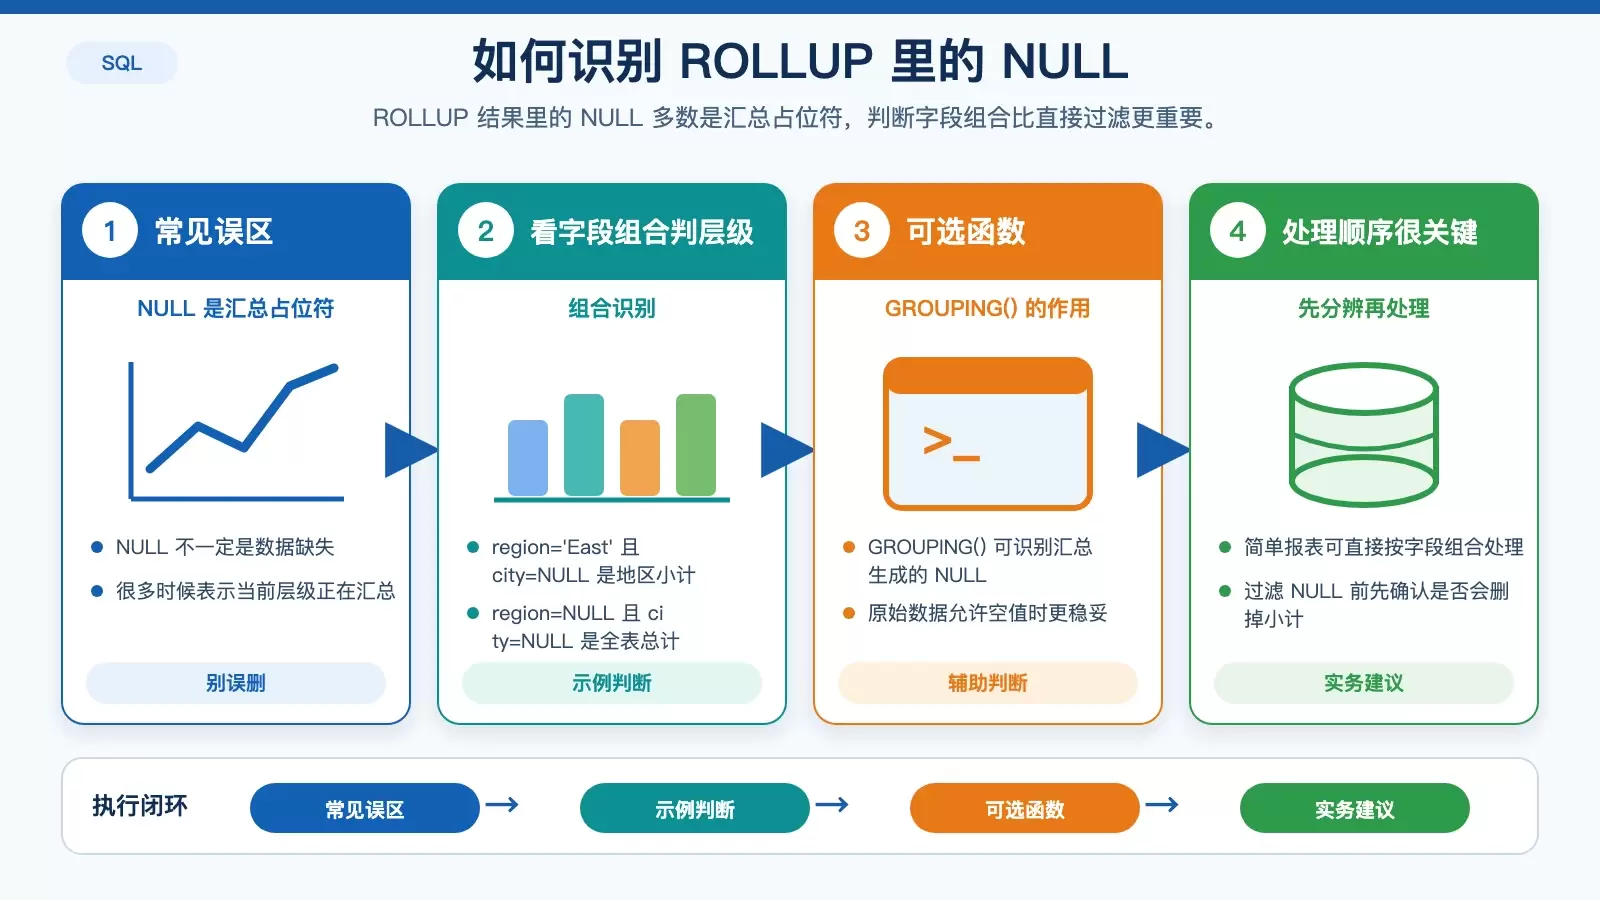
很多误判都出在这里:ROLLUP 结果中的 NULL,通常不是原始数据缺失,而是“这一层正在做汇总”的占位符。
例如下面这类查询:
SELECT region, city, SUM(sales)
FROM t
GROUP BY ROLLUP(region, city)
结果里如果出现:
region = 'East'且city IS NULL:表示 East 地区所有城市的销售小计region IS NULL且city IS NULL:表示全表总计
这意味着,不能简单把含 NULL 的行当成异常数据过滤掉,否则你删掉的很可能正是地区小计或全表总计。
如果原始数据里本身也可能存在真正的 NULL,就需要进一步区分“数据为空”和“ROLLUP 生成的汇总占位”。这时可以用 GROUPING() 来判断。多数简单报表里,仅靠字段组合逻辑就够用;但只要数据源本身允许空值,GROUPING() 会更稳妥。
如何给小计和总计显示可读标签
实际出报表时,直接展示 NULL 可读性很差,通常需要把它改成“小计”“总计”这类标签。常见做法是用 CASE WHEN 按层级打标。
SELECT
CASE
WHEN city IS NULL AND region IS NOT NULL THEN region + ' 小计'
WHEN region IS NULL THEN '总计'
ELSE region
END AS region_label,
city,
SUM(sales) AS total_sales
FROM sales
GROUP BY ROLLUP(region, city);
这里最容易写错的是判断顺序。要先判断更细一层的“小计行”,再判断更粗一层的“总计行”。
以上例来说:
- 先判
city IS NULL AND region IS NOT NULL,识别地区小计 - 再判
region IS NULL,识别全表总计
如果把 region IS NULL 提前,虽然这个例子里语义上仍可工作,但在更复杂的多层 ROLLUP 查询中,过早命中更粗层级条件,往往会让标签覆盖掉原本应展示的小计含义。稳妥的写法始终是按层级从细到粗判断。
ROLLUP、CUBE 和 GROUPING SETS 怎么选
这三个语法都属于分组聚合扩展,但适用场景并不一样。
ROLLUP:适合单向层级汇总
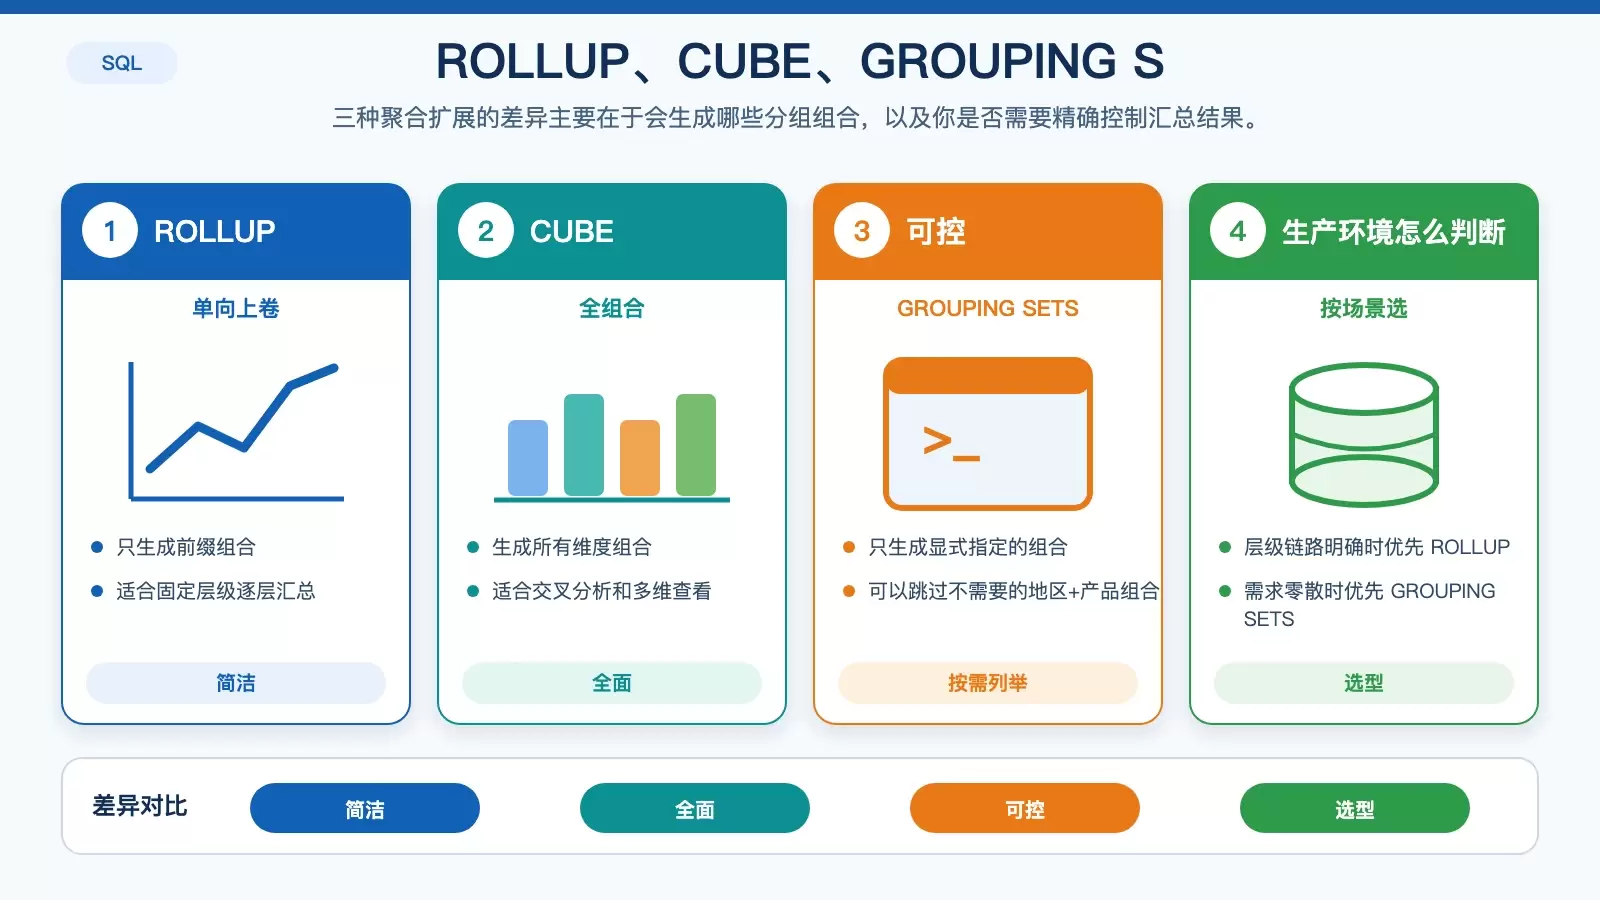
ROLLUP 只生成前缀组合,典型场景是沿固定业务层级逐层上卷,比如“省 → 市 → 区”或“部门 → 小组 → 成员”。这类需求用它最直接。
CUBE:适合多维交叉分析
CUBE(a,b) 会生成所有组合,例如:
(a)(b)(a,b)()
它更适合分析型查询,需要从多个维度交叉看结果时使用。
GROUPING SETS:适合精确指定要哪些汇总
GROUPING SETS 最灵活,可以只保留你真正需要的组合:
GROUPING SETS ((region), (product), ())这表示只要:
- 地区小计
- 产品小计
- 全表总计
而不会额外生成 region + product 这种你未明确要求的组合。
如果业务需求只是沿一条层级链路逐层汇总,ROLLUP 最简洁;如果你需要任意组合,尤其是不连续的汇总集合,直接用 GROUPING SETS 会更可控。
大表场景下还要注意什么
ROLLUP 虽然语法简洁,但执行成本通常高于普通 GROUP BY。在不少数据库实现里,它的执行计划会带来比普通分组更多的临时数据扫描,文中提到的经验值是:通常会比普通 GROUP BY 多一倍以上的临时数据扫描。
这不意味着不能用,而是需要结合数据量评估:
- 报表维度稳定、层级明确时,
ROLLUP可以减少 SQL 拼接复杂度 - 在大表上执行前,最好先确认
GROUP BY字段是否具备合适的索引覆盖 - 如果只需要少数几种汇总结果,优先考虑
GROUPING SETS,避免生成多余层级
简单说,ROLLUP 值得用,但它不是“免费总计”。查询更短了,不代表执行一定更轻。









