如何在 C++ 中使用非标准头文件
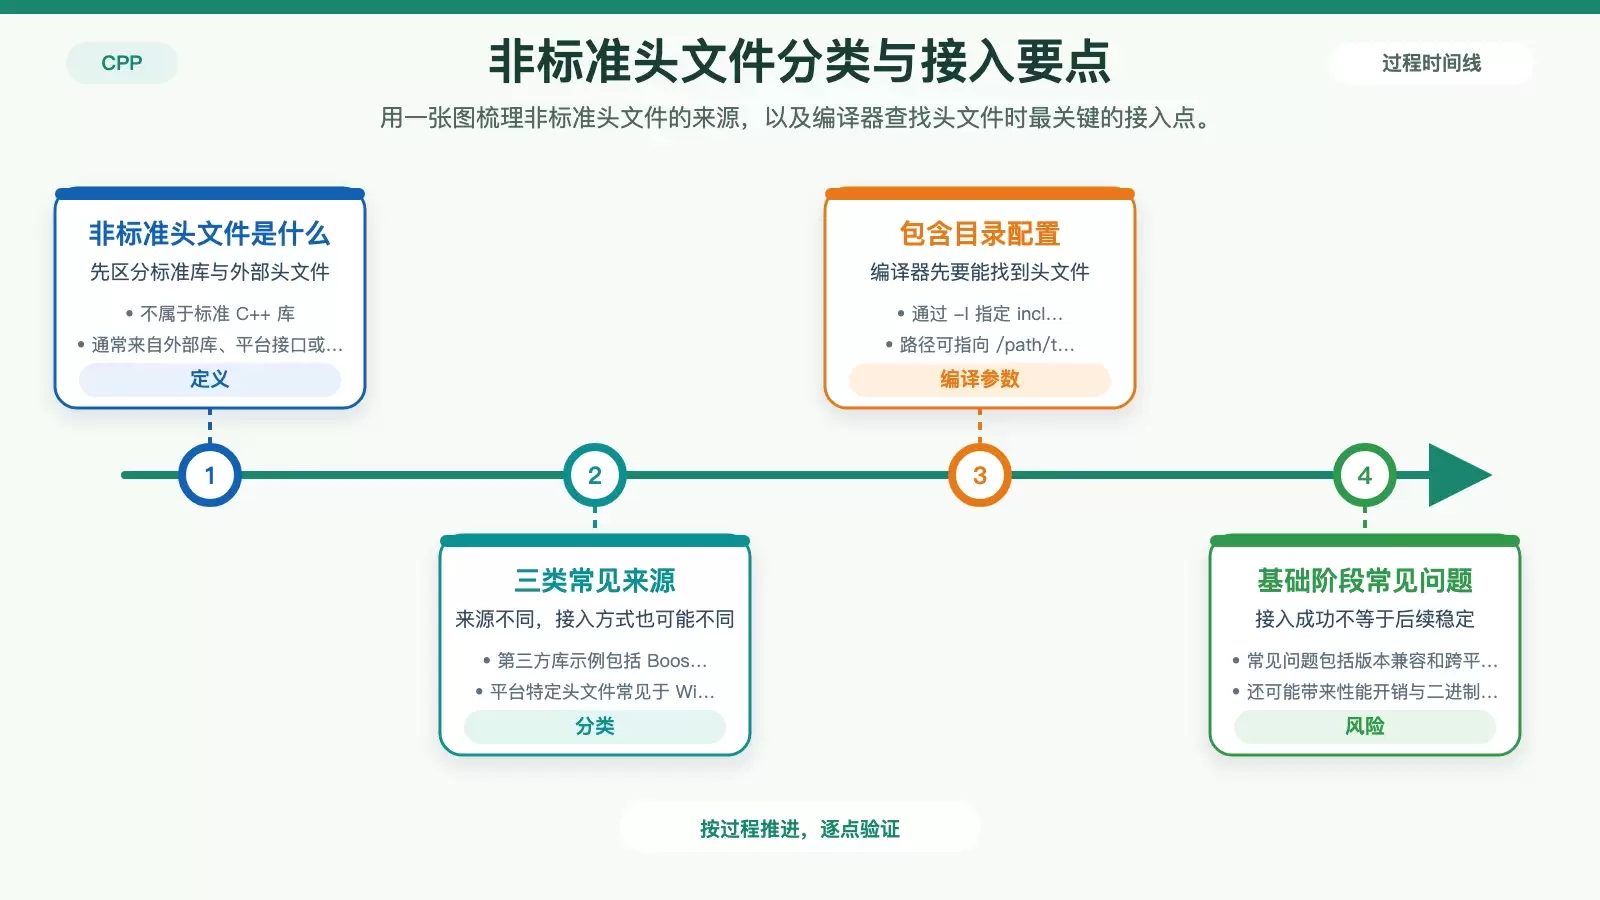
这篇文章围绕 C++ 项目中常见的“非标准头文件怎么接入、怎么链接、怎么避坑”展开,梳理了头文件类型、编译参数、构建系统集成方式,以及依赖注入、模板元编程等进阶用法,适合作为从接入到优化的一份实用参考。
2026-08-23
46

这篇文章围绕 C++ 项目中常见的“非标准头文件怎么接入、怎么链接、怎么避坑”展开,梳理了头文件类型、编译参数、构建系统集成方式,以及依赖注入、模板元编程等进阶用法,适合作为从接入到优化的一份实用参考。
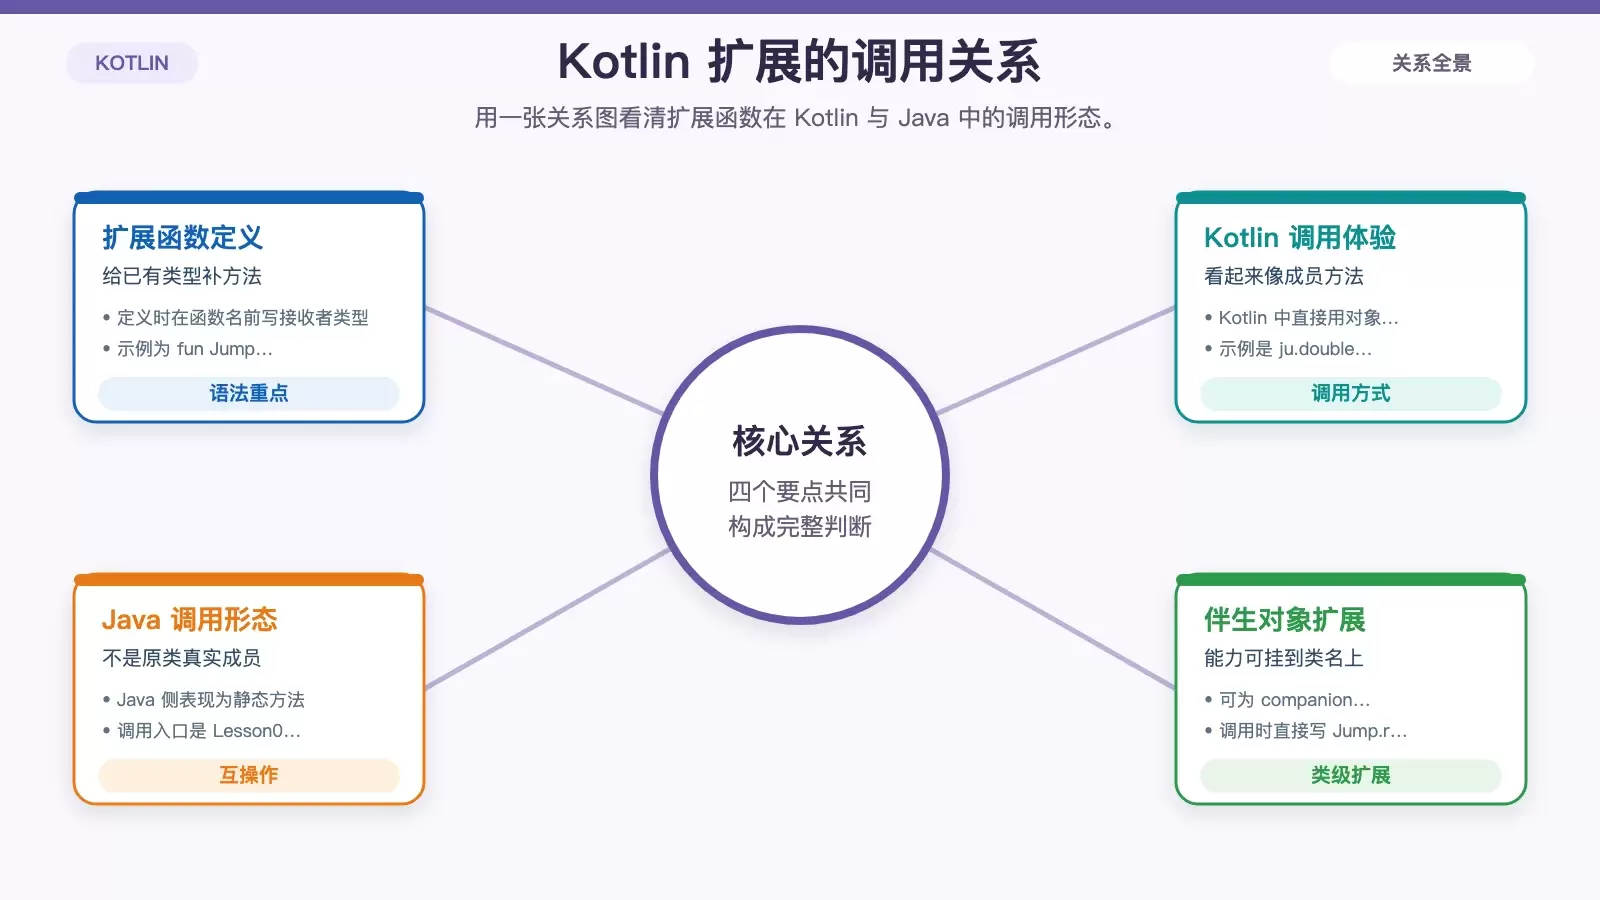
Kotlin 的扩展机制允许开发者在不修改原类、也不继承的前提下,为现有类型补充函数和属性。本文从扩展函数的基本写法讲起,再到泛型扩展、伴生对象扩展,以及 let、run、apply 等常用作用域扩展的使用差异。
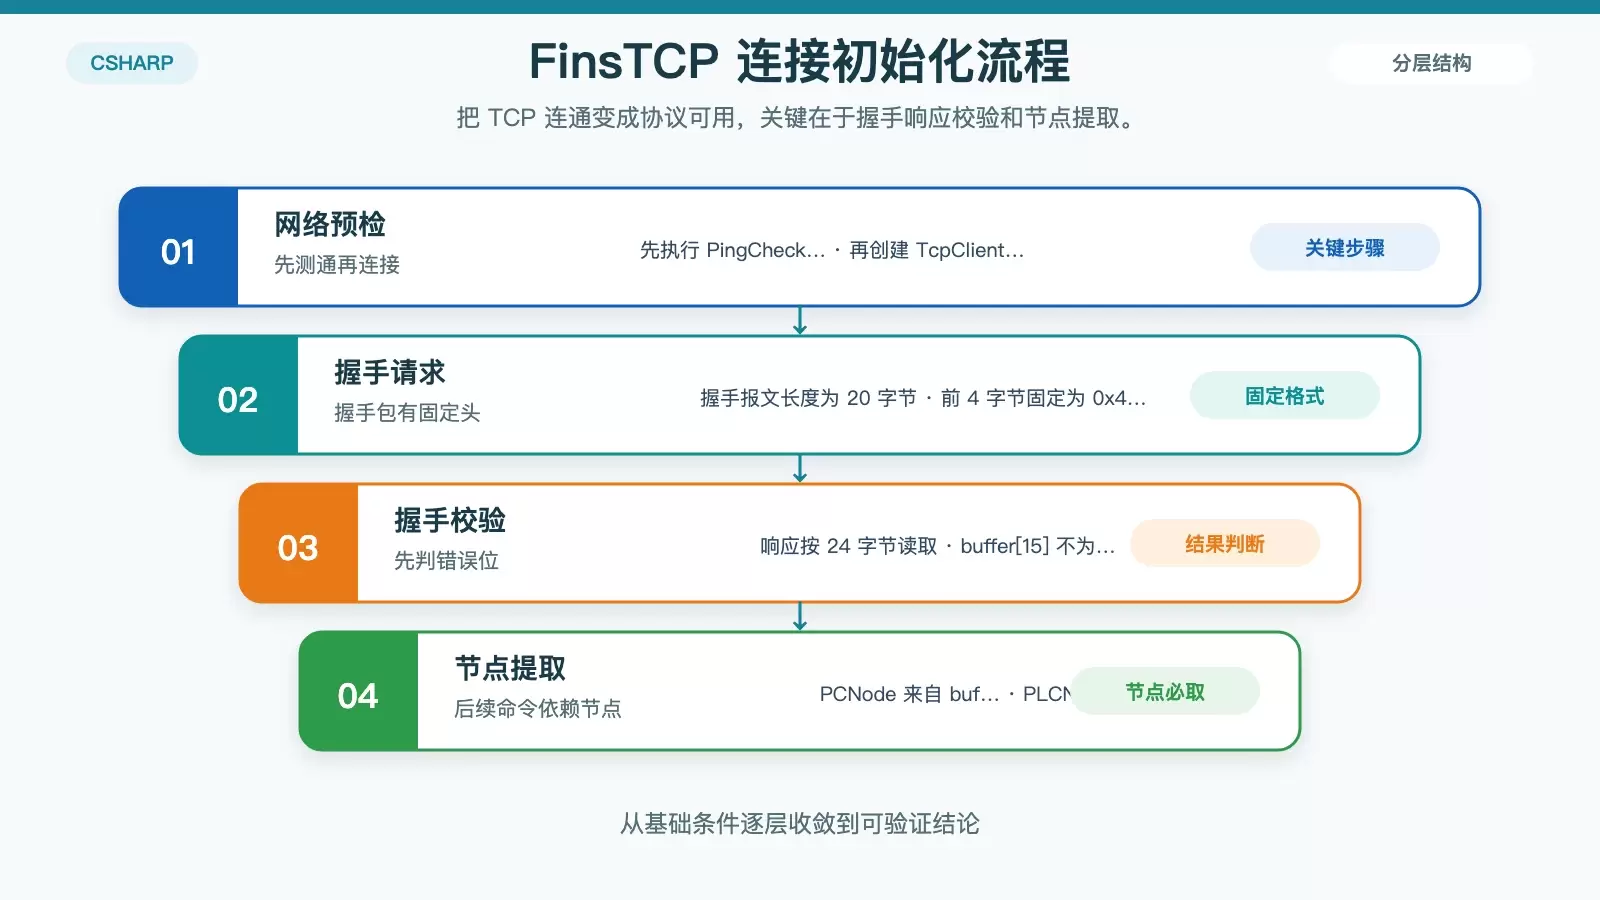
本文围绕欧姆龙 PLC 的 FinsTCP 通讯,梳理 C# 上位机开发中最关键的几步:握手获取节点、构造 FINS 命令、完成读写收发,以及连接检测与初始化。适合需要快速搭建通讯模块、同时想看清报文组织方式的开发者参考。
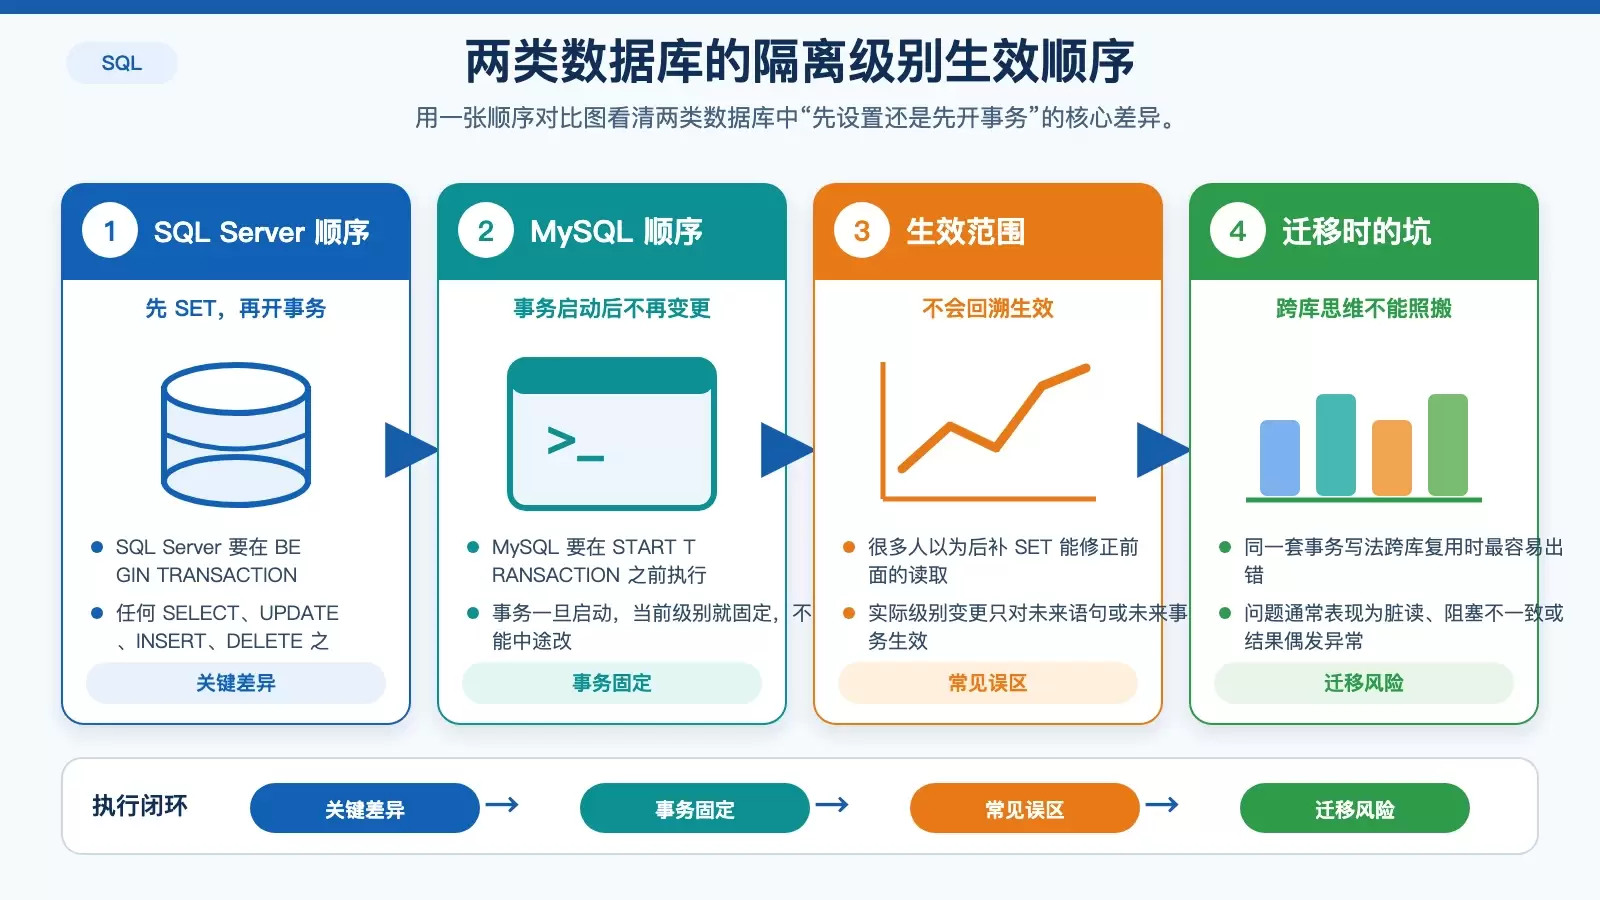
存储过程中设置事务隔离级别,真正容易出错的不是语法,而是生效时机。本文按 SQL Server 与 MySQL 分别梳理正确顺序、常见误区和并发风险,帮助你判断隔离级别到底有没有按预期执行。
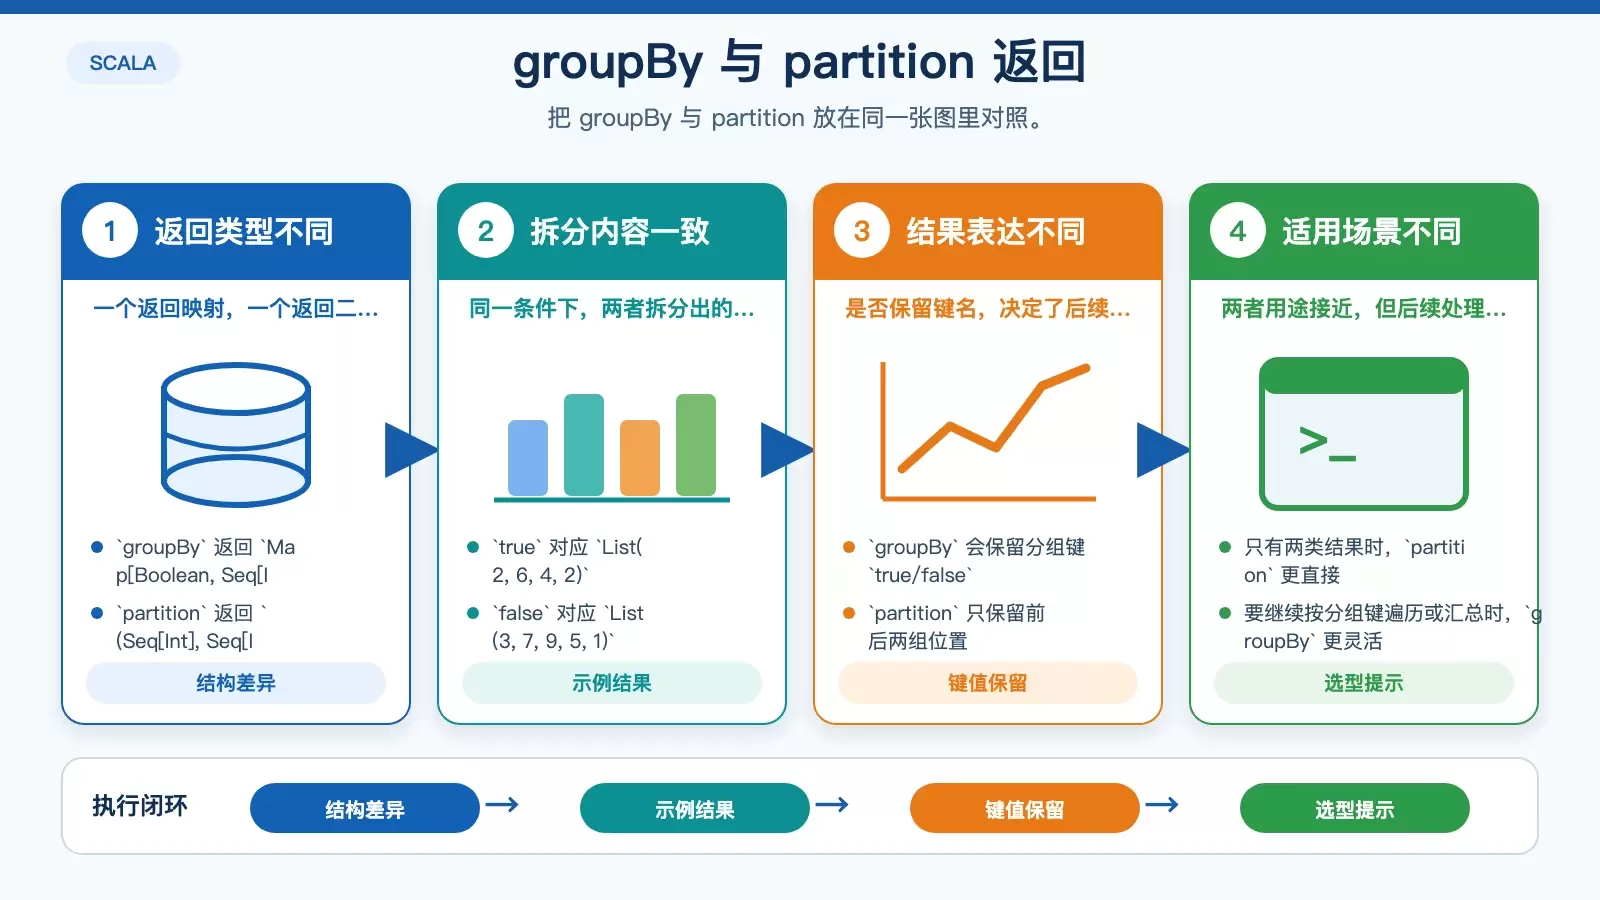
这篇文章把 Scala 集合里最常用的分组与排序方法拆开说明:`groupBy` 适合按规则聚类并继续统计,`sorted`、`sortBy`、`sortWith` 则分别对应默认排序、按字段排序和自定义规则排序。文中保留原始示例代码,并补上 `groupBy` 与 `partition` 的返回值差异,便于在 Spark/Flink 场景里快速选型。
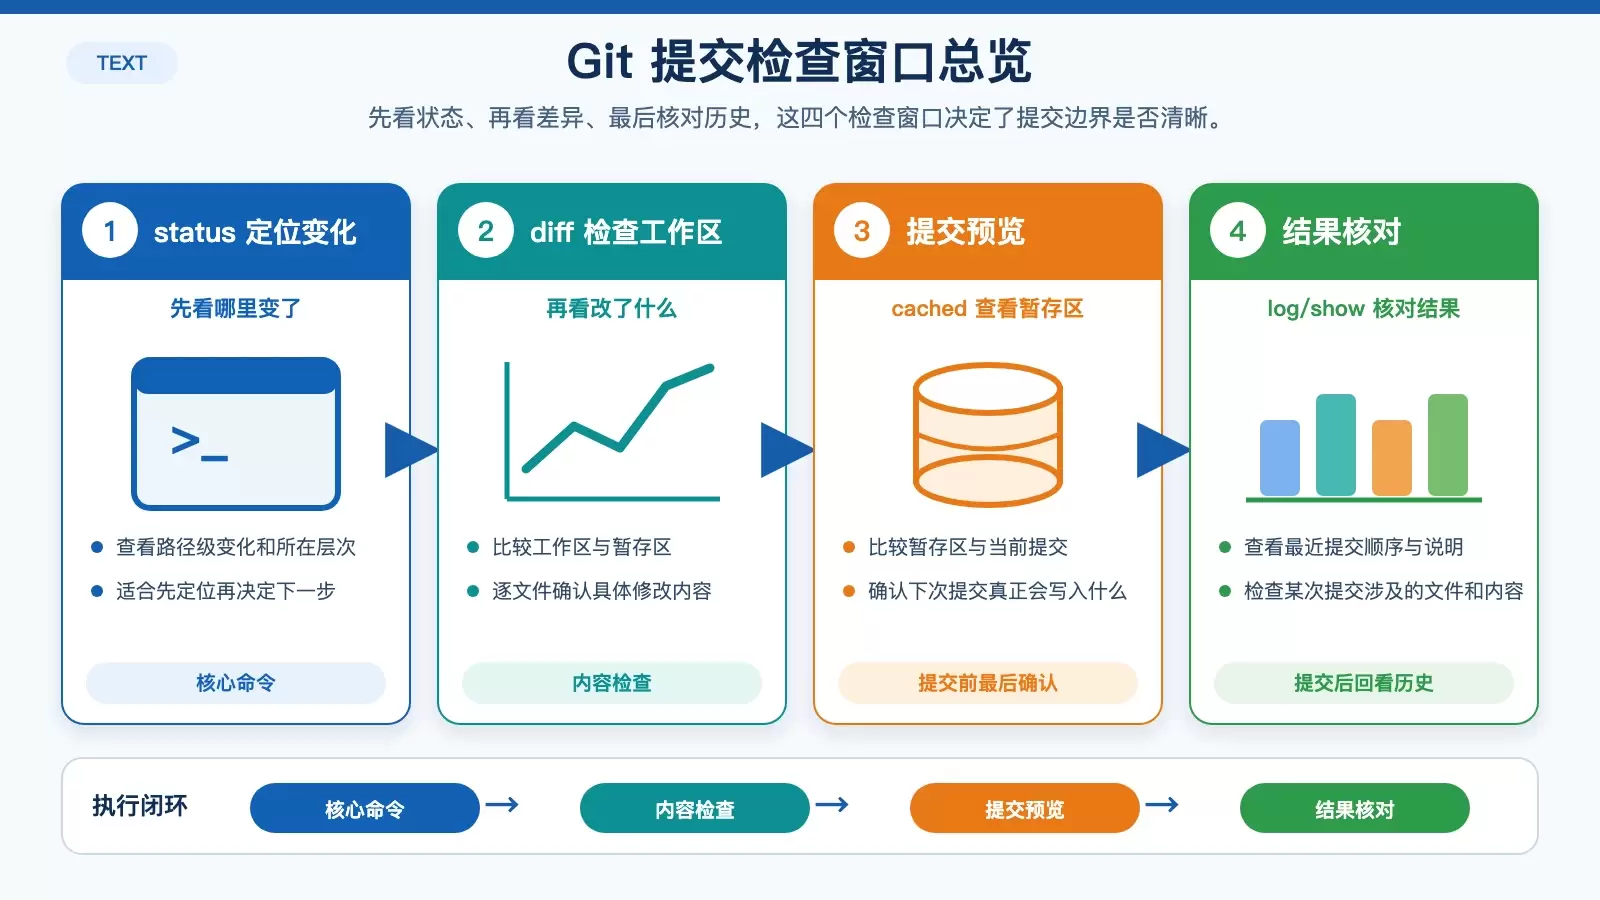
开发时多种改动混在一起很常见,真正困难的不是执行 `git add` 或 `git commit`,而是划清“这次该提交什么”。这篇文章用一个可复现实验仓库演示如何结合 `status`、`diff`、暂存区和 `git add --patch`,把代码、文档和本地杂项变化准确分开。
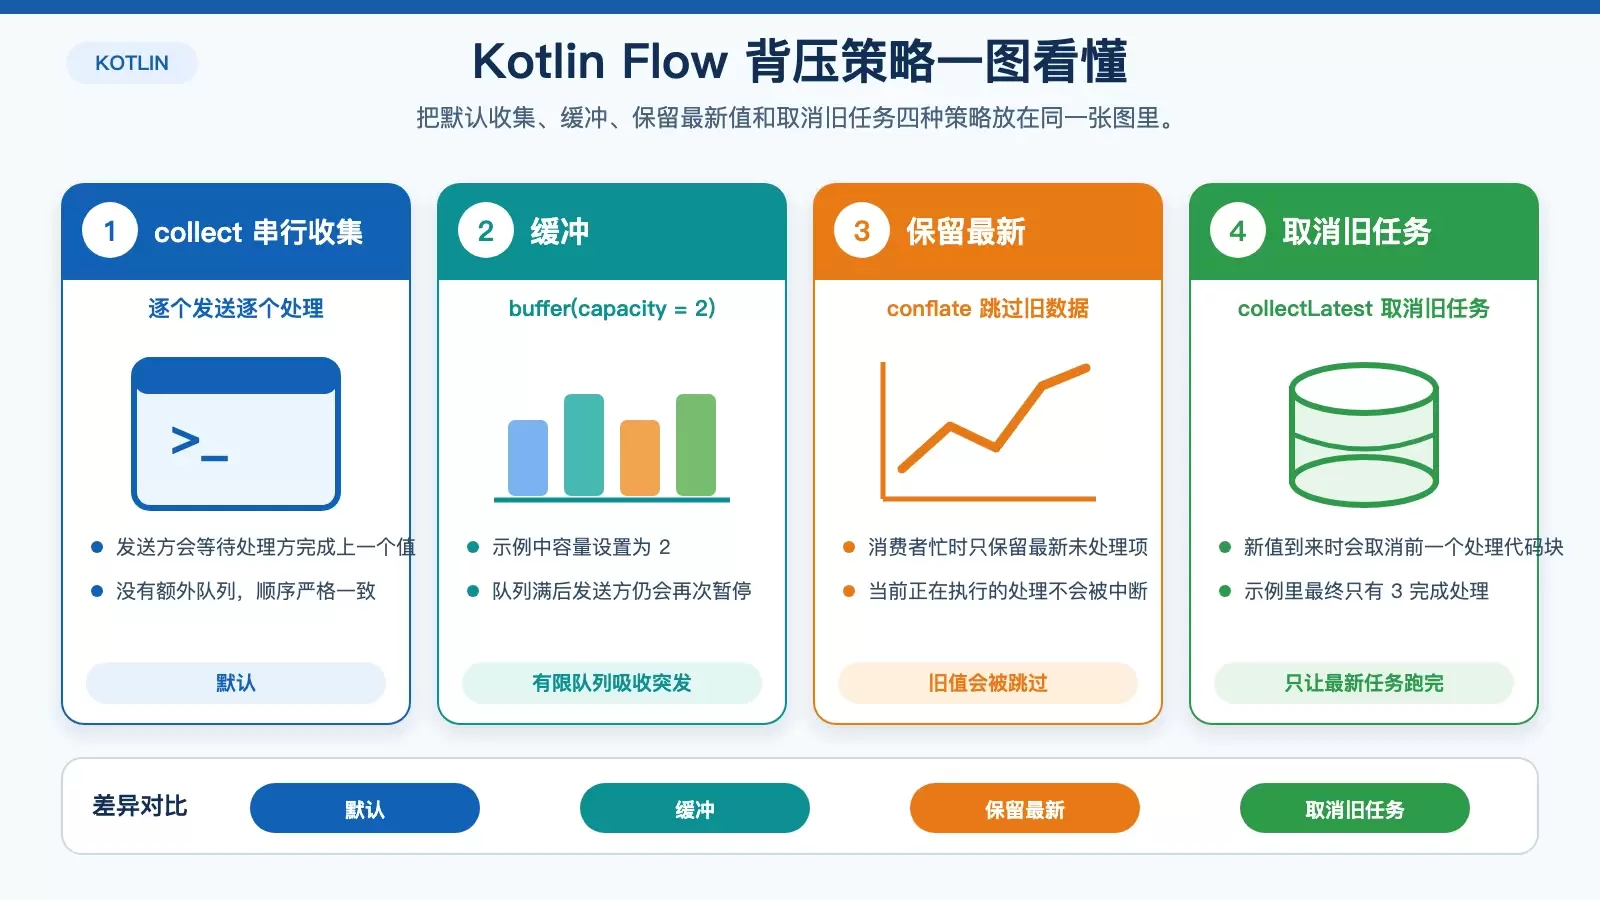
Kotlin Flow 的背压处理,核心是让快生产、慢消费的节奏重新匹配。本文用同一组示例讲清默认串行收集、`buffer()`、`conflate()` 和 `collectLatest {}` 的行为差异,并给出按场景选择的判断方法。 在 Kotlin Flow 的使用中,真正难的通常不是把数据“发出来”,而是上游很快、下游很慢时该怎么处理。
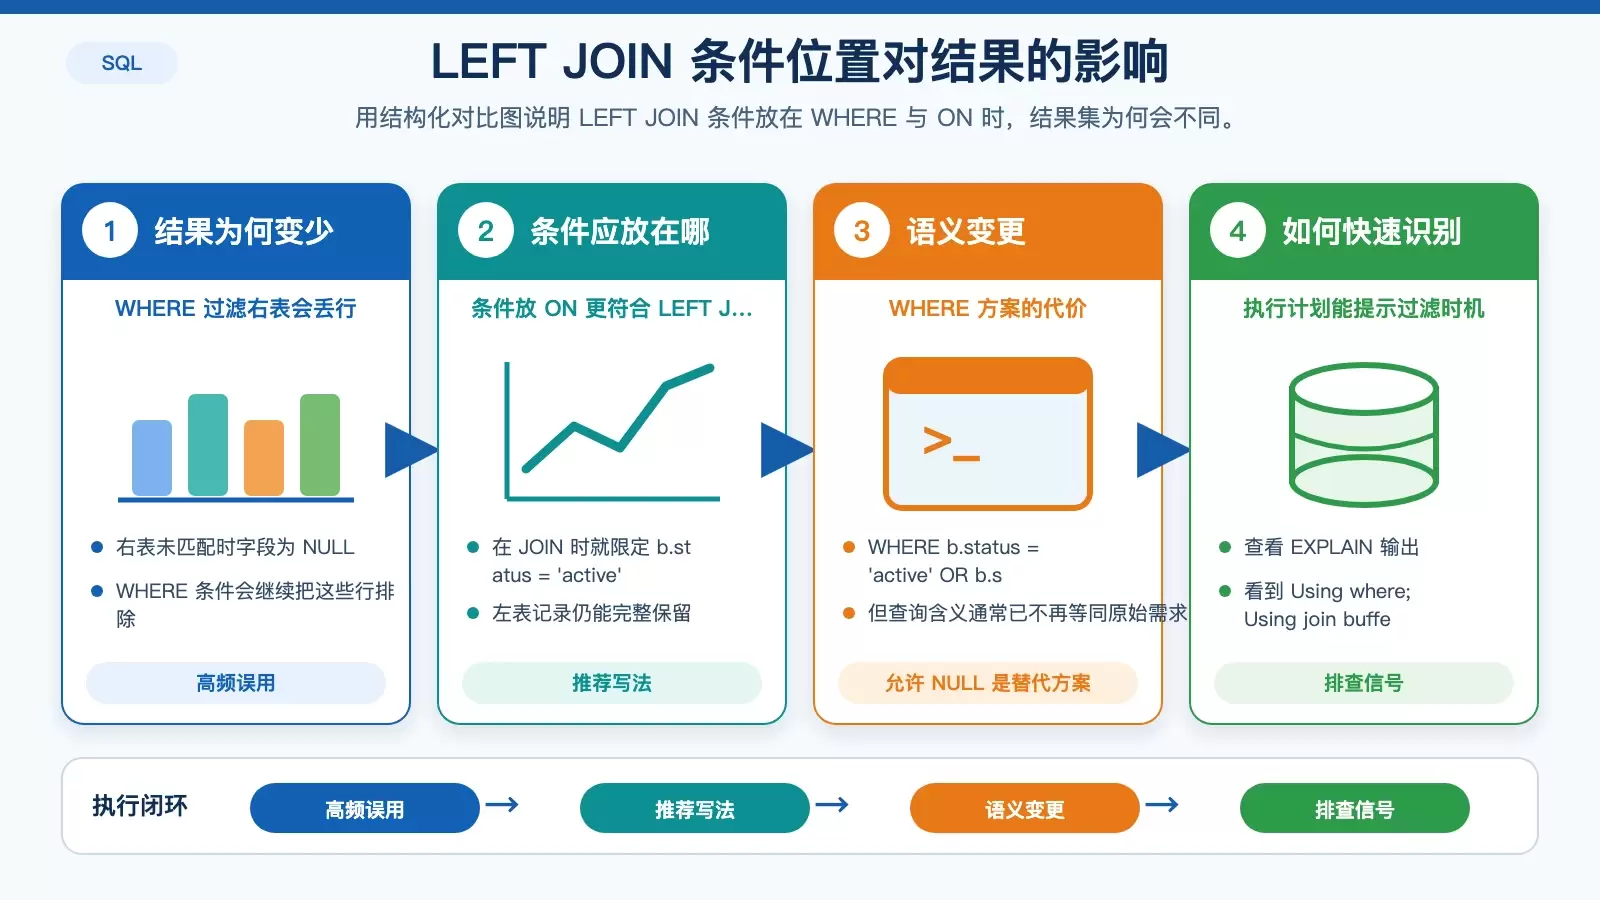
SQL 的 SELECT 查不出结果,很多时候不是数据没了,而是查询条件把目标行悄悄排除了。本文围绕 MySQL 中最常见的 4 类原因展开:NULL 比较、LEFT JOIN 过滤、隐形字符以及字段名与别名误用,并给出可直接套用的排查写法。
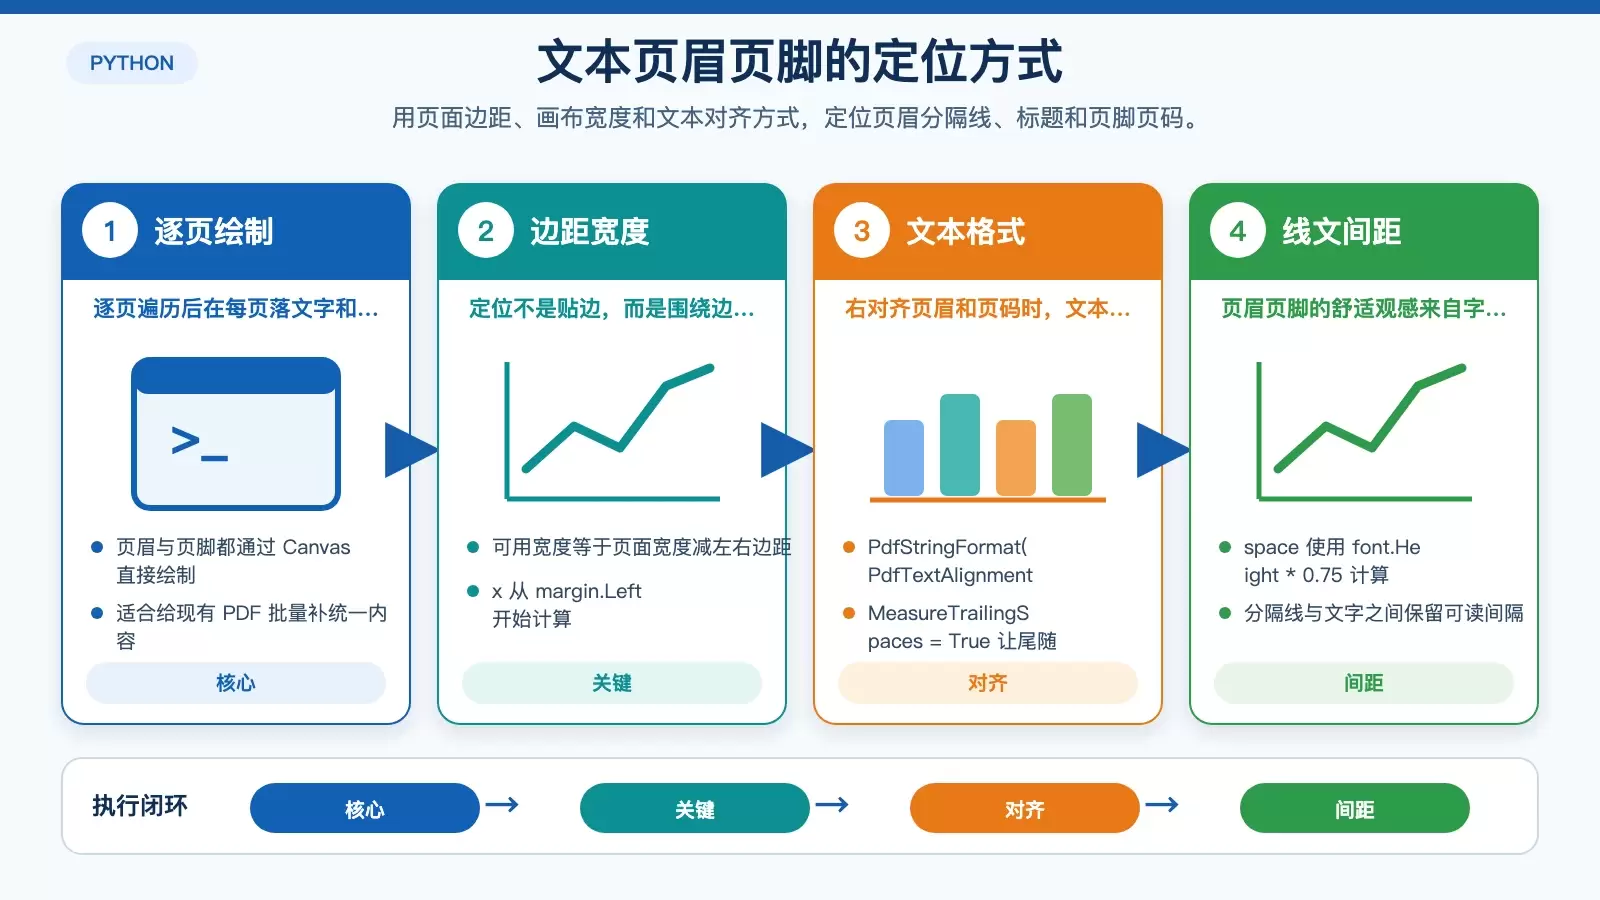
本文用 Spire.PDF 梳理 Python 给 PDF 添加页眉页脚的几种常见做法,包括逐页绘制文本、插入 Logo、按页面定制不同页眉,以及用页面模板自动生成页码。重点保留坐标、字体、模板和自动字段这些实现细节,方便你判断哪种方式更适合批量生成或正式文档场景。
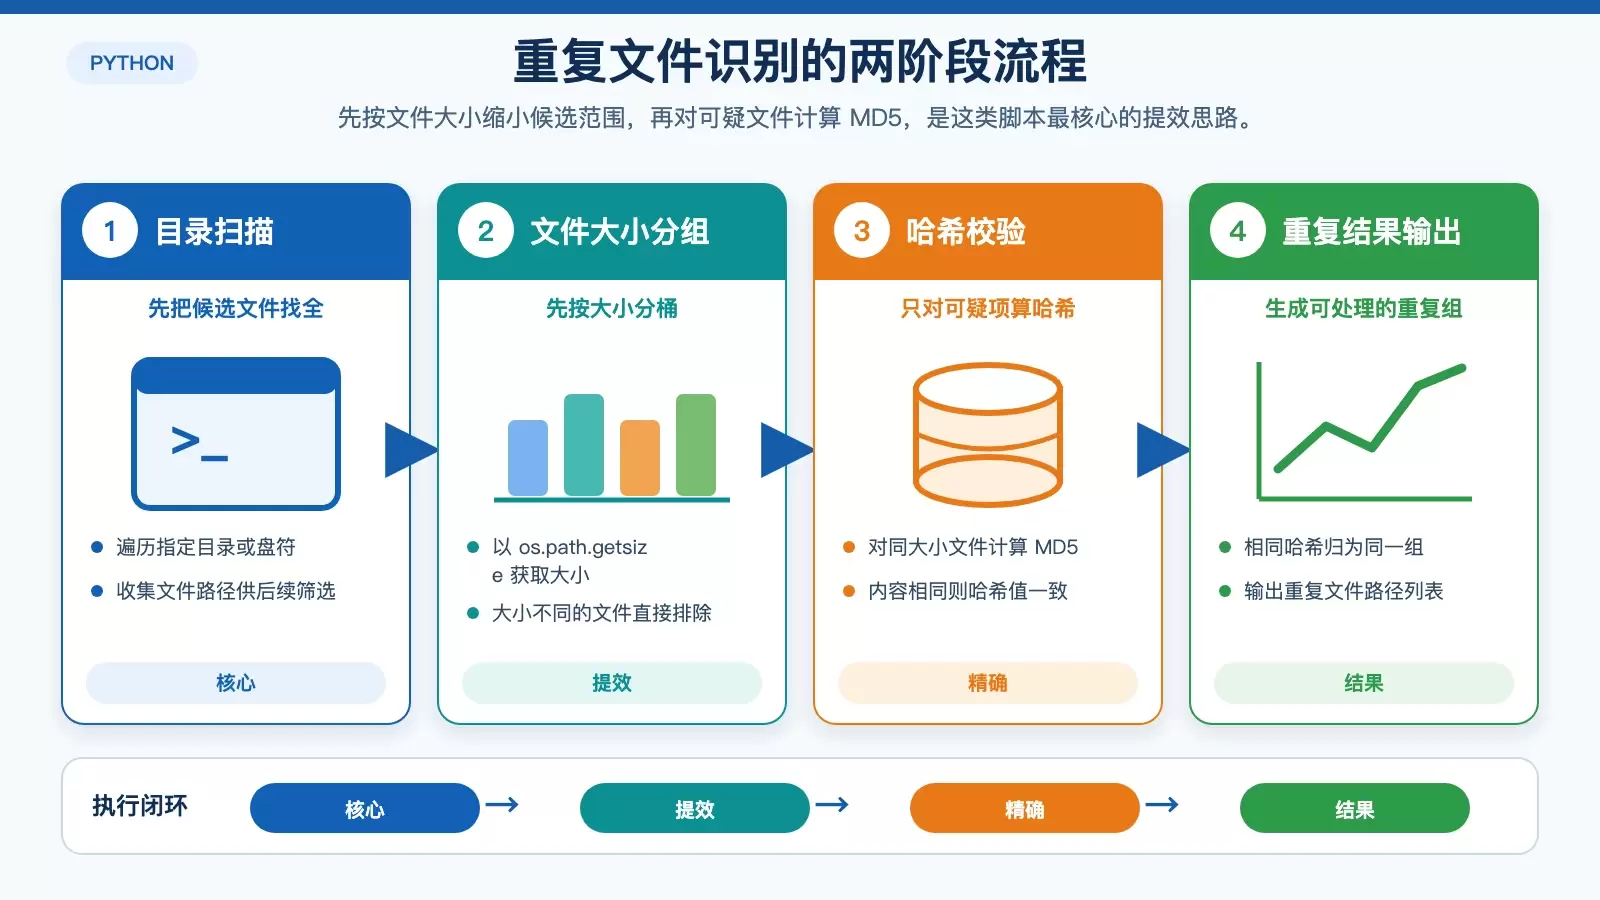
这篇文章用 Python 搭一个重复文件清理工具,核心思路是“先按文件大小筛选,再用 MD5 精确比对”。文中保留关键脚本与优化方法,并补充删除策略、权限处理、性能调优和 GUI 扩展,方便按实际场景落地。
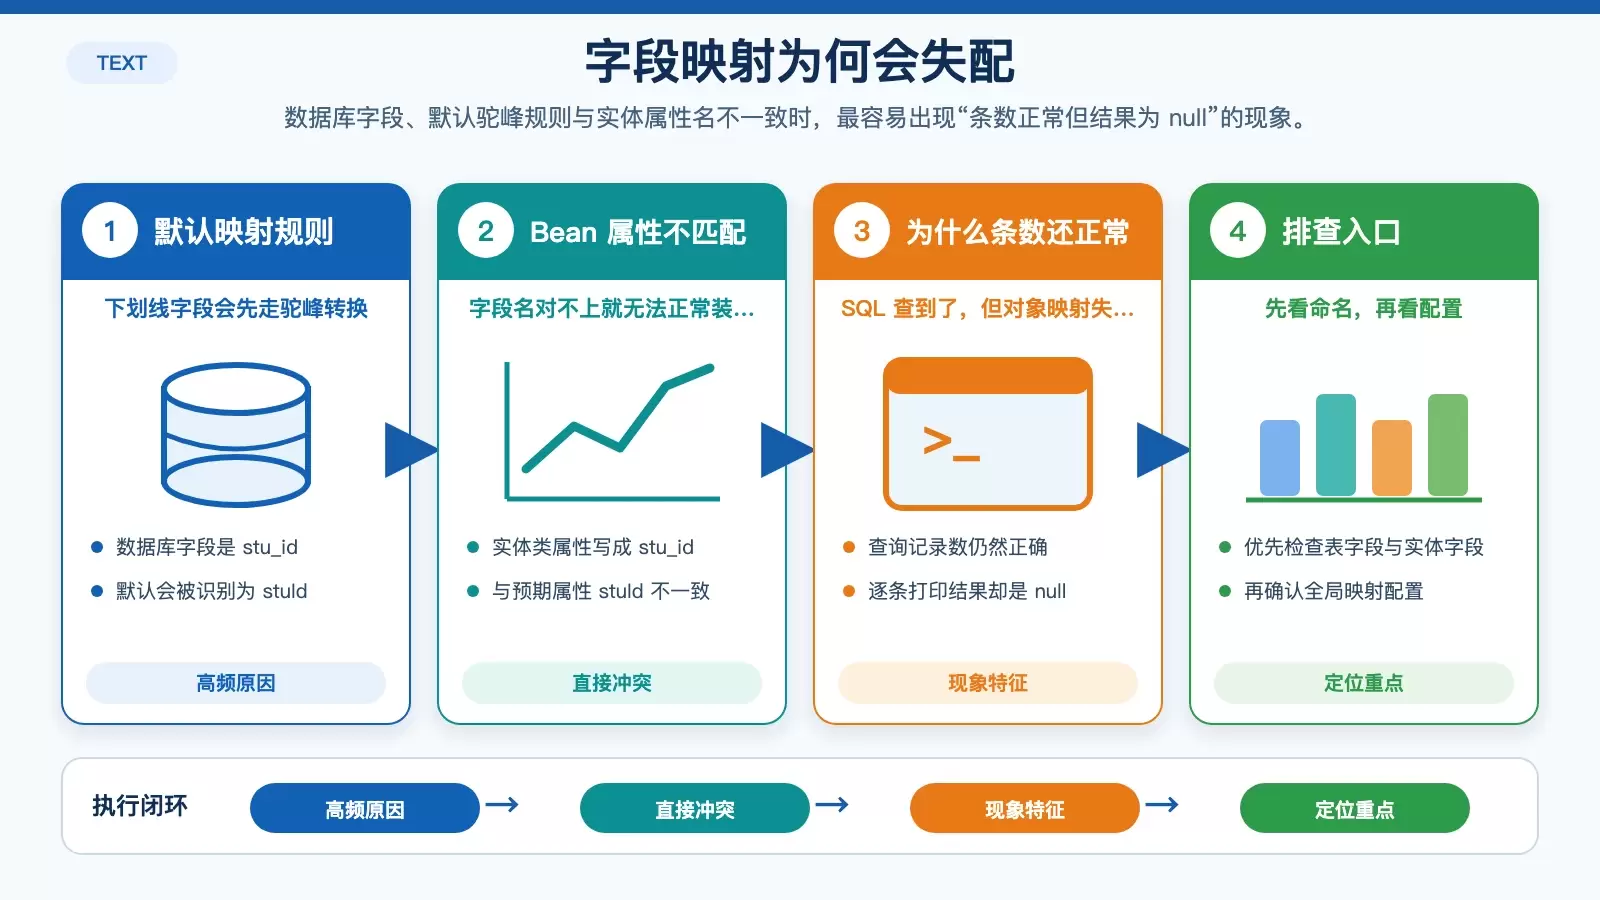
MyBatis-Plus 查询结果“条数正确但每项都是 null”,通常不是 SQL 没查到,而是结果映射阶段出了问题。最常见的原因是下划线字段与默认驼峰映射冲突,其次还要检查 Bean 的 setter、Lombok 生效情况,以及是否需要关闭 `map-underscore-to-camel-case`。
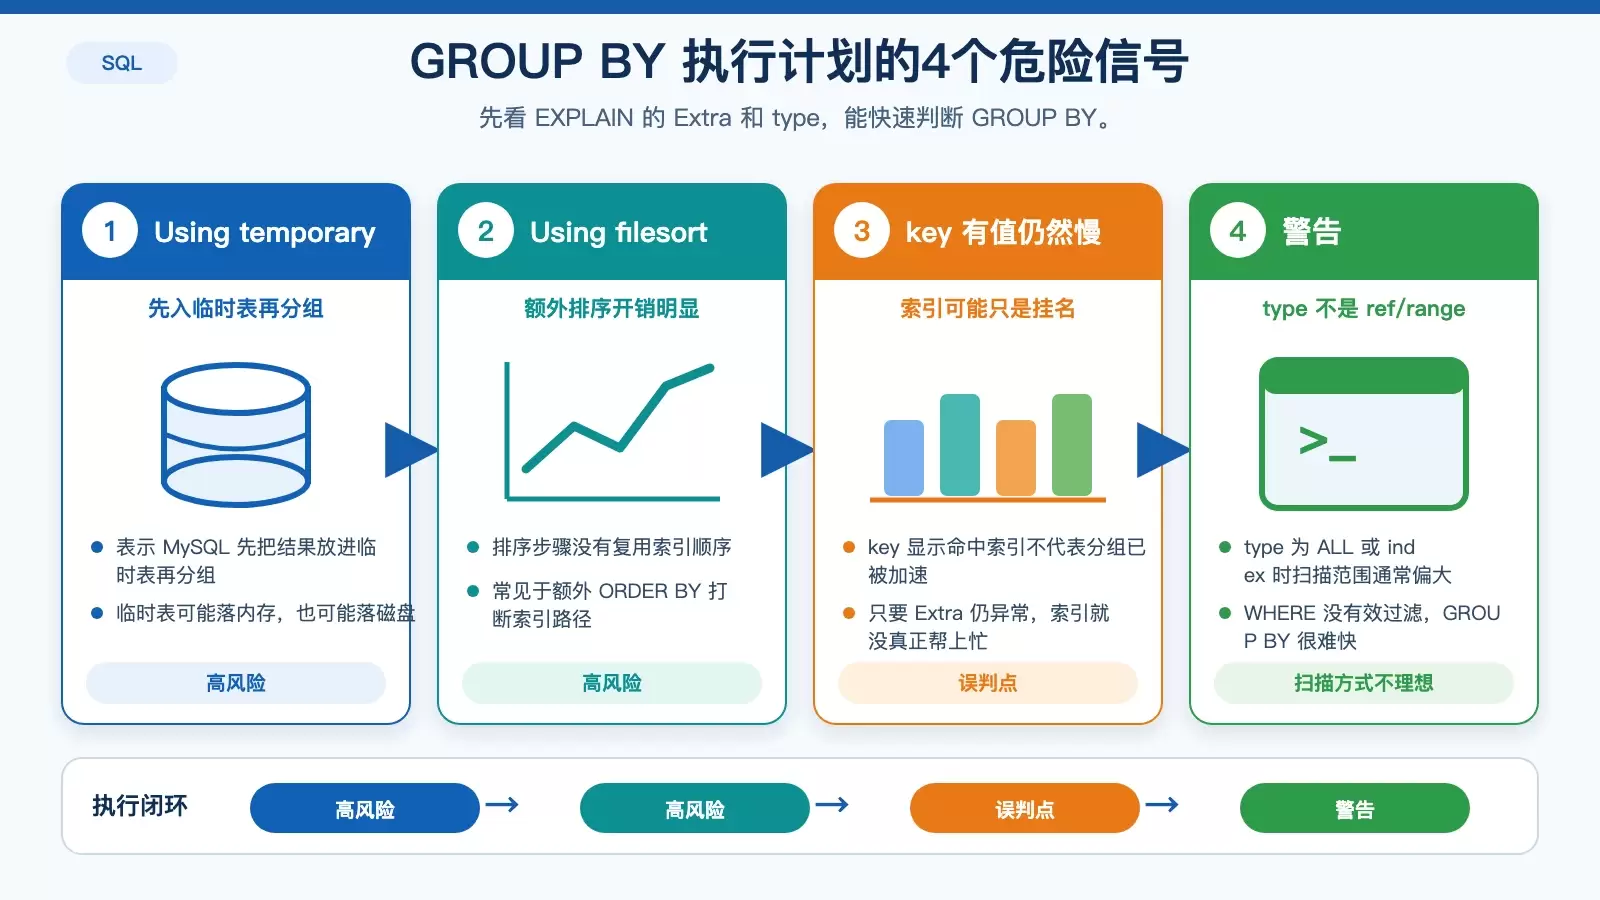
GROUP BY 查询变慢,常见根因不是数据量大,而是执行计划没走上正确的索引路径。排查时先看 EXPLAIN 的 Extra 列,再结合联合索引顺序、覆盖情况、类型转换和 DISTINCT 替代场景逐项定位。 遇到 GROUP BY 查询变慢时,很多优化都停留在“补个索引试试”这一层,结果往往不稳定。