


Rust 在内存安全上比 C/C++ 省心很多,但“省心”不等于“不会出问题”。在 Linux 环境里,真正麻烦的往往不是内存越界,而是程序能跑、编译也通过,可堆内存就是悄悄涨上去,最后只能靠工具和代码审查一点点定位。
这篇文章把 Linux 下排查 Rust 内存泄漏的常见办法拆成几类:先看适合直接抓泄漏的工具,再看适合分析内存增长趋势的方法,最后补上 Rust 代码里最容易埋坑的位置。看完你可以更快判断:当前问题该先跑 Valgrind、换 heaptrack,还是先回头检查 Rc/Arc、unsafe 和手动泄漏实验。
为什么 Rust 里仍然会出现内存泄漏
Rust 的所有权、借用检查和析构机制,确实能挡住大量传统内存问题,但它并不会自动替你发现“对象没有被释放”这类逻辑性错误。换句话说,编译器能保证很多事情是安全的,却不会直接提示“这块堆内存本来应该回收,但现在永远留住了”。
Rust 程序里常见的泄漏来源主要有几类:
Rc或Arc形成循环引用,导致引用计数始终不归零。Box、堆上集合或其他资源被有意或无意地“遗忘”。unsafe代码块里手动管理内存,绕开了正常释放路径。- 程序并非严格意义上的“泄漏”,而是某些分配热点持续增长,表现得像泄漏。
因此,排查时通常不能只靠一种手段,而是要把“直接查未释放内存”和“分析堆使用模式”结合起来看。
先用 Valgrind 和 heaptrack 做动态检测
如果你已经怀疑程序存在真实泄漏,最直接的办法还是从运行期工具入手。它们能在程序执行时记录分配与释放行为,帮你先确认问题是否存在,再进一步定位代码路径。
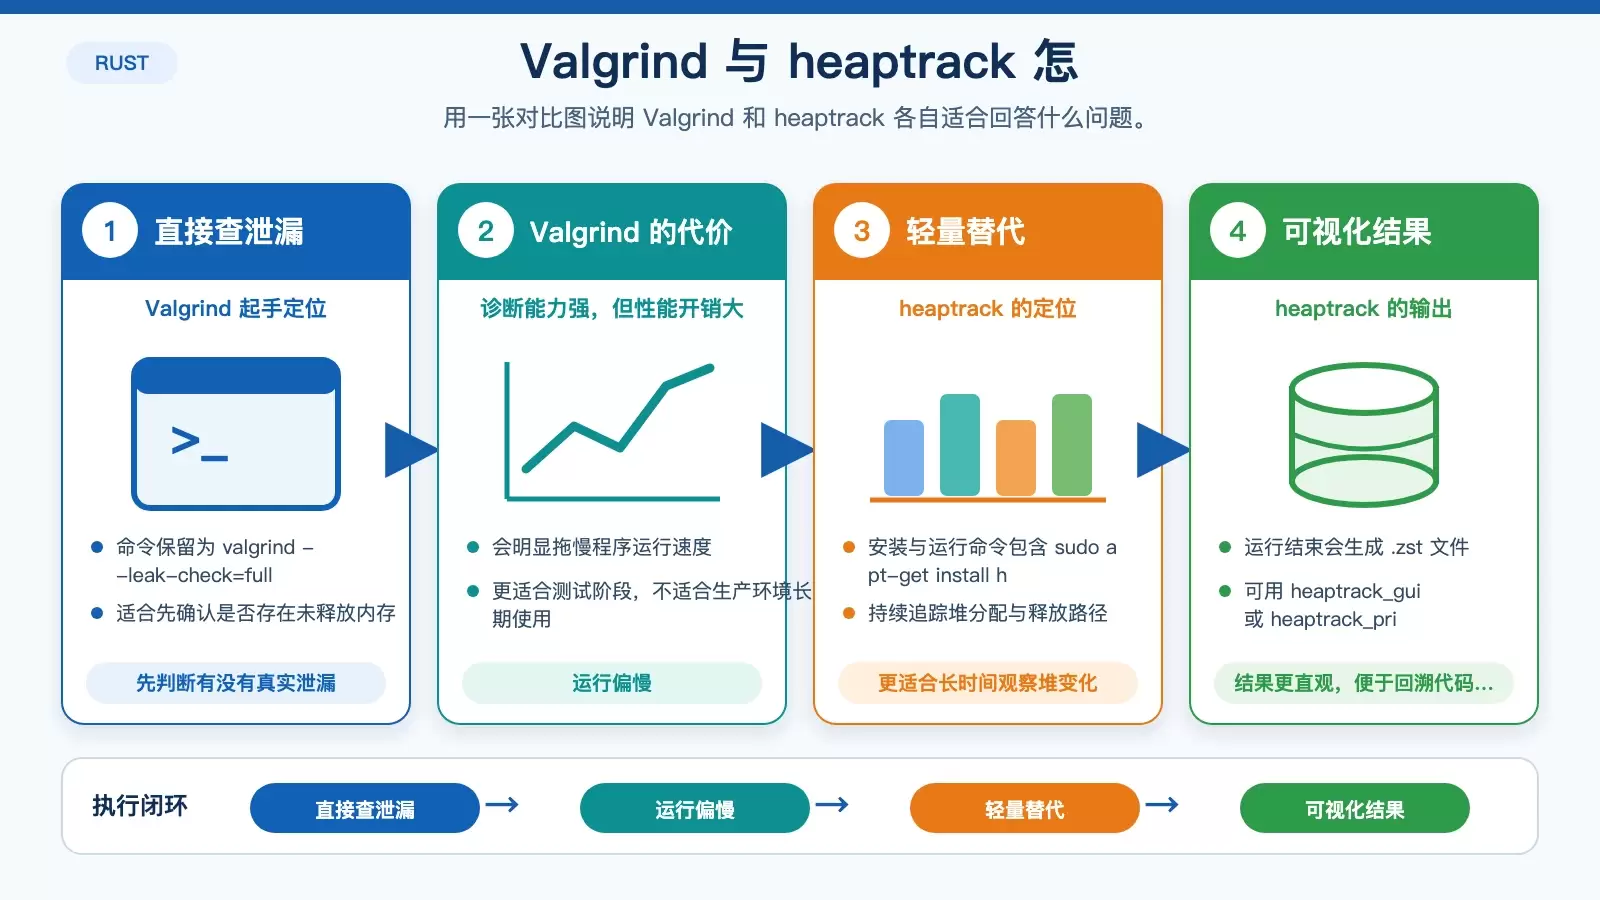
Valgrind:优先确认有没有未释放内存
Valgrind 是 Linux 上排查内存问题的老牌工具,其中 Memcheck 对 Rust 程序同样适用。最常见的起手命令就是:
valgrind --leak-check=full ./your_rust_program加上 --leak-check=full 后,可以更详细地看到哪些内存分配之后没有被释放。它的优点是通用、结论直接,适合在测试环境里先判断“到底是不是泄漏”。
代价也很明显:Valgrind 会让程序运行速度慢很多,所以更适合测试阶段和问题复现阶段,不适合直接拿到生产环境长期跑。
heaptrack:更轻量地追踪堆分配
如果你觉得 Valgrind 太重,heaptrack 往往是更容易落地的替代方案。它会持续追踪堆内存的分配与释放,并生成可视化分析结果。
sudo apt-get install heaptrack
heaptrack ./your_rust_program
程序运行结束后会生成一个 .zst 文件,你可以用 heaptrack_gui 或 heaptrack_print 查看结果。它比较适合回答这类问题:到底是哪段代码在频繁分配,哪些分配最终没有回收,或者哪些路径让内存越跑越高。
实际使用上,可以把它理解为介于“查真实泄漏”和“看整体堆使用习惯”之间的工具,尤其适合排查长期运行服务里的异常增长。
分析内存增长趋势:massif 与 cargo-profiler
有些问题并不是单个对象没释放,而是某段逻辑持续堆积内存,最终表现得像泄漏。这时,单纯看“有没有未释放块”还不够,还得看堆内存随时间是怎么变化的。
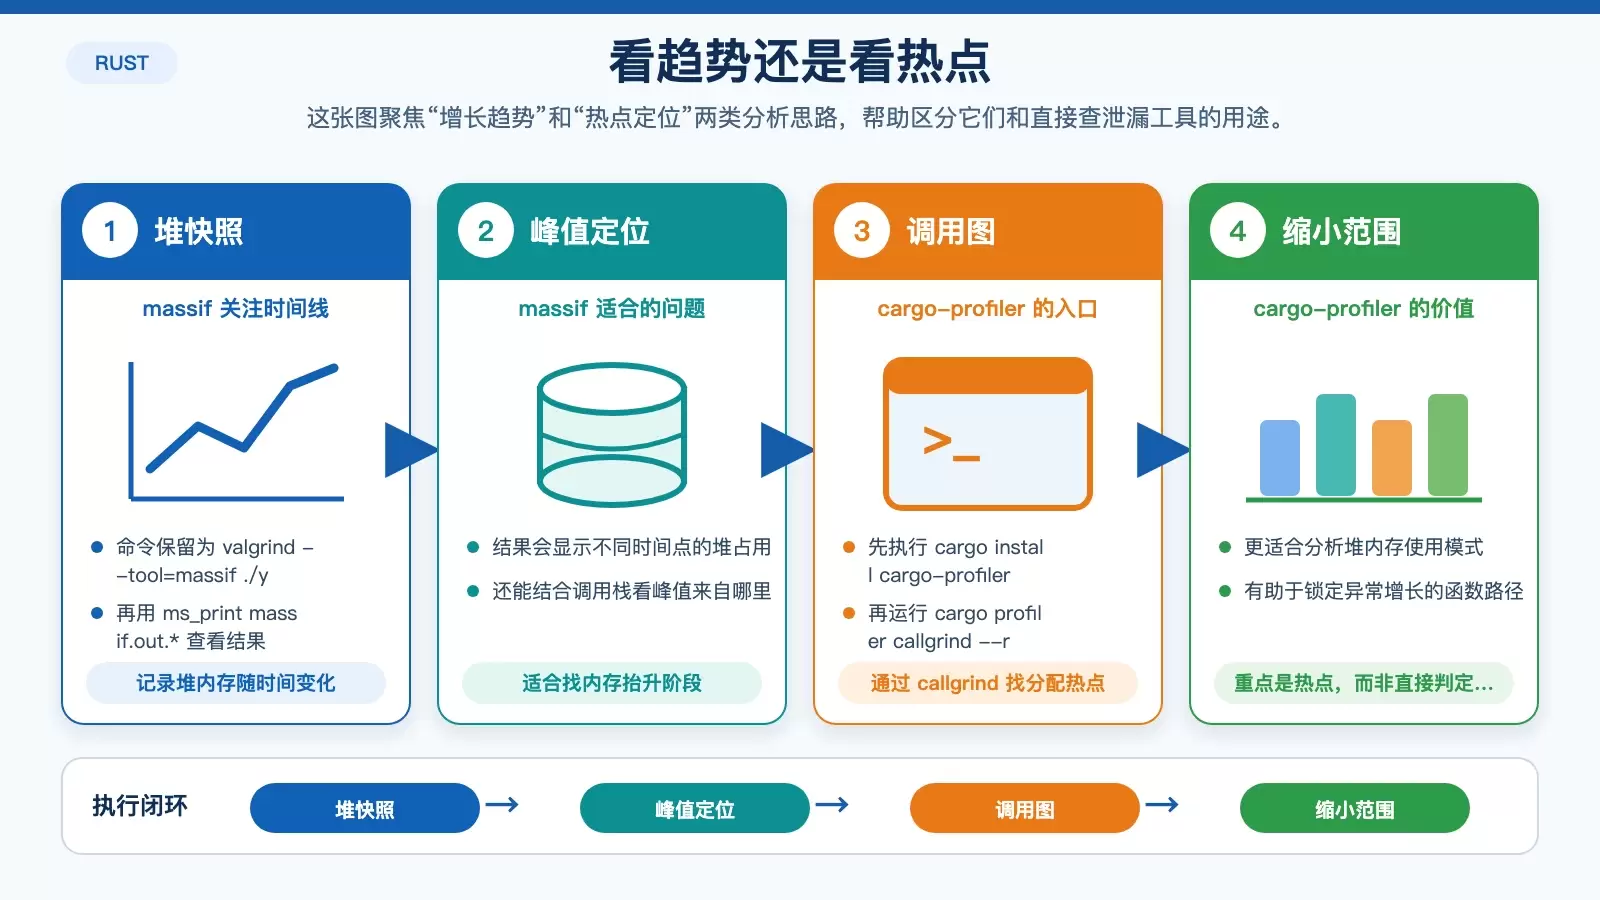
massif:看堆内存峰值出现在什么阶段
massif 是 Valgrind 家族里专门做堆分析的工具。它会记录程序执行过程中的堆内存快照,帮助你观察内存峰值和增长路径。
valgrind --tool=massif ./your_rust_program
ms_print massif.out.*
ms_print 输出里会展示不同时间点的堆占用,以及对应的调用栈信息。它的价值不在于直接告诉你“这里泄漏了”,而在于让你看清:内存是在哪个阶段开始明显抬升的,峰值由哪些调用路径造成。
cargo-profiler:借助 callgrind 找分配热点
Rust 生态里也有更贴近开发流程的工具。比如 cargo-profiler 虽然本质上是性能分析工具,但可以通过 callgrind 后端辅助做内存分析,适合定位调用图里的分配热点。
cargo install cargo-profiler
cargo profiler callgrind --release
这种方式更适合分析“堆内存使用模式”而不是直接判定泄漏。它能帮助你看清哪些函数路径分配最重、哪些调用在 --release 构建下仍然表现异常,从而缩小排查范围。
rust-analyzer:更偏预防的静态提示
rust-analyzer 是 Rust 语言服务器,集成在 IDE 里后,可以提供一定的静态分析提示。它不能替代运行期工具,但在编码阶段能帮助你更早发现一些高风险模式,比如循环引用、未妥善处理的智能指针使用等。
更准确地说,它属于“编码期预防”而不是“运行期检测”。如果你已经遇到线上或测试环境中的内存增长,仅靠它还不够,但拿来做日常自检很有价值。
代码审查时重点盯这几类高风险点
工具再强,也替代不了手动检查。尤其在 Rust 里,很多泄漏都和语言特性本身有关,不回到代码结构上看,很难真正解决。
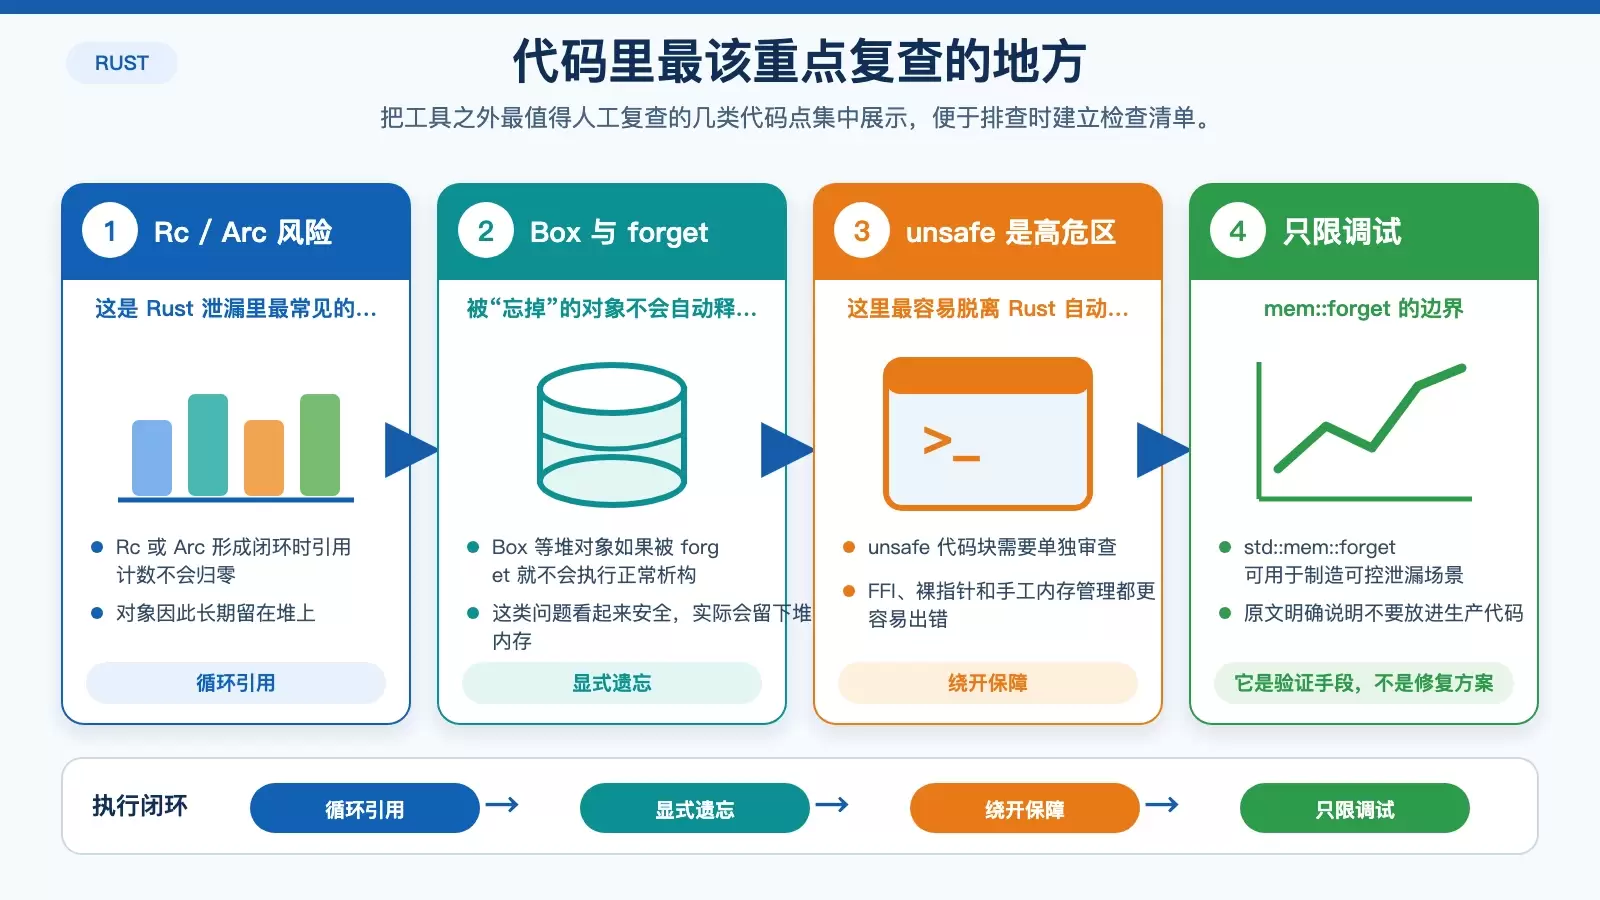
智能指针:重点看 Rc、Arc、Box
手动审查时,首先要看 Rc、Arc 和 Box 的使用方式:
Rc/Arc如果形成循环引用,引用计数会永远不为零,对象自然不会释放。Box本身并不危险,但如果对象被forget或通过其他方式泄漏,堆内存就会一直留存。- 一些“看起来只是缓存”的结构,如果没有退出策略,也可能长期持有大量堆数据。
unsafe 代码块:最容易绕开正常释放逻辑
所有 unsafe 代码块都值得单独过一遍。因为一旦进入手动管理内存的路径,你就已经绕开了 Rust 原本最有价值的自动保障。很多难查的问题,最终都出在 FFI、裸指针、手工分配释放或自定义内存布局处理上。
如果工具报告给出的调用栈落在这些区域附近,优先级通常应该直接拉高。
用 std::mem::forget 做定向验证,但不要带进生产
有时候你怀疑某个对象没有按预期释放,可以在调试中故意用 std::mem::forget 把它“忘掉”,借此观察程序行为。这不是修复手段,而是一种定向验证思路。
use std::mem;

struct MyStruct {
    data: Vec<i32>,
}

fn main() {
    let my_struct = MyStruct { data: vec![1, 2, 3] };
    mem::forget(my_struct); // 强制忘记对象
}
这种做法的意义在于制造一个可控泄漏场景,用来帮助判断资源生命周期是否和预期一致。原文中的判断思路是:如果程序在 forget 之后运行正常,说明这类泄漏未必立刻导致崩溃;如果 forget 后出现异常,可能说明其他资源处理路径也存在问题。
但要注意,std::mem::forget 本身就是在故意阻止析构执行,所以只能作为调试实验,不能保留在生产代码里。
实际排查时怎么选工具更高效
如果你只想快速确认程序是不是有真实泄漏,通常先跑 Valgrind 的 Memcheck 最直接;如果程序太重、想更轻量地看堆分配和未释放路径,可以转向 heaptrack;如果问题更像“内存持续增长但不确定是不是泄漏”,那 massif 和 cargo-profiler 更适合看趋势和热点。
与此同时,不要忽略代码审查。很多 Rust 内存问题并不是工具本身查不出来,而是结果已经给了线索,但如果不了解 Rc/Arc 的循环引用、unsafe 的风险边界,最终还是很难落到具体修复点上。
总结来看,Linux 上检测 Rust 内存泄漏,比较稳妥的做法不是押注单一工具,而是把 Valgrind、heaptrack、massif 等运行期工具和 Rust 代码审查结合起来。Rust 很安全,但“安全”从来不等于“万无一失”。









