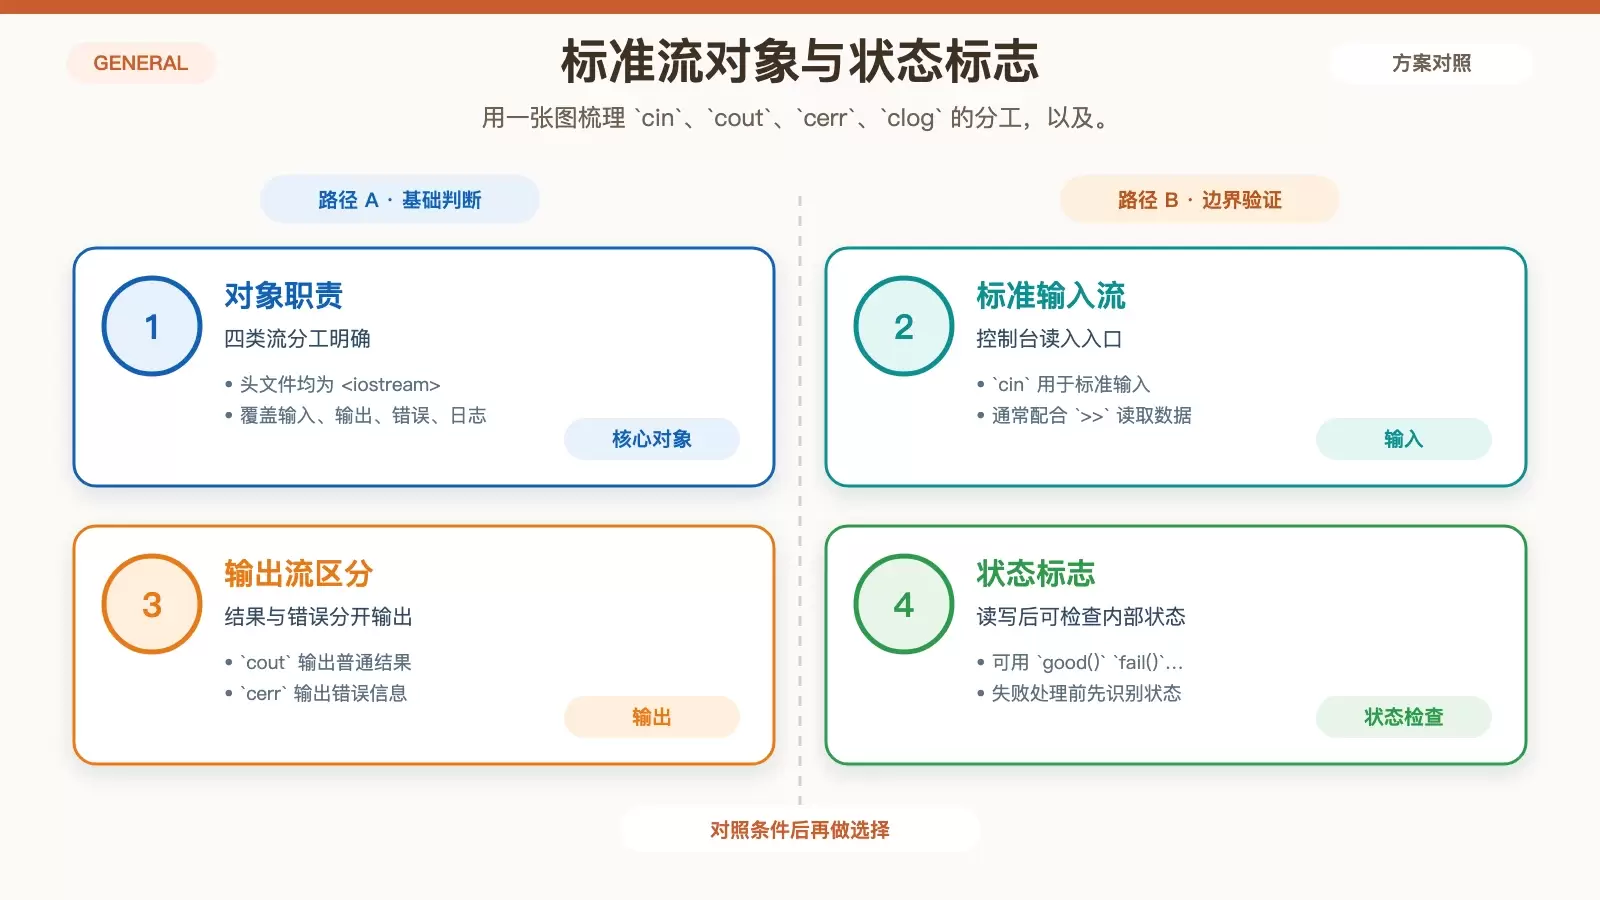
如何正确使用 C++ 标准流对象
这篇文章围绕 C++ 标准流对象的实际用法,梳理了 `cin`、`cout`、`cerr`、`clog` 的职责差异,以及输入、输出、格式化和错误处理的关键写法。读完可以快速判断不同场景该选哪类流、哪些状态需要检查,以及常见操纵符该怎样搭配使用。
2026-08-24
196

这篇文章围绕 C++ 标准流对象的实际用法,梳理了 `cin`、`cout`、`cerr`、`clog` 的职责差异,以及输入、输出、格式化和错误处理的关键写法。读完可以快速判断不同场景该选哪类流、哪些状态需要检查,以及常见操纵符该怎样搭配使用。
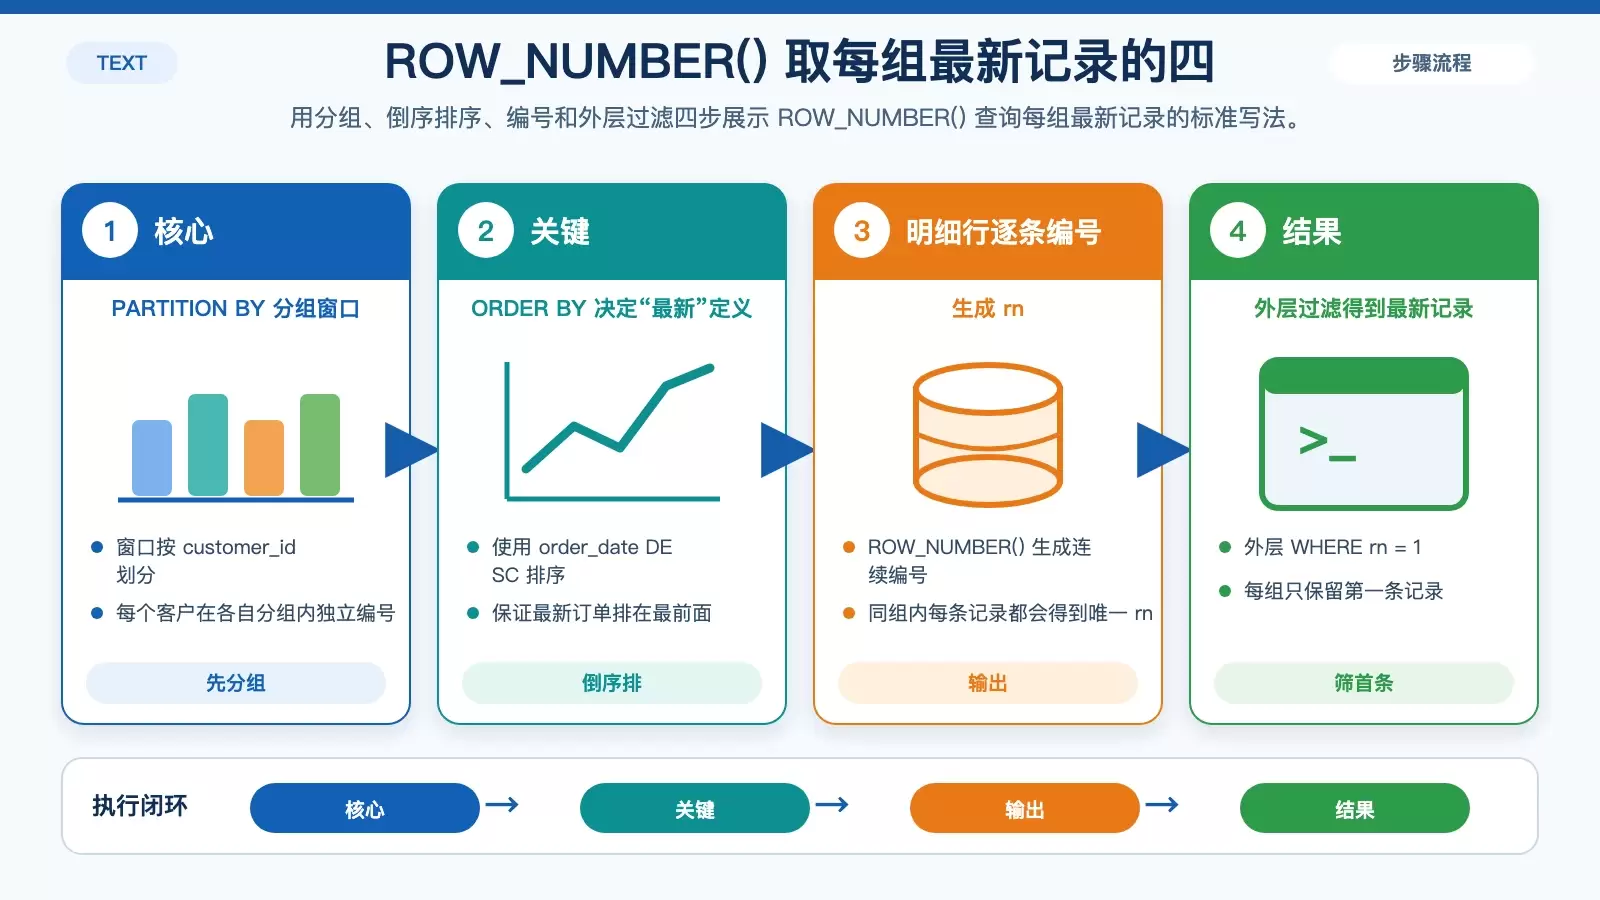
在 Oracle 21c 里,想查“每组最新一条记录”,核心不是单独使用 ROW_NUMBER(),而是先按分组键和时间等“新旧字段”做窗口排序,再取编号为 1 的行。本文同时说明它为何不能直接和 GROUP BY 混用、并列记录该换用什么函数,以及索引应如何配合。
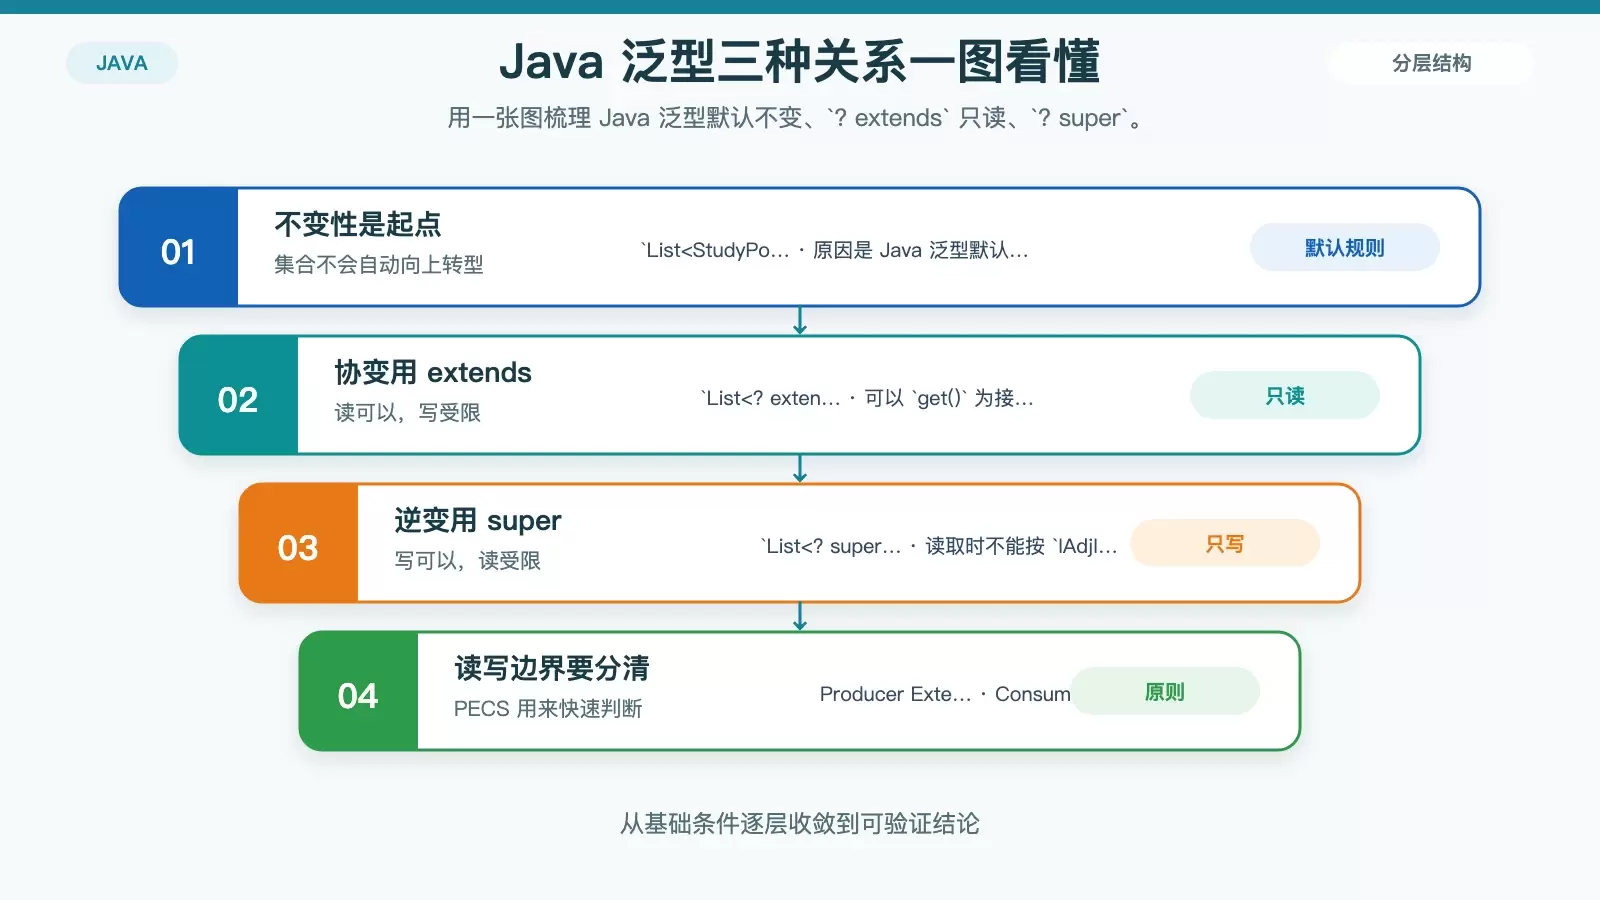
文章围绕 Java 中最常见的一类泛型报错展开:为什么 `StudyPoint implements IAdjIniPoint`,却仍然不能把 `List ` 直接当成 `List ` 使用。文中会拆开不变性、`? extends`、`? super` 与 PECS 的实际含义,并补充和 C# 在协变支持上的关键差异。 在 Java 里,`StudyPoint` 实现了 `IAdjIniPoint`,但 `List ` 依然不能赋给 `List `,根因是泛型默认不变。处理这类问题时,先区分读还是写:只读用 `? extends`,只写用 `? super`,需要真正的接口类型列表就用 `new ArrayList(studyPoints)`,如果还在设。
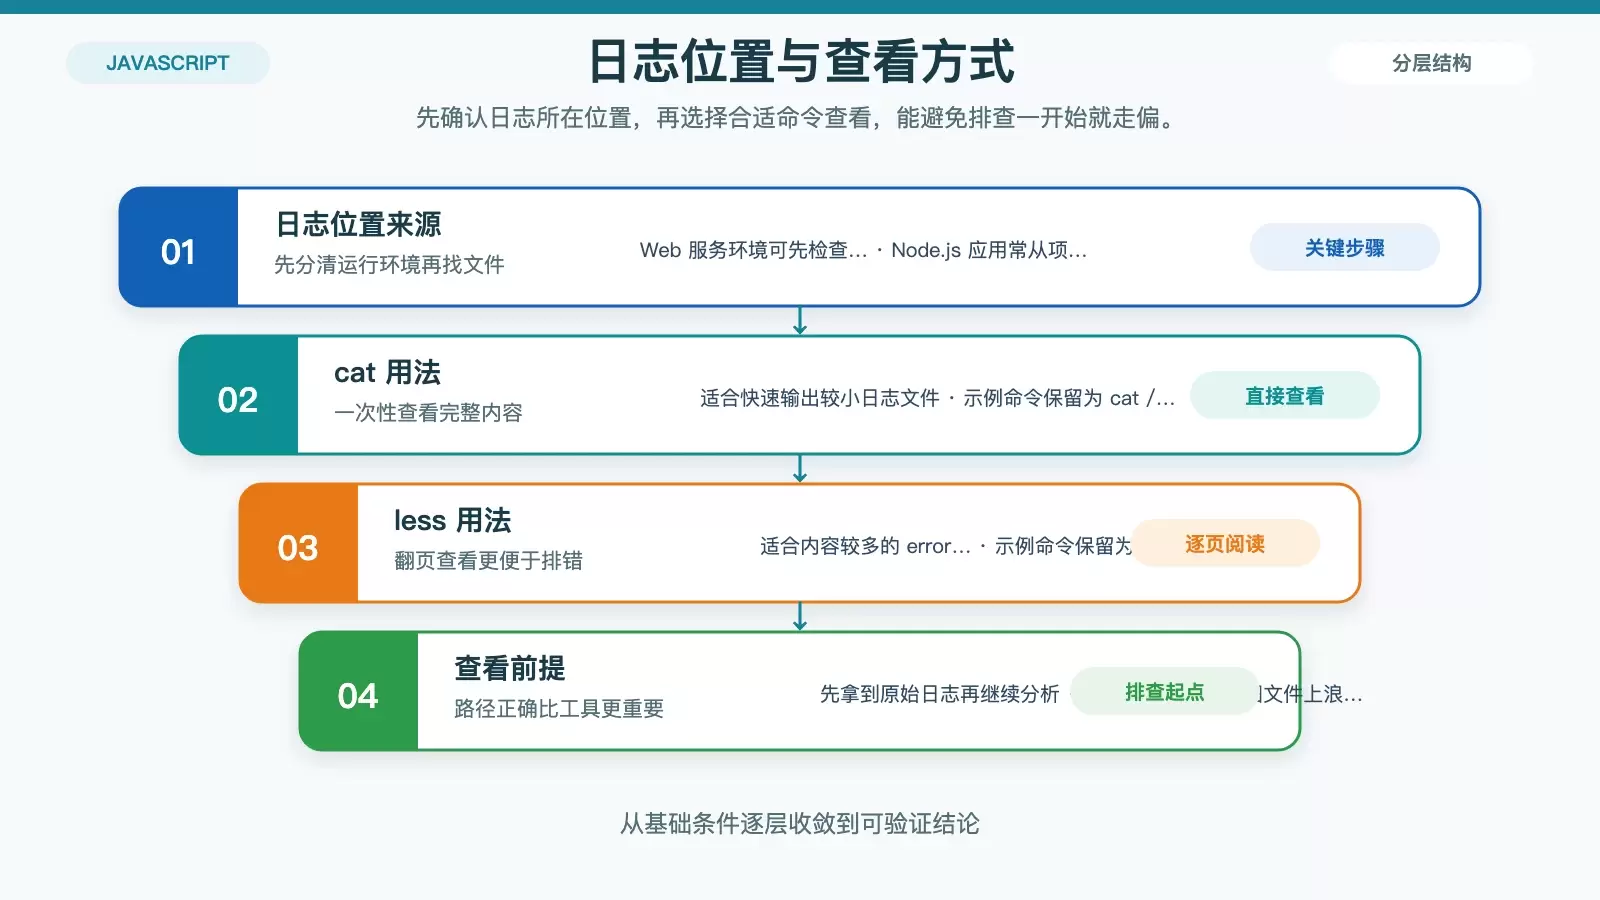
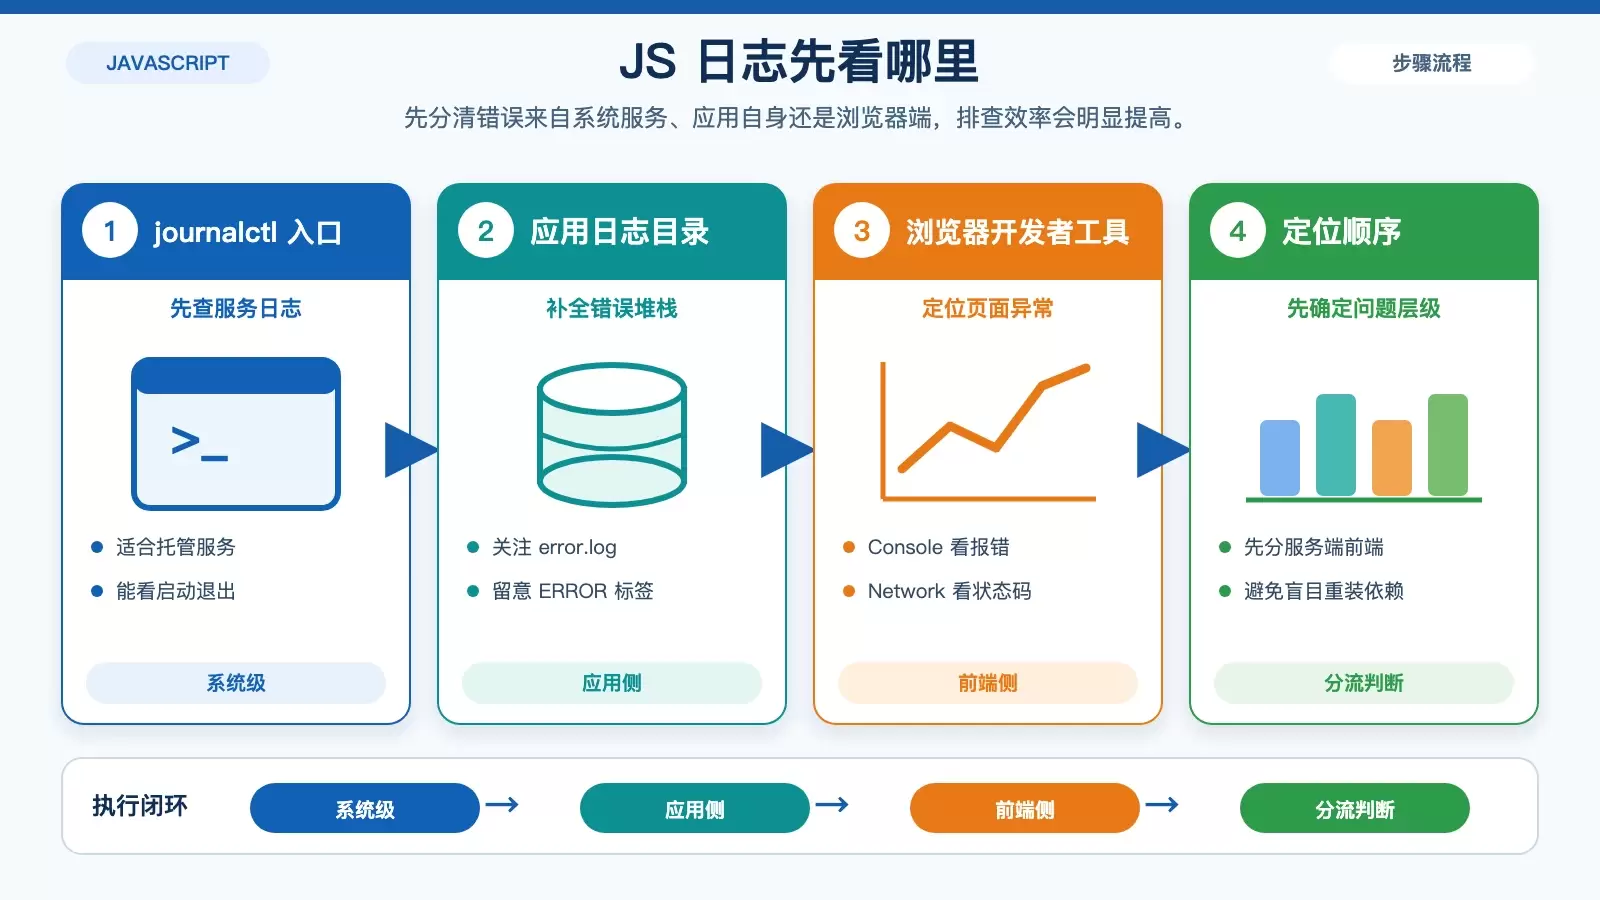
在 CentOS 上排查 JavaScript 报错,关键不在“会不会看日志”,而在于能否按顺序完成定位、分析和修复。本文把日志位置、查看命令、报错字段判断、代码修复以及后续监控整理成一套简明流程,适合 Web 服务和 Node.js 应用快速参照。
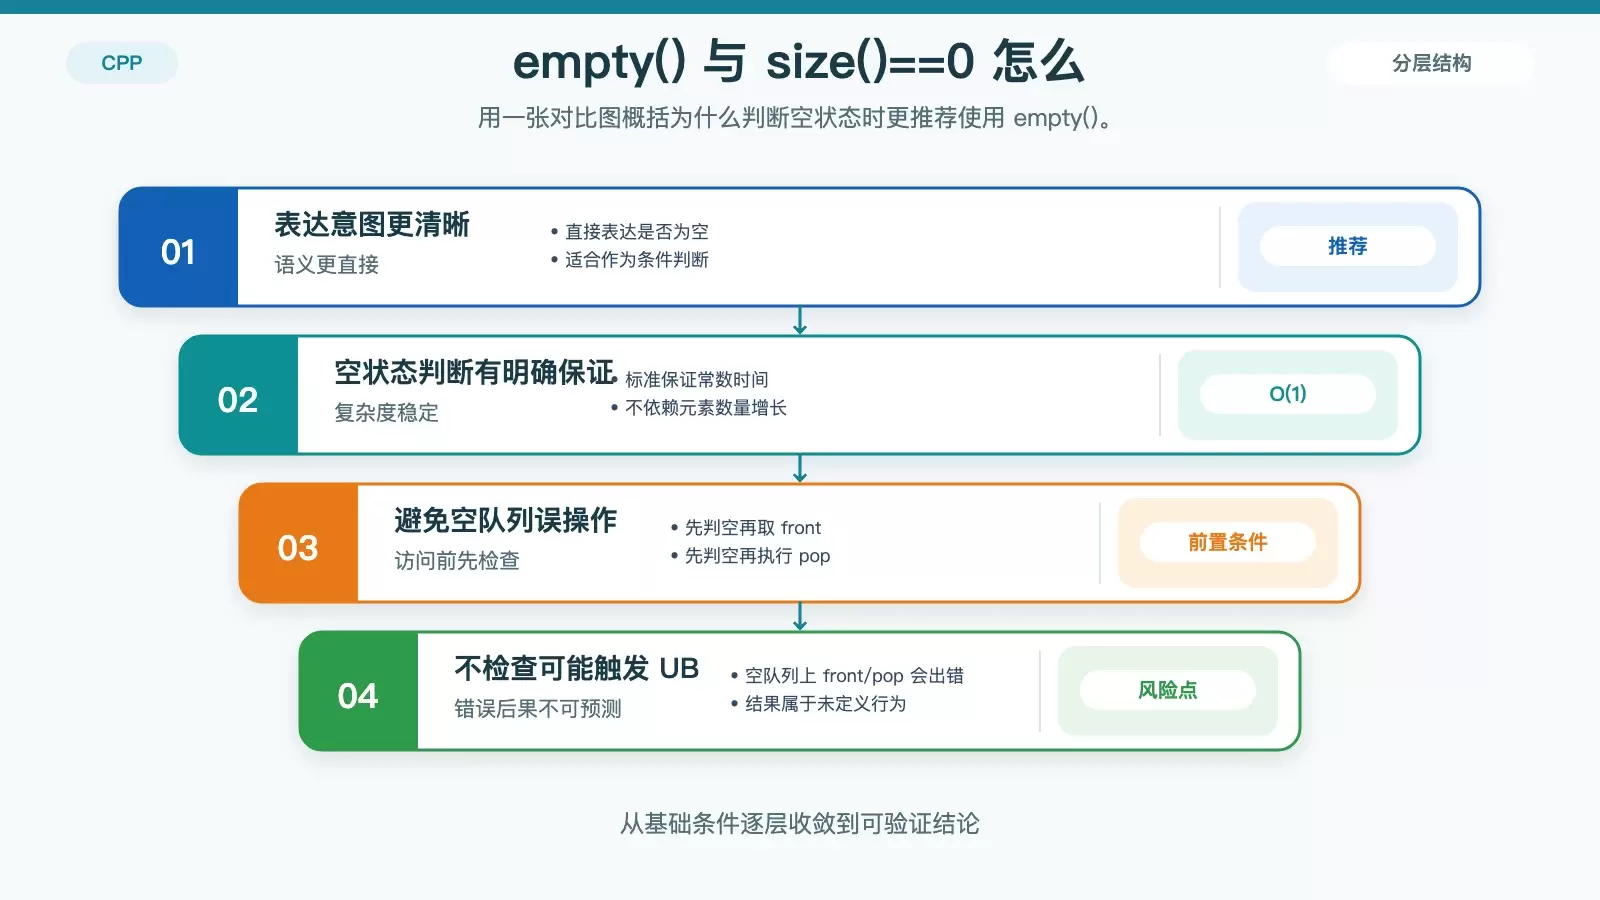
`std::queue::empty()`看起来只是一个布尔判断,但它关系到代码可读性、接口语义和运行安全。本文从 STL 设计、典型用法、多线程陷阱和底层实现几方面展开,说明为什么判断队列是否为空时,优先使用 `empty()` 而不是 `size() == 0`。
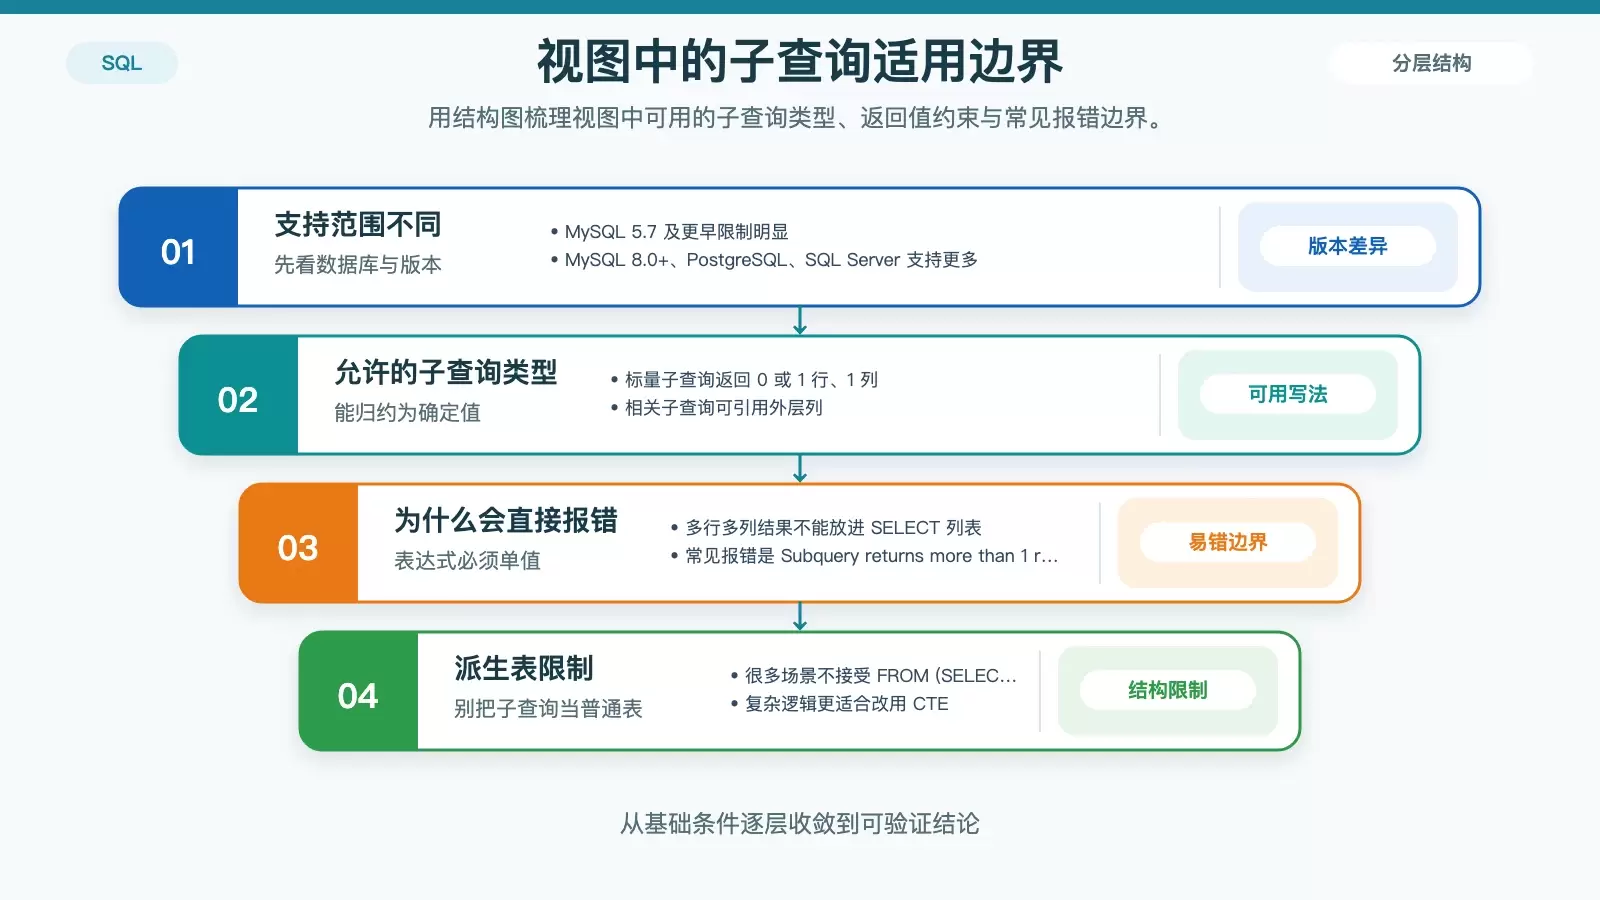
在 SQL 视图中使用子查询并非一律可行,关键在于数据库版本、子查询类型以及优化器的处理方式。本文从能否直接写、何时用 WITH 改写、MySQL 5.7 的替代方案,到常见性能失速原因,梳理出一套更适合落地判断的写法与排查思路。
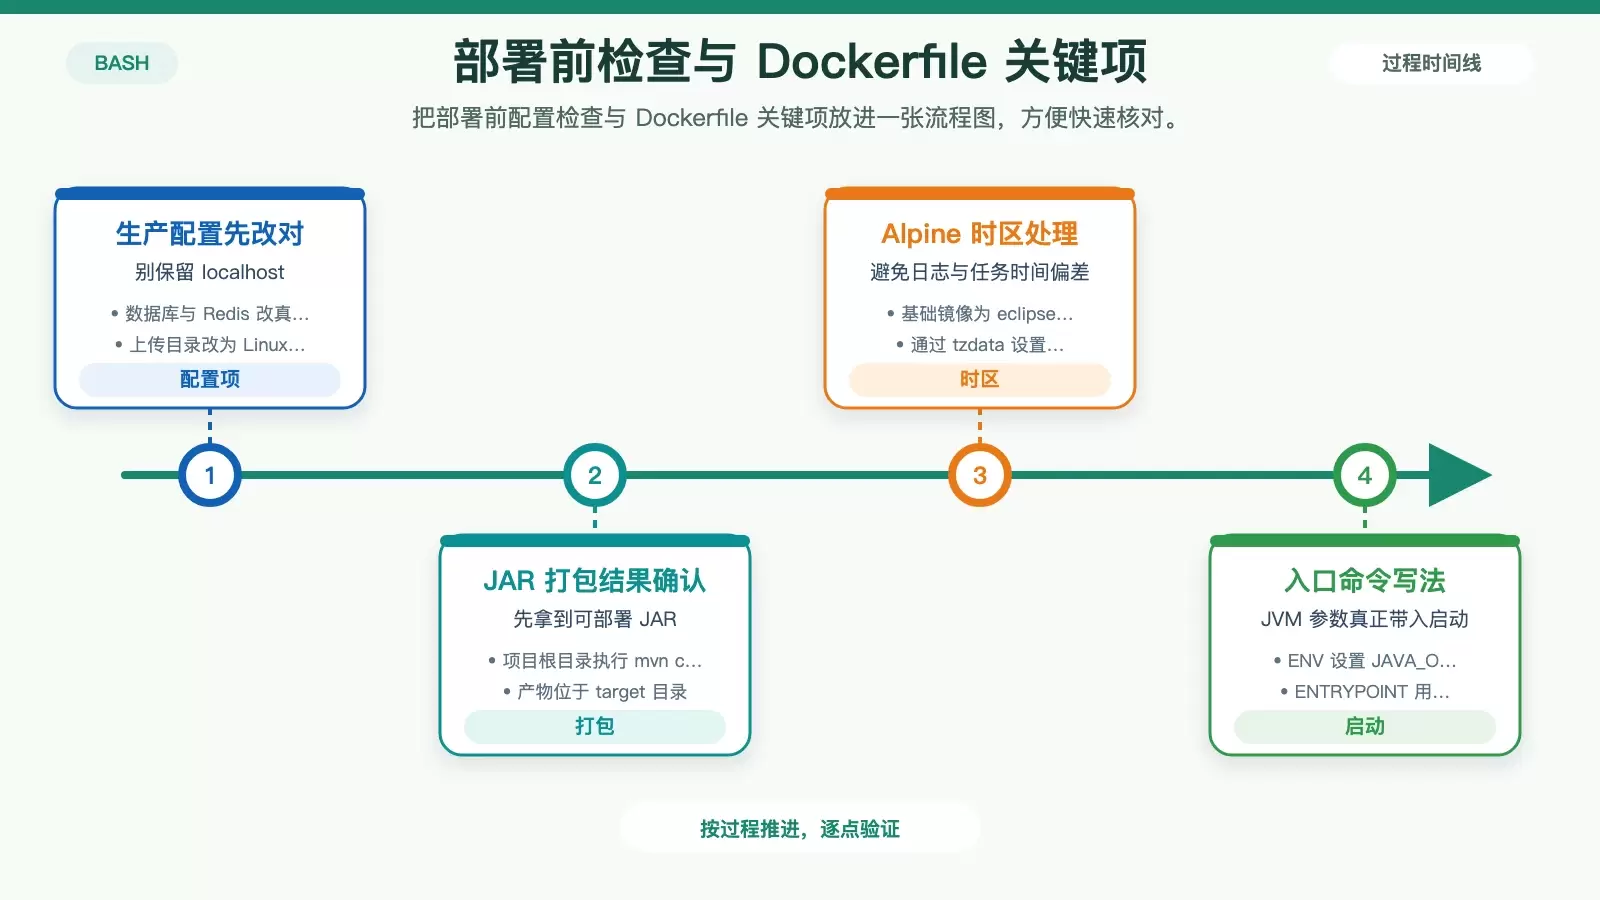
这篇文章把 Spring Boot 项目从打包、编写 Dockerfile、构建镜像到容器运行的关键步骤重新梳理了一遍,并重点解释 Quartz 定时任务因缺表导致启动失败的排查与修复思路。保留原有命令、参数和报错信息,方便直接对照实操。
Ubuntu 下的 JavaScript 日志异常,大多可以归到权限、端口、依赖、语法、引用、类型和内存几类问题。文章按“先定位、再分类修复、最后用工具补强”的顺序,整理出一套更适合 Node.js 服务和前端项目的排查路径。
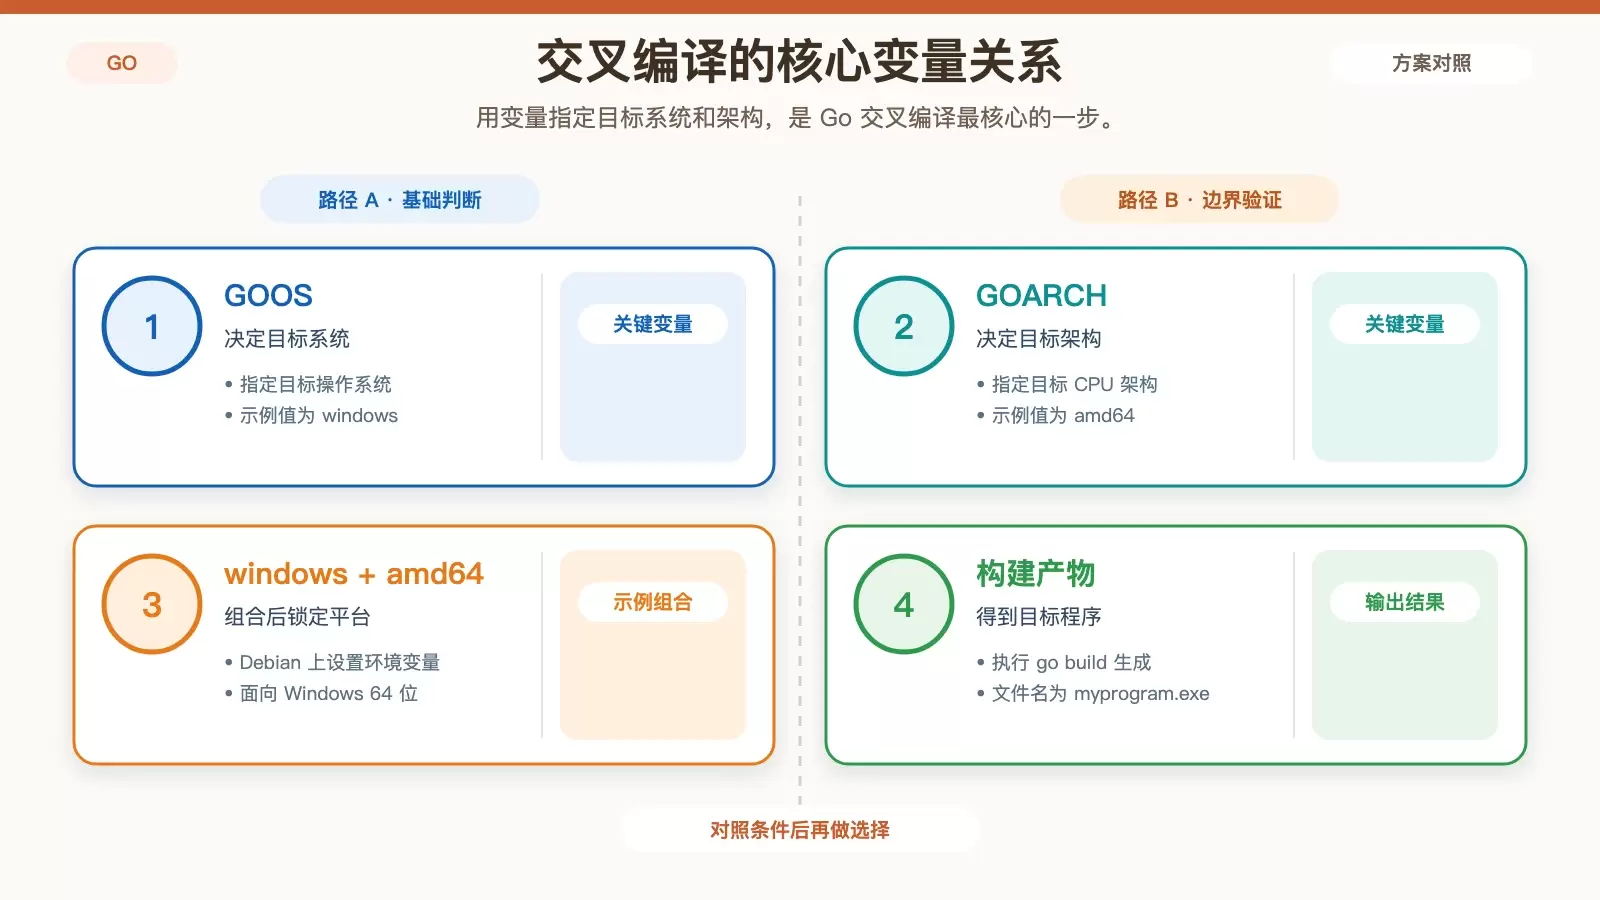
这篇文章把 Debian 上交叉编译 Go 程序的最短路径梳理清楚:先确认 Go 环境,再进入项目目录,通过设置 GOOS 和 GOARCH 指定目标平台,最后用 go build 输出可执行文件。同时也说明了一个常见边界:纯 Go 项目通常够用,但只要依赖 C 库或其他非 Go 组件,就需要额外准备交叉编译工具链。
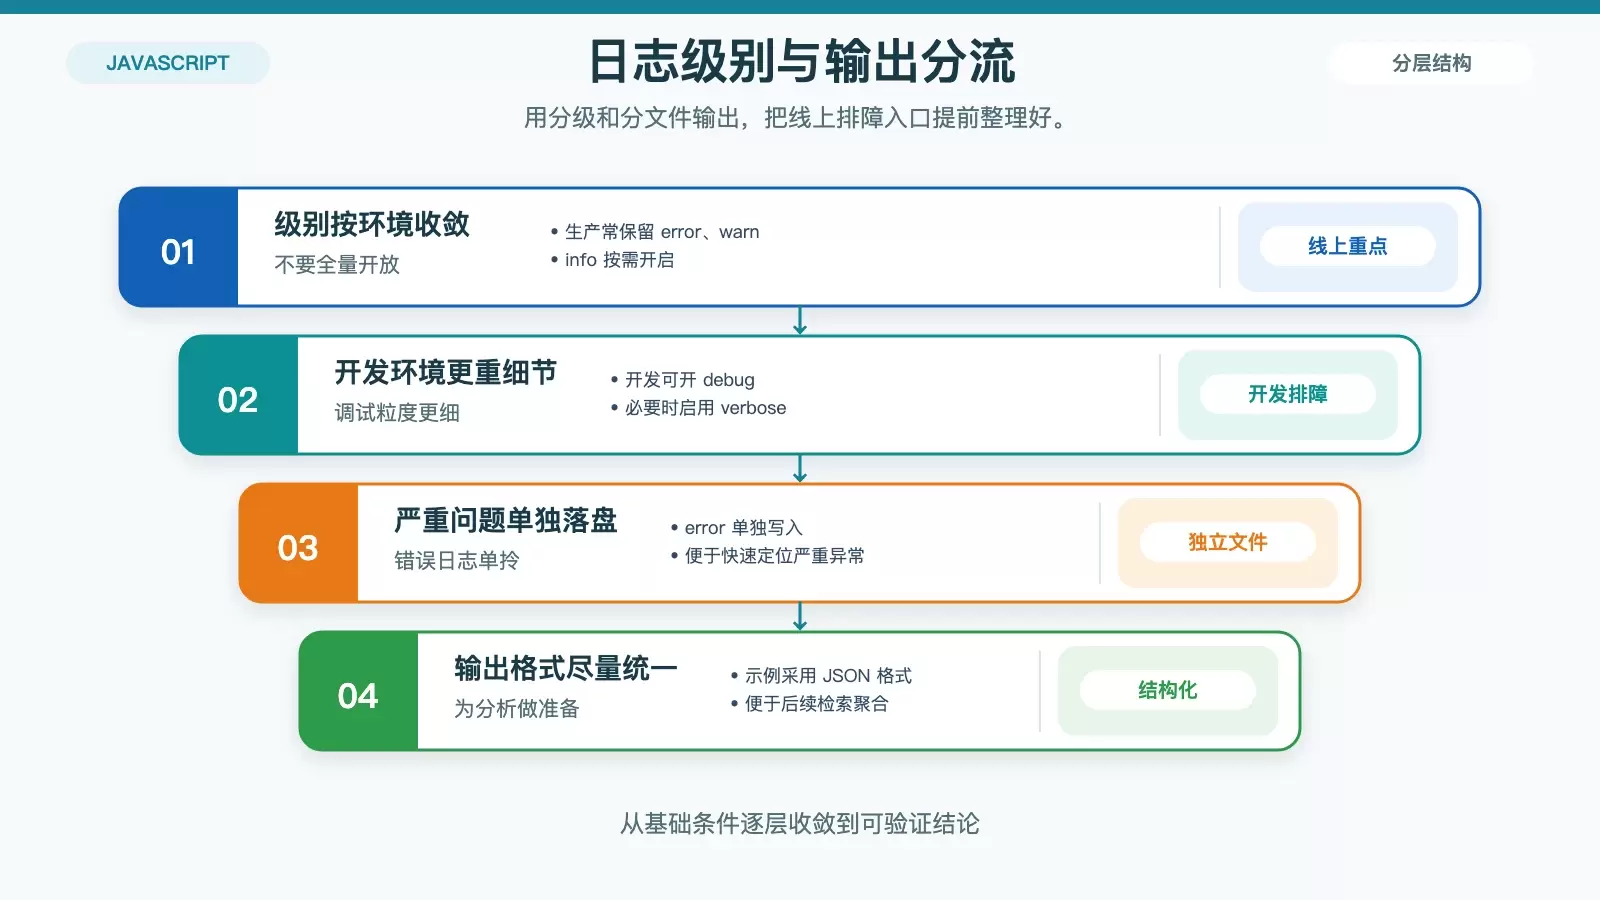
在 Ubuntu 上为 Node.js 应用设计日志策略,关键不在“有没有日志”,而在是否能兼顾性能、排障效率、磁盘占用与安全性。本文从日志库选择、级别配置、轮转分割,到监控分析和权限控制,整理出一套更适合生产环境落地的做法。
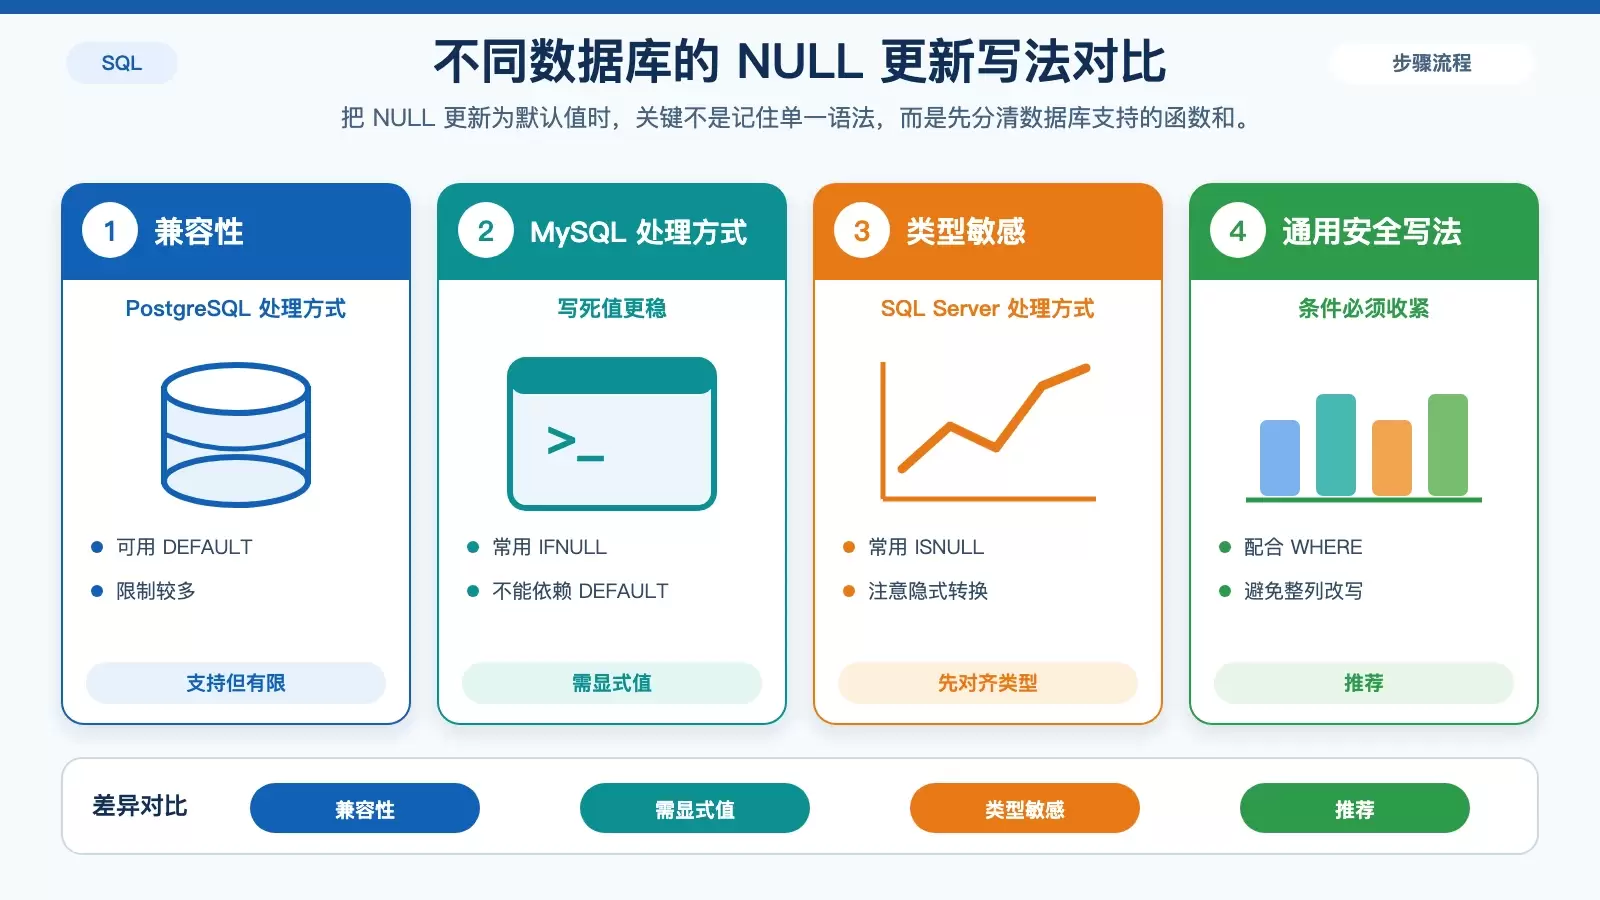
把 SQL 里的 NULL 批量补成“默认值”,难点不在语法本身,而在不同数据库对 DEFAULT、COALESCE、IFNULL、ISNULL 的支持并不一致。本文按更新写法、默认值来源、批量更新防误伤和 JSON/数组字段四个方面,梳理更稳妥的处理方式。
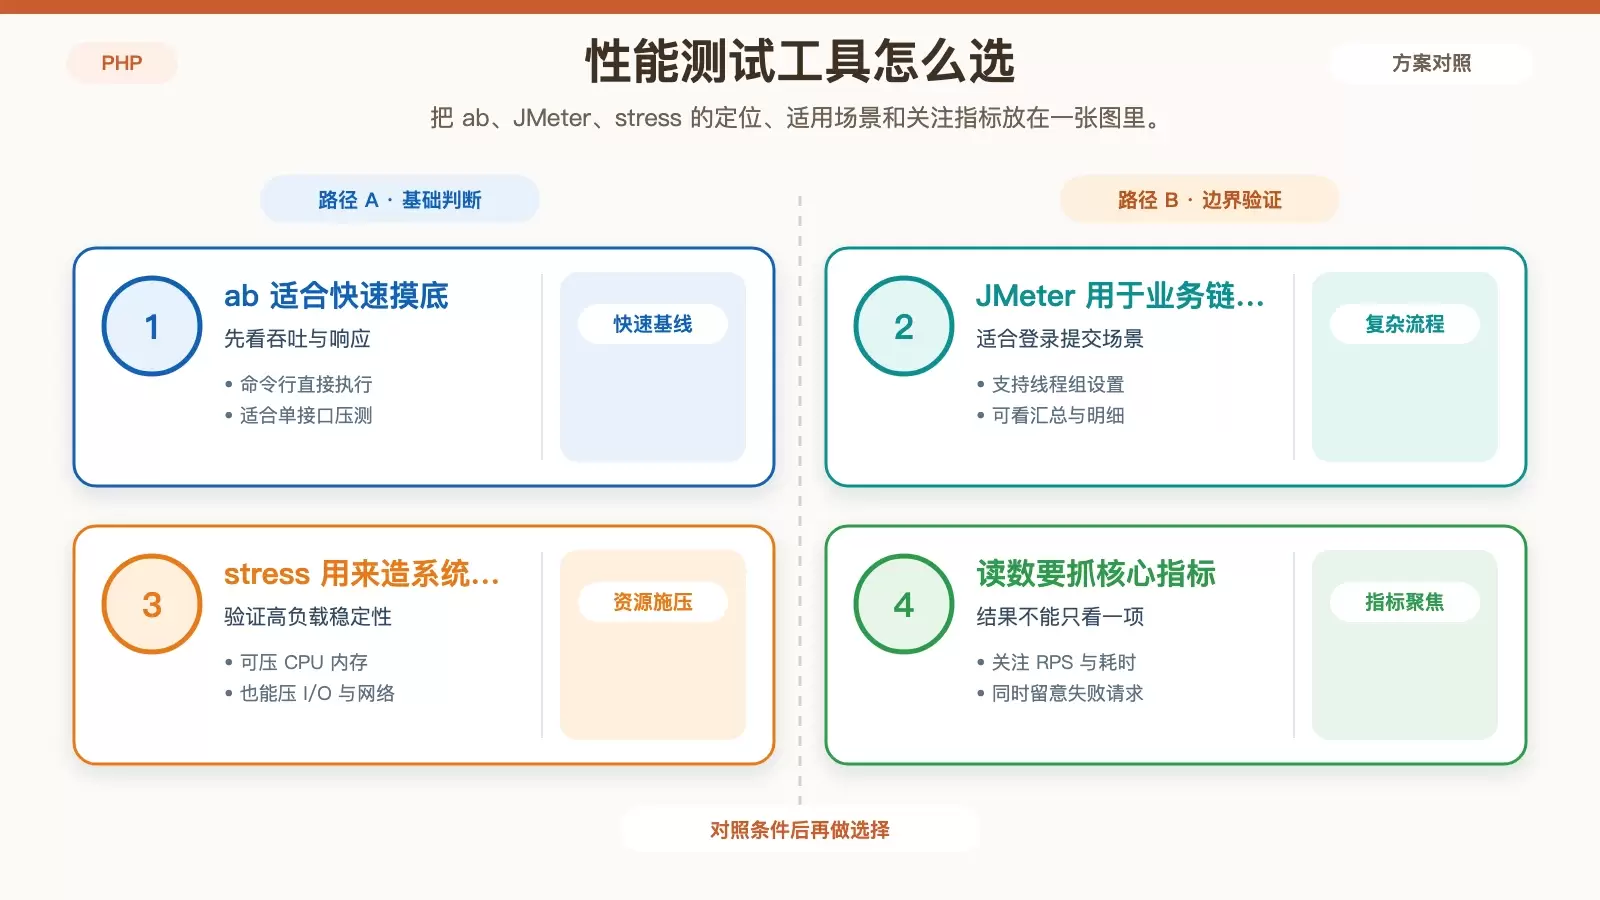
在 CentOS 上给 ThinkPHP 项目做性能测试,重点不只是“跑一遍压测”,而是保证环境一致、场景真实、指标可解释。本文按准备、工具使用、监控分析到优化落地的顺序,整理出一套可直接执行的方法,帮助你判断瓶颈究竟出在接口、系统资源还是数据库。