Go 语言里的 sync.OnceValue:把懒加载写得更直接
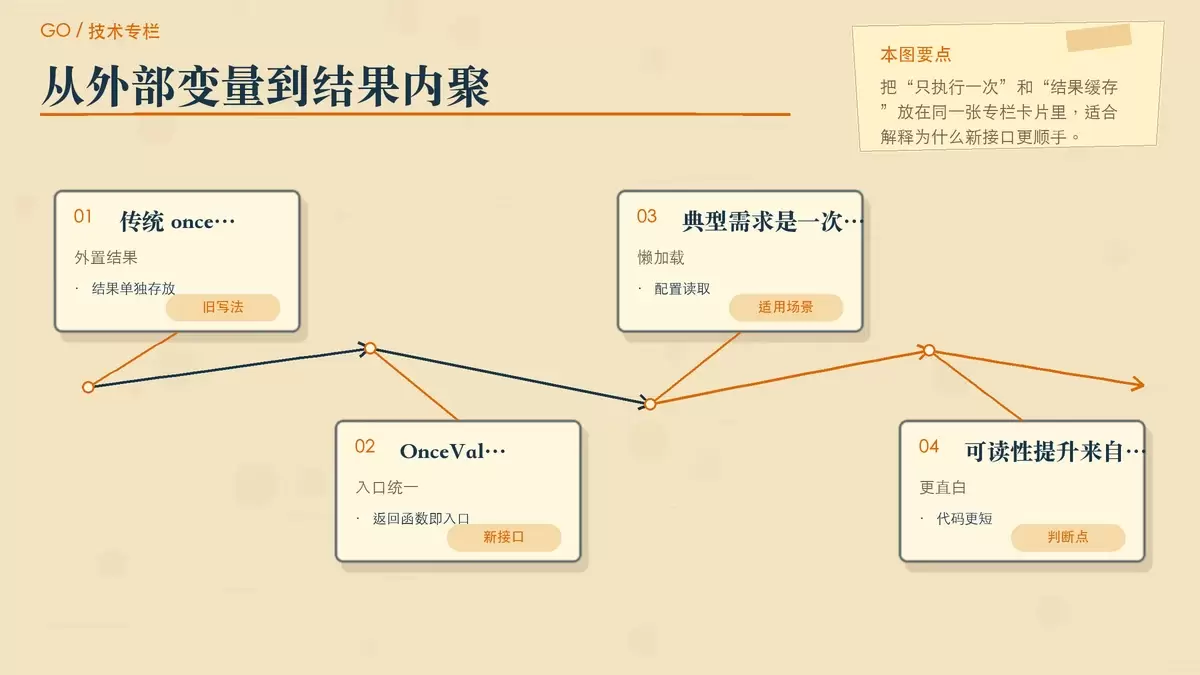
Go 1.21 新增的 sync.OnceValue,把“只执行一次”和“结果缓存”合成了一个更顺手的接口。它适合配置加载、连接初始化和昂贵计算这类懒加载场景,但在 panic 传播和失败重试策略上,和传统 sync.Once 仍有明显差异。
2026-08-25
154

Go 1.21 新增的 sync.OnceValue,把“只执行一次”和“结果缓存”合成了一个更顺手的接口。它适合配置加载、连接初始化和昂贵计算这类懒加载场景,但在 panic 传播和失败重试策略上,和传统 sync.Once 仍有明显差异。
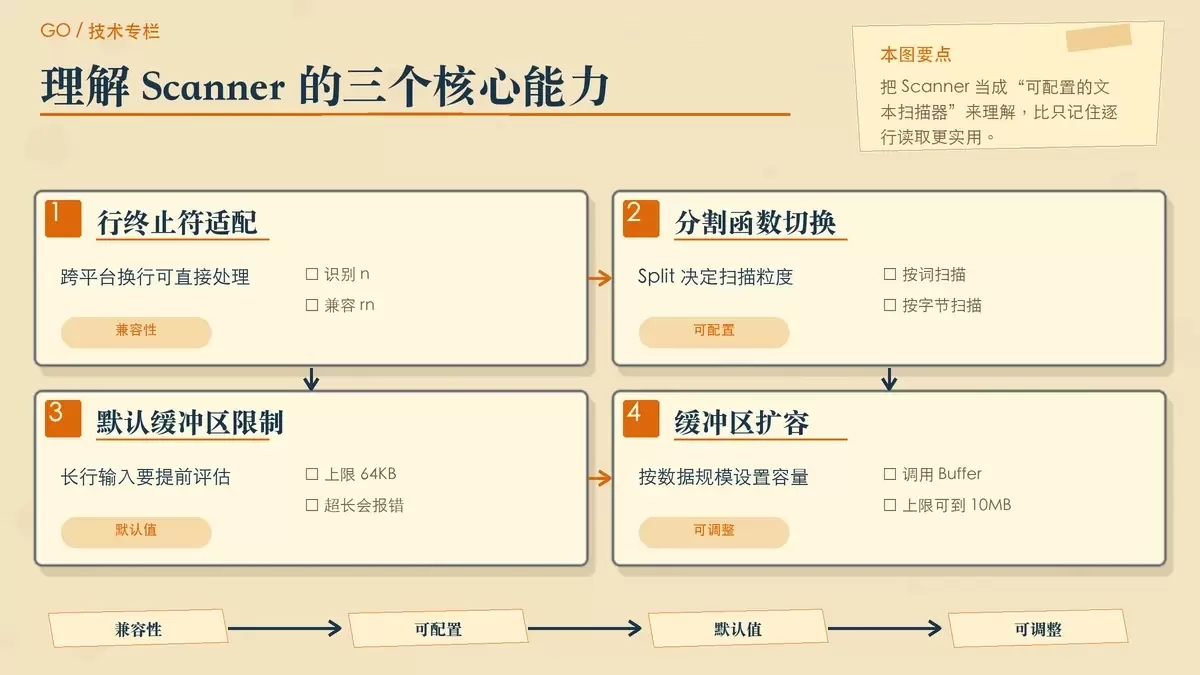
在 Go 里处理文本输入时,`bufio.Scanner` 常被当作“逐行读取工具”使用,但它真正的价值不止于此。本文从为什么要选它、基础用法、缓冲区限制到实际场景与性能取舍,梳理一套更适合工程实践的使用方法。
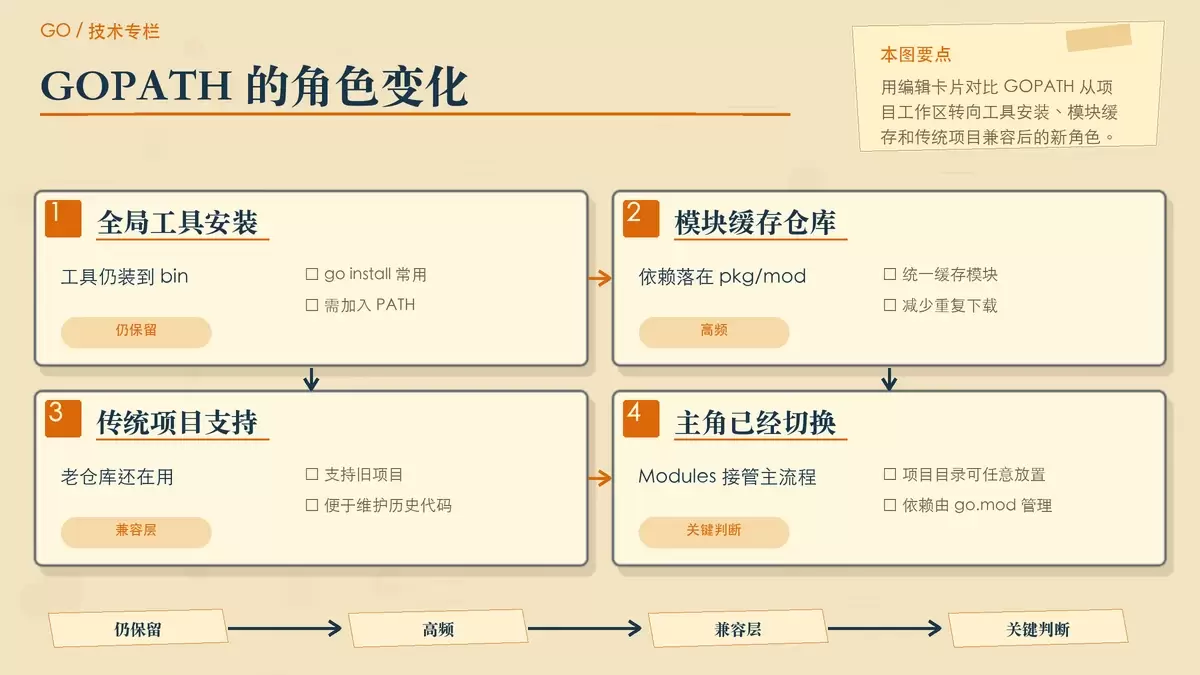
Go Modules 已经取代 GOPATH 成为 Go 项目的默认依赖管理方式,但这并不意味着 GOPATH 失去意义。本文从工作区历史、Modules 带来的变化、GOPATH 在工具安装与模块缓存中的现职,以及多 GOPATH 与环境配置建议几个角度,梳理它在现代 Go 开发中仍然保留的实际价值。
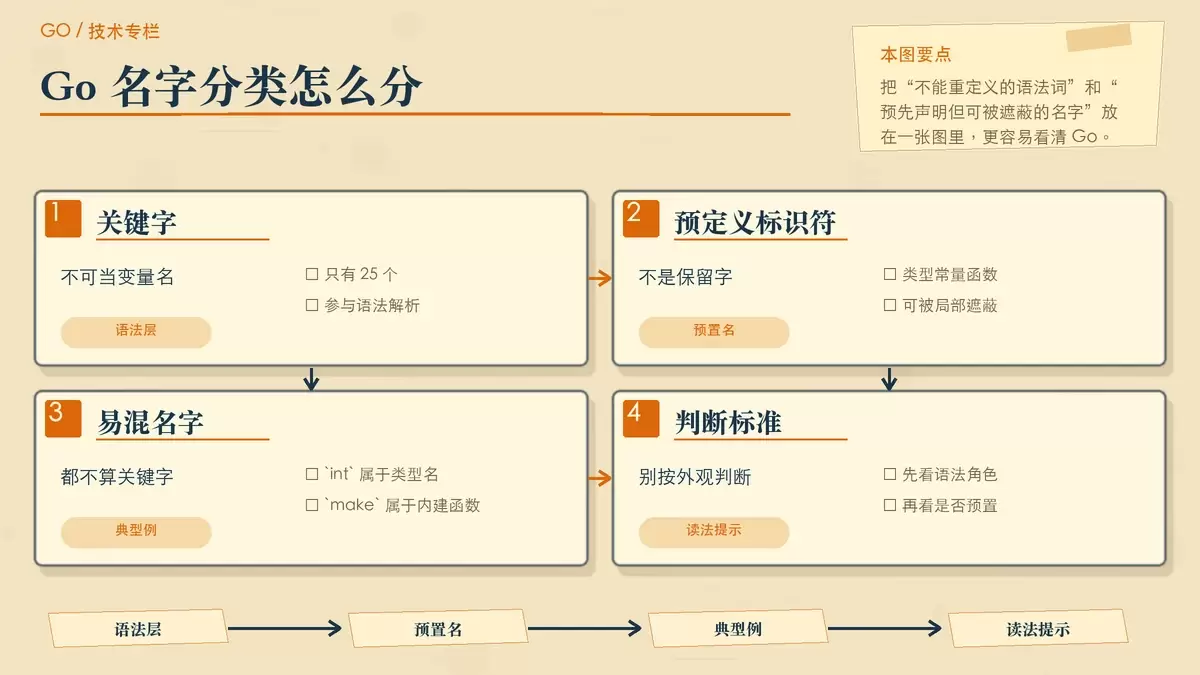
很多 Go 开发者都会把 `int`、`make`、`len` 视作关键字,但它们其实属于预定义标识符。本文从一段可编译代码切入,解释关键字与预定义标识符的边界、Go 为什么只保留 25 个关键字,以及这种设计对语言演进、编译器实现和日常编码习惯意味着什么。
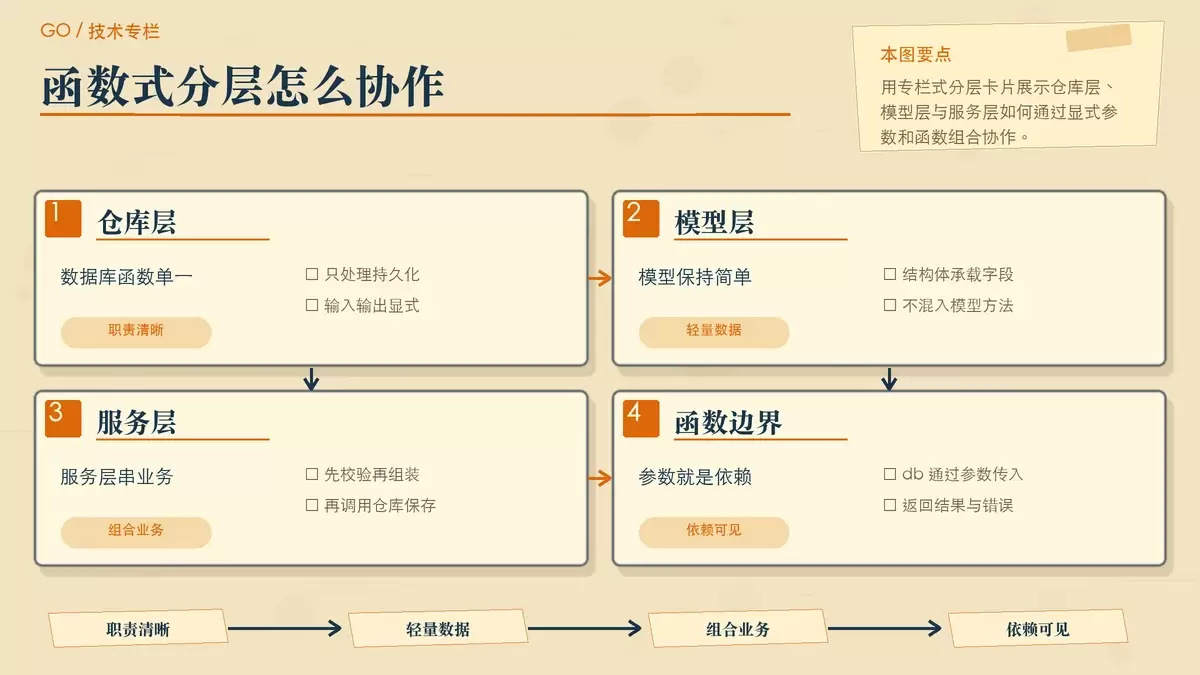
这篇文章以 Gin 与 GORM 组合为例,拆解 Go Web 项目里“函数式写法”到底适合落到哪些层:仓库层、服务层、控制层和中间件都能受益,但数据库连接、配置管理与测试替身问题也会暴露出边界。读完可以快速判断,函数式思想在 Go Web 架构中该用到什么程度。
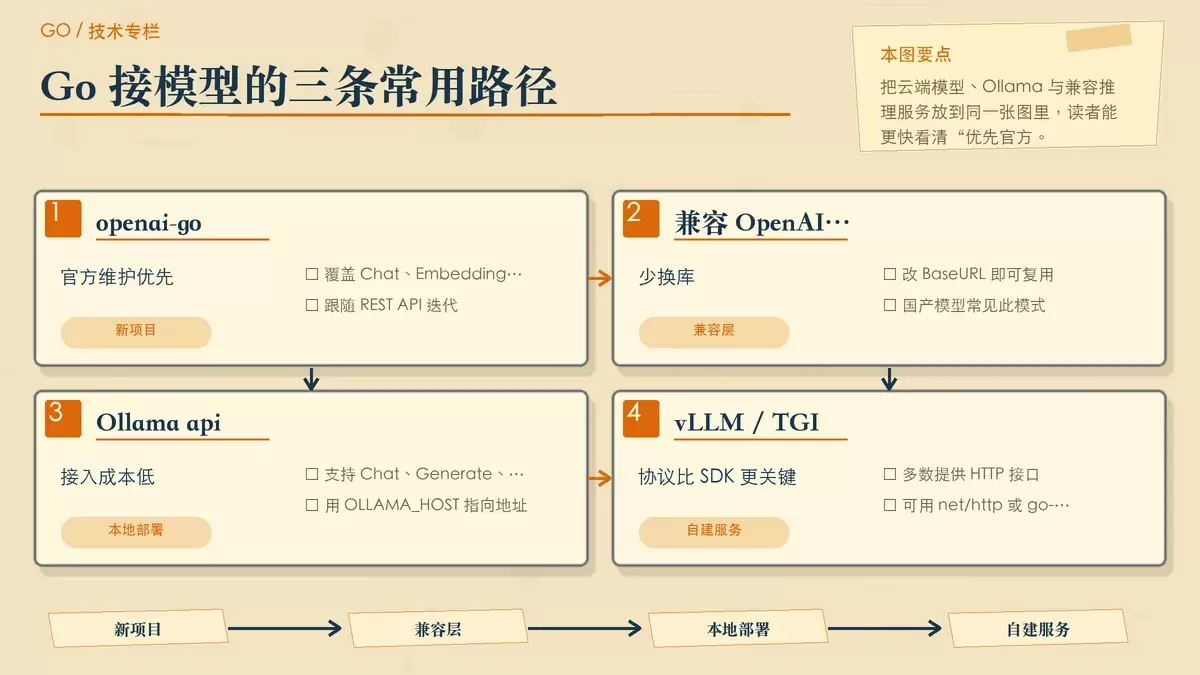
Go 接入大模型并不缺方案,难点在于生态分散、库的定位不同。本文按云端模型、MCP、本地推理和 RAG 四类场景梳理主流 Go 库,保留各自适用边界,并给出新项目与存量项目的选型建议,方便快速判断该直接上官方 SDK,还是走兼容接口或自建链路。
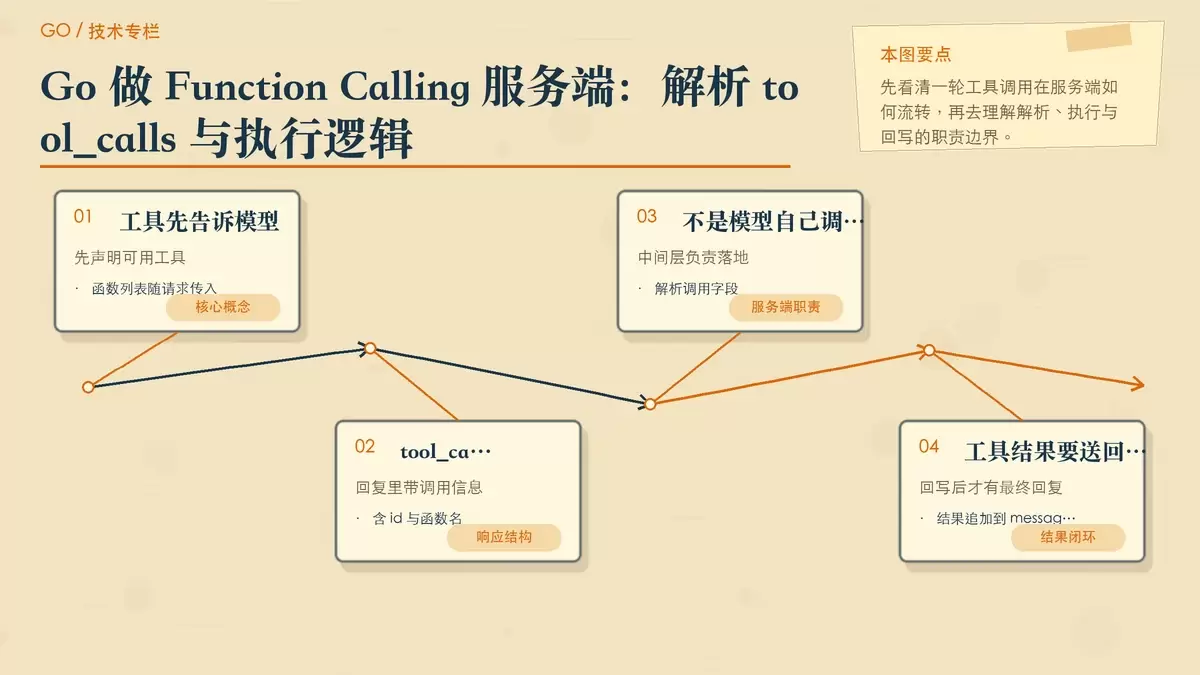
这篇文章用 Go 梳理 Function Calling 服务端的核心实现:如何解析模型返回的 `tool_calls`、如何用注册表分发执行函数,以及怎样把工具结果按协议回填到对话里继续请求模型。读完可以直接搭出一套可维护的基础执行链路。
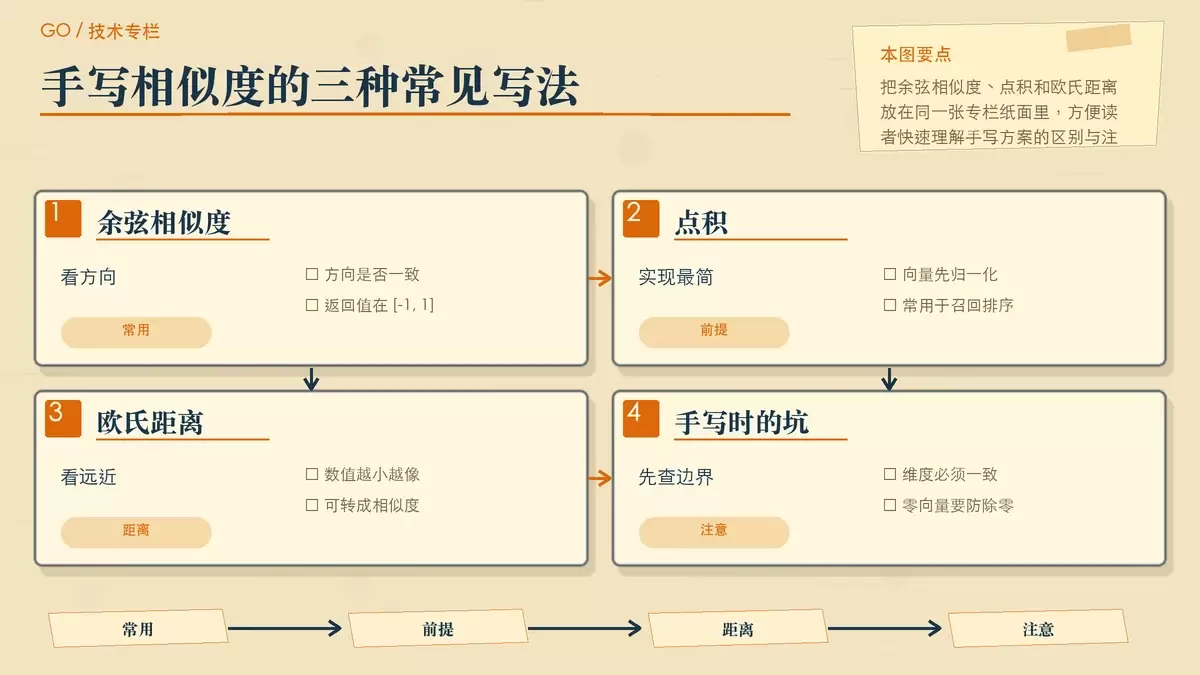
在 Go 里计算向量相似度,常见路径并不止一种。小规模数据可以直接手写余弦、点积和欧氏距离;需要批量计算和更高性能时,适合交给 gonum 这类数值库;当规模进入十万到百万级,并且要做 ANN 检索时,更实际的做法是接入向量数据库。
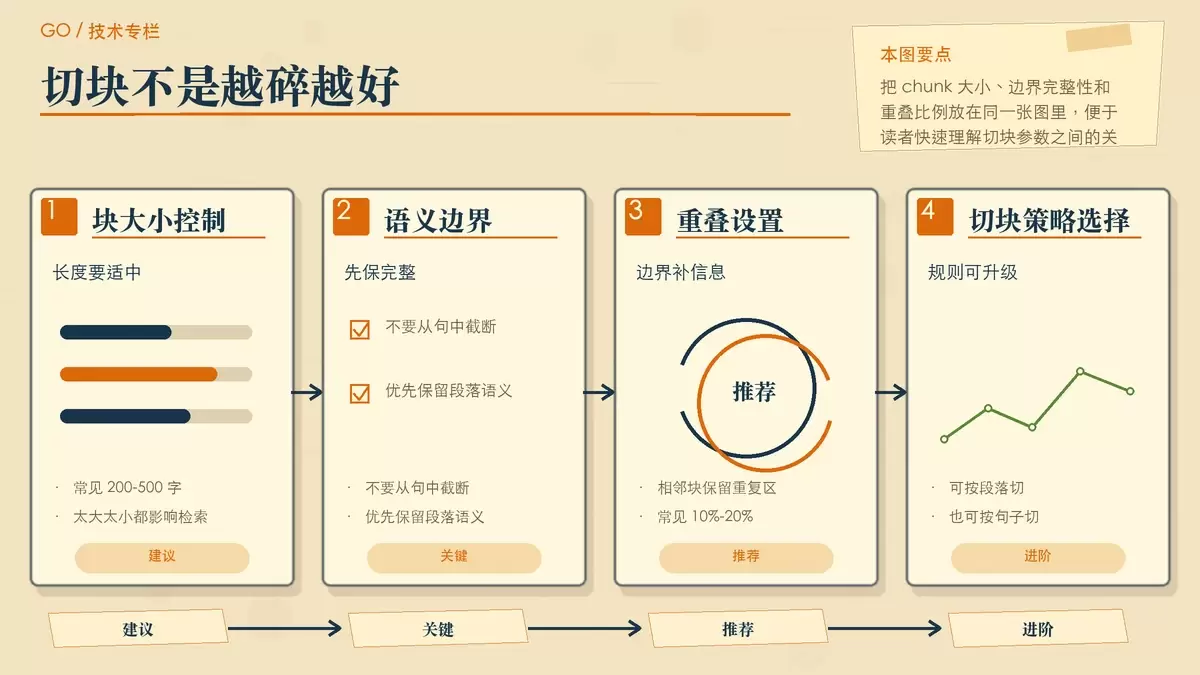
这篇文章用 Go 把 RAG 的核心链路拆成三步:文档切块、Embedding 向量化和相似度检索。你可以直接看懂最小实现,也能据此判断 chunk 大小、重叠比例、Top-K、向量库选型这些参数该怎么取。 想让大模型真正读懂企业知识库,关键不在于把文档一股脑塞进提示词,而在于先把内容拆成可检索的片段,再按问题取回最相关的上。
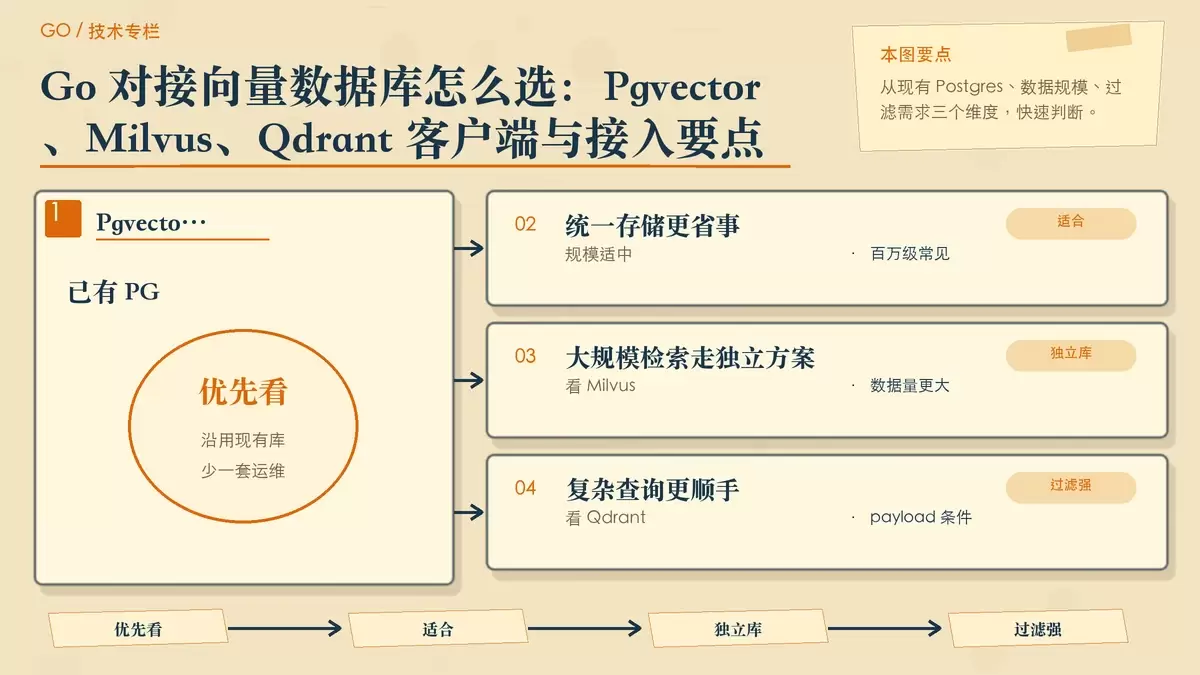
在 Go 项目里接入向量检索,常见路线通常落在 Pgvector、Milvus 和 Qdrant 三种方案。它们分别对应“沿用 Postgres”“独立扩展大规模向量库”“更重视过滤与多向量能力”三类需求,客户端使用方式和接入成本也差异明显。
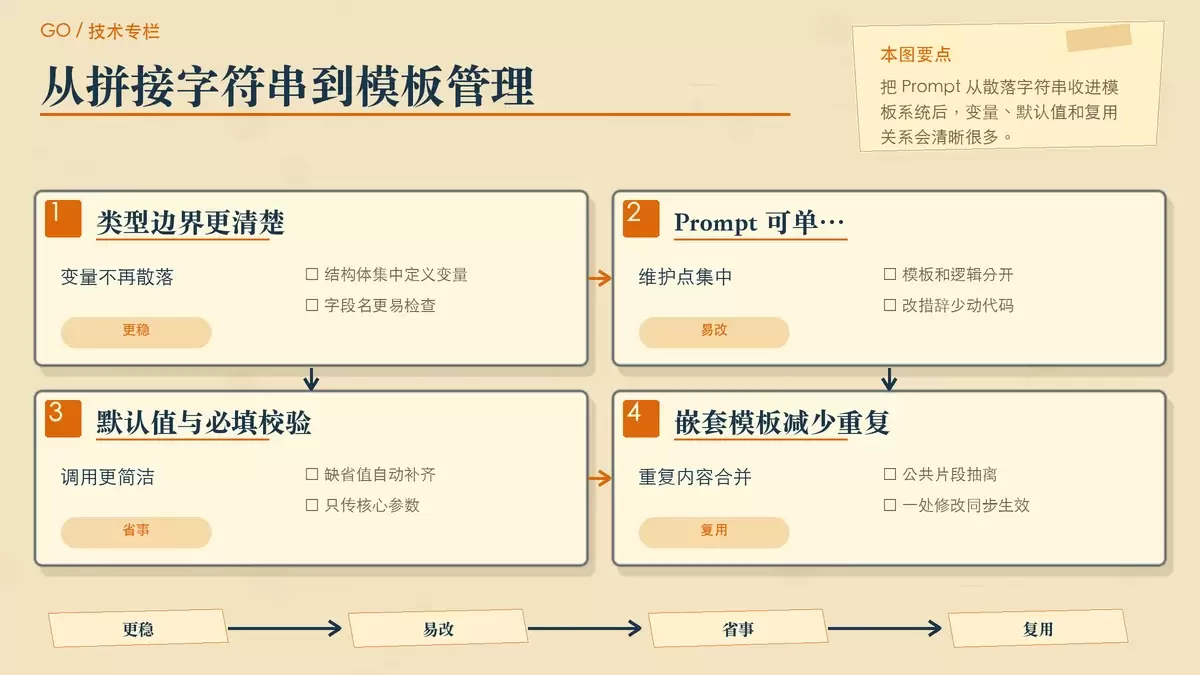
随着 AI 应用里的 Prompt 数量增长,直接在 Go 代码里拼接字符串很快会碰到维护、复用、多语言和回滚问题。本文围绕模板化、语言切换和版本管理三条主线,整理一套可落地的 Prompt 管理方式,并保留 Go 标准库即可实现的核心做法。
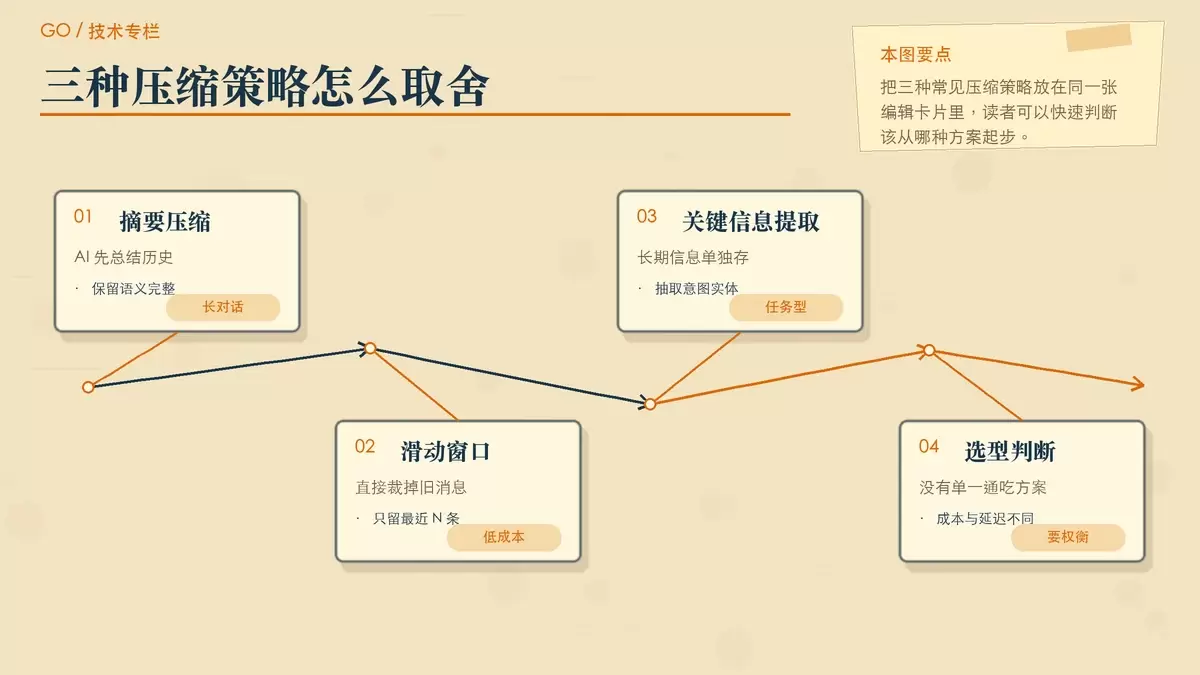
大模型会“忘事”,本质上往往不是能力问题,而是上下文窗口和成本双重限制。本文结合 Go 示例,把摘要压缩、滑动窗口、关键信息提取三种常见做法拆开说明,并给出组合策略、触发阈值和几个容易踩坑的实现细节。