使用Pandas与MySQL计算相邻行数据差值的方法
本文介绍如何在Python的Pandas库和MySQL数据库中计算表格中相邻两行数据的差值(增值)。通过Pandas的diff函数可快速实现,而在MySQL中则需利用用户变量构造行号进行自连接查询。文章提供了完整的代码示例、测试数据及结果对比,帮助开发者解决此类数据清洗与计算需求。
2026-10-13
25

本文介绍如何在Python的Pandas库和MySQL数据库中计算表格中相邻两行数据的差值(增值)。通过Pandas的diff函数可快速实现,而在MySQL中则需利用用户变量构造行号进行自连接查询。文章提供了完整的代码示例、测试数据及结果对比,帮助开发者解决此类数据清洗与计算需求。
本文以Kaggle Titanic竞赛数据为例,详细讲解使用Pandas进行数据预处理的完整流程。内容涵盖数据加载、维度与类型检查、缺失值填充策略(丢弃或填充)、数值特征离散化及类别变量映射,以及通过GroupBy和Pearson系数分析特征与目标变量的关系,为后续模型构建奠定基础。
本文深入解析pandas中agg与apply函数的区别。agg专用于聚合运算,将一维数组简化为标量;而apply更通用,支持排序等无法简化的自定义操作。两者均作用于groupby对象,理解其适用场景有助于提升数据处理效率。
针对 C# 不支持类多继承的限制,通过定义空接口配合泛型扩展方法,可实现类似 C++ 的多重行为注入。该方法解决了多个类实现相同接口时的代码重复问题,让老虎、苍蝇等不同类复用相同的飞行逻辑,既保持了接口的契约作用,又实现了行为的真正复用与组合,符合面向对象设计原则。
本文介绍如何在pandas中利用apply函数同时处理两列数据。通过定义自定义函数并结合lambda表达式,可实现对指定列的复杂计算与逻辑处理,适用于数据清洗及特征工程场景。
本文介绍如何在Python中利用startswith和endswith方法在字符串开头或结尾进行文本模式匹配。通过示例演示如何检查文件扩展名和URL协议,并展示如何结合元组进行多选项检查及数据整理操作,帮助开发者高效处理字符串验证任务。
本文介绍在pandas中如何获取groupby分组后最大值所在的行。通过示例DataFrame,演示了使用apply过滤、transform匹配索引、idxmax以及先排序后取首行四种方法。针对多行并列最大值的情况,重点解析了idxmax仅返回第一行的特性及排序法的替代方案,并探讨了扩展至中间值等场景的思路。
本文介绍Python及Pandas在处理文件读写时遇到的编码问题。通过记事本另存为UTF-8,或在Pandas中指定encoding参数(如gb2312),可有效解决Excel打开或写入时的中文乱码现象。
本文介绍了如何在Python3环境中利用Pandas库与pymysql、SQLAlchemy配合,实现从MySQL数据库读取数据并插入新表的操作。内容涵盖数据库连接配置、建表语句、初始数据插入及用户权限授权,提供完整代码示例供参考。
本文介绍如何在pandas中结合groupby和sort_values对DataFrame进行分组后排序。通过示例展示利用groupby分组后,使用nlargest方法获取各组最大值或Top N记录的技巧,适用于需要按多个维度统计并排序的场景。
本文介绍在pandas中利用groupby结合head()方法获取分组后每组前几行记录的实用技巧。通过先按指定列排序,再执行groupby().head(n),可高效提取各组Top N数据,适用于排行榜、抽样等场景。
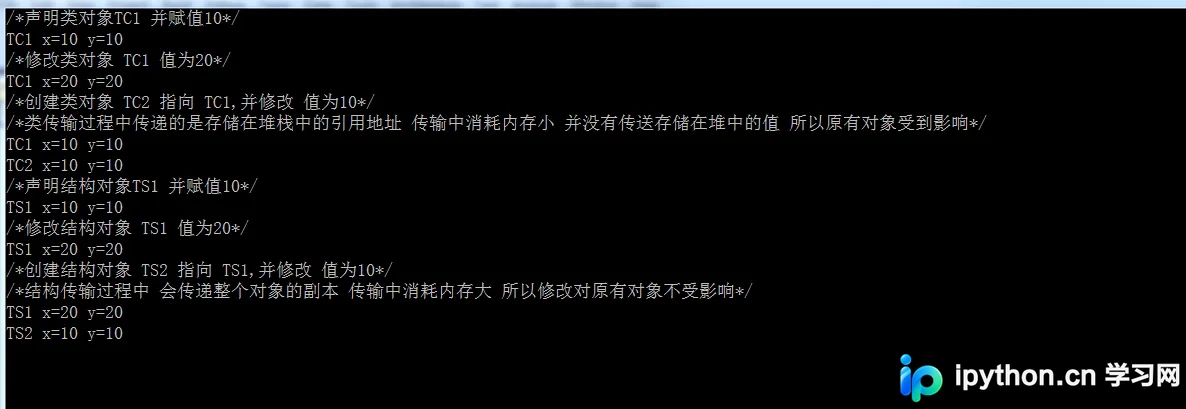
本文深入解析C#中类(class)与结构(struct)的核心区别。通过内存存储机制、引用传递与值传递的原理,结合完整代码实例与运行结果截图,直观展示两者在对象赋值、修改及对原数据影响方面的不同表现,帮助开发者准确选择数据类型。