

Python 编码规范整理
本文系统整理了 Python 编码规范,涵盖代码编排、文档、空格使用、注释及命名规则。重点讲解缩进标准、行长度限制、模块导入顺序、变量与函数命名约定,以及异常处理和序列操作的性能优化建议,旨在提升代码可读性与维护性。
2026-10-13
21

本文系统整理了 Python 编码规范,涵盖代码编排、文档、空格使用、注释及命名规则。重点讲解缩进标准、行长度限制、模块导入顺序、变量与函数命名约定,以及异常处理和序列操作的性能优化建议,旨在提升代码可读性与维护性。
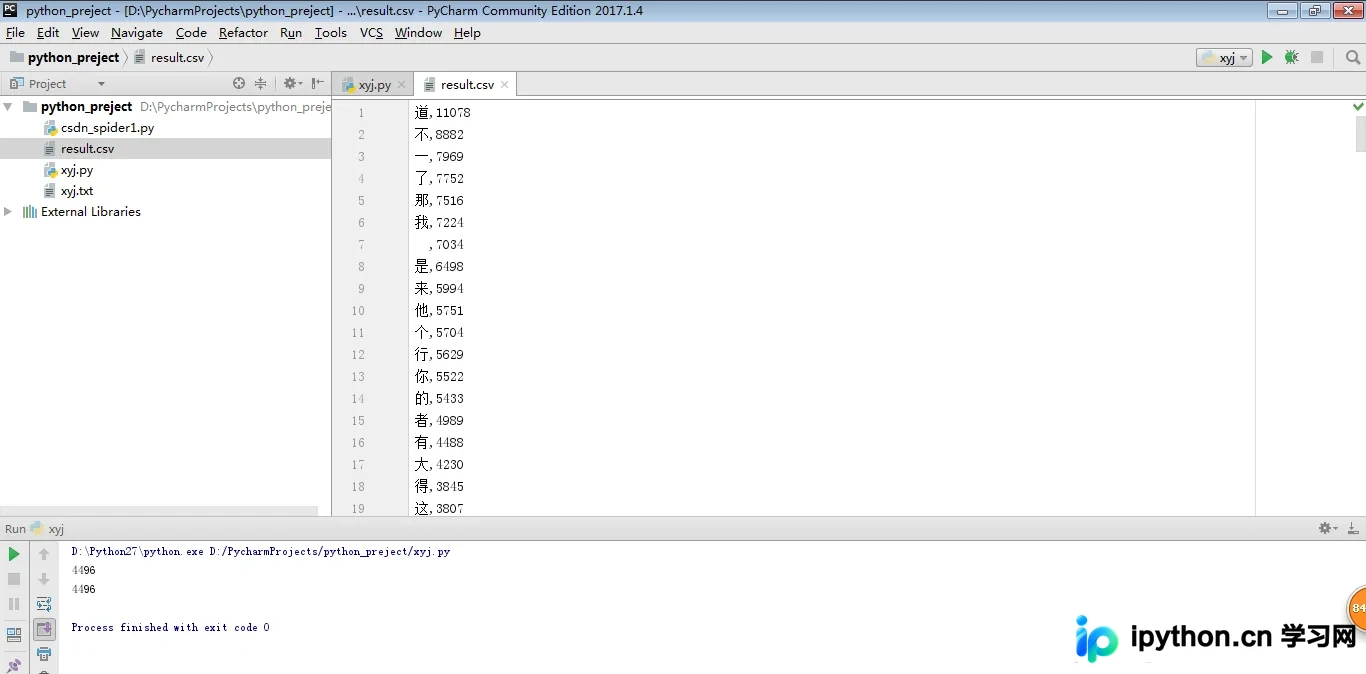
本文通过Python示例展示如何统计《西游记》文本中的汉字使用情况。程序读取xyj.txt文件,过滤标点与空白,利用字典记录每个汉字的出现次数。最终输出不同汉字的总数、各字频次,并按降序排列生成result.csv文件,帮助分析高频汉字。
本文详解Python中使用代理的三种方式:通过urllib和requests库直接配置代理对象,利用HTTP_PROXY和HTTPS_PROXY环境变量全局生效,以及借助Fiddler等工具拦截修改请求。适用于解决国内网络限速或屏蔽问题,提升数据爬取效率与成功率。
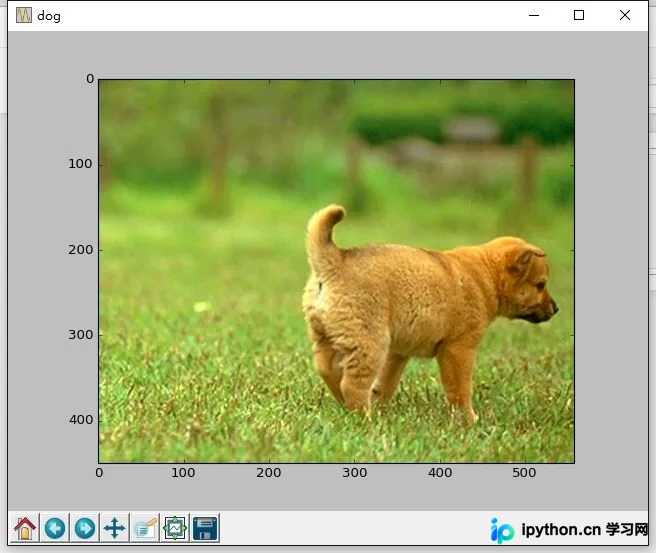
本文介绍如何利用Python进行数字图像处理,替代Matlab的高成本与封闭性。通过安装Pillow库处理图像打开与保存,并结合Matplotlib库实现更灵活的图片显示与属性查看,涵盖从环境配置到具体代码实现的完整流程。
本文介绍如何利用 PHP 脚本自动读取本地 SQL 文件并将其内容逐条写入 MySQL 数据库。通过 `file_get_contents` 获取内容,使用 `explode` 分割语句,并结合 `mysqli` 对象进行连接与执行。文中包含基础导入逻辑、自定义创建目标数据库以及处理字符集的详细代码示例。
本文详解C语言中两个重要系统调用。getopt用于高效解析命令行参数,通过指定选项字符串处理带参和不带参选项;select实现I/O多路复用,允许程序同时监控多个文件描述符的状态变化。文章提供具体代码示例、宏操作说明及常见错误排查方法。
本文介绍如何在Python3中利用requests库结合IP代理池实现随机IP生成。通过从预设代理列表随机选择IP,配置请求头信息,并访问测试网站验证当前IP。该方法适用于需要隐藏真实IP或进行网络爬虫开发的场景,代码简洁实用,可直接参考使用。
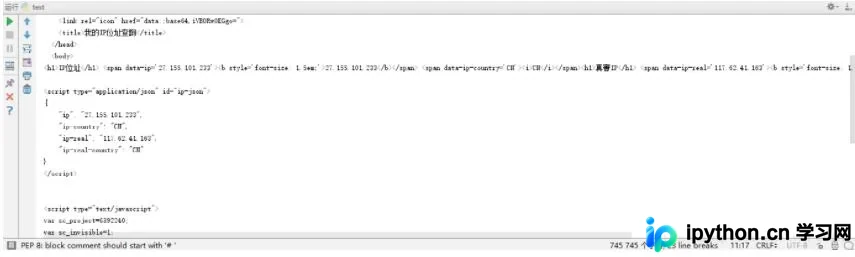
本文介绍了使用Python的urllib库通过指定代理IP访问whatismyip.com.tw网站的完整代码实例。文中演示了如何配置ProxyHandler和Opener,并分析了该代理IP(27.155.101.233:3128)的匿名程度。结果显示该代理为透明代理,真实IP被网站识别,虽不满足高匿需求,但仍适用于部分对匿名性要求不高的场景如投票等。
本文介绍利用Python生成前100组勾股数的方法。通过设定奇数a=2n+1,推导b=2n^2+2n及c=b+1的公式,结合a^2+b^2=c^2校验,高效输出结果。该方法避免了复杂的穷举试探,展示了算法在数学计算中的重要性。
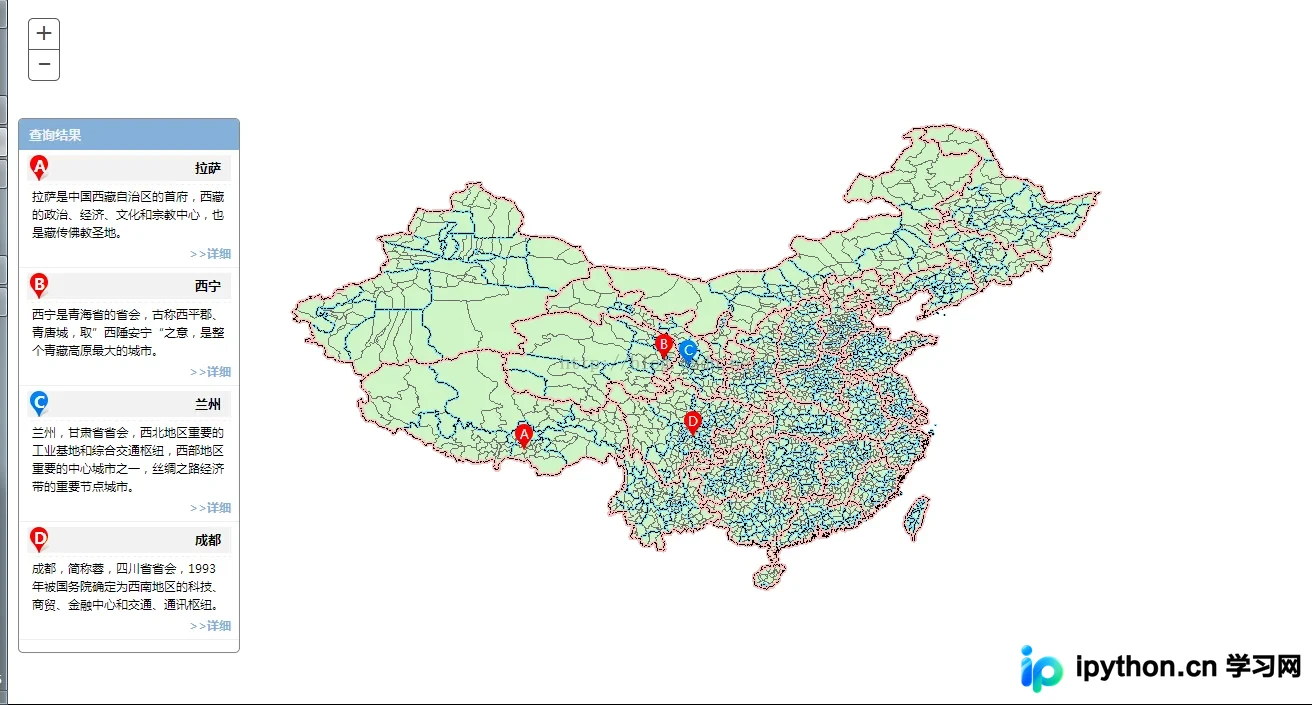
本文介绍如何利用ArcGIS API for JavaScript实现侧边栏列表与地图上的Marker点双向联动效果。通过监听鼠标悬停、移出和点击事件,同步更新列表图标颜色及地图标记样式,并配合InfoWindow展示详细数据,提供完整的HTML与JS代码逻辑。
本文系统梳理 Python 中 datetime、timestamp、time tuple、string 及 date 五种时间相关对象的操作方法。内容涵盖获取当前时间、日期差值计算、周月最后一天获取,以及各类对象间的相互转换实现,帮助开发者掌握 Python 时间处理的核心技能。
本文详细讲解Python爬虫中如何有效设置代理IP及伪装浏览器身份。内容涵盖使用urllib模块配置请求头、添加代理服务器、处理POST请求参数,以及利用PhantomJS和Selenium WebDriver模拟真实浏览器行为。通过具体代码示例,帮助开发者规避反爬限制,提升数据采集成功率。