

Python math模块常用函数与内置数学操作详解
本文详细介绍Python中math模块的核心功能,涵盖向下取整、向上取整、四舍五入、幂运算及开方等常用数学函数。同时解析random模块的随机数生成与列表操作,以及max、min、进制转换等内置函数的应用,帮助开发者高效处理数值计算任务。
2026-10-13
20

本文详细介绍Python中math模块的核心功能,涵盖向下取整、向上取整、四舍五入、幂运算及开方等常用数学函数。同时解析random模块的随机数生成与列表操作,以及max、min、进制转换等内置函数的应用,帮助开发者高效处理数值计算任务。
本文深入解析Scrapy框架的数据流向及核心组件。详细阐述引擎、调度器、下载器与Spider间的数据交互过程,并重点剖析DownloaderMiddleware与SpiderMiddleware的作用位置及核心方法,包括process_request、process_response和process_exception的具体行为与返回值处理,帮助开发者掌握Scrapy内部机制。
本文介绍在Python中判断元组、列表和字典是否为空的简洁方法。通过直接使用if not xxx或assert not xxx语句,可以高效检测这些数据结构是否为空,无需额外调用len()函数。
本文介绍在Python中如何清空文件并替换指定内容。通过示例代码展示,若仅调用truncate()可能导致追加而非替换效果。关键在于使用f.seek(0)将文件指针重置到起始位置,确保truncate()从正确位置开始截断,从而实现内容替换。
本文介绍使用Python读取TXT文件内容,按行分割后利用列表特性去除重复行,并将去重后的结果写入新TXT文件的完整方法。通过具体代码示例展示文件读写及列表操作过程,帮助开发者快速实现文本数据的清洗与备份。
本文介绍了一种使用Python正则表达式过滤HTML标签并替换字符实体的方法。通过定义特定的正则规则,依次移除CDATA、脚本、样式及HTML注释,将换行标签转换为实际换行,并清理多余空格。同时,代码包含处理常用HTML字符实体的逻辑,确保文本内容的纯净与可读性,适用于需要清洗HTML源码的场景。
本文详细介绍Python中BeautifulSoup库的基础使用方法。内容涵盖库的安装命令、HTML文档的引入方式,以及利用find、select等API提取标题、属性、文本及特定标签的实操技巧,帮助开发者快速掌握HTML数据解析核心技能。
本文介绍如何利用Python的qrcode和Pillow库快速生成二维码。通过终端安装依赖包后,编写少量代码即可实现将文本或网址转换为二维码图片并保存。示例展示了如何根据输入内容自动判断生成类型,适合初学者快速上手。
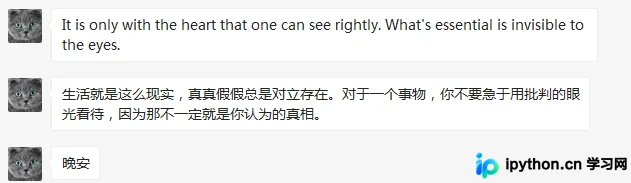
本文介绍如何使用Python编写一个微信机器人,通过wxpy和wechat_sender库实现每天定时向指定好友发送晚安消息及每日一句。文章提供了完整的代码示例、依赖安装步骤及关键参数说明,帮助开发者快速搭建个人化的微信自动互动工具。
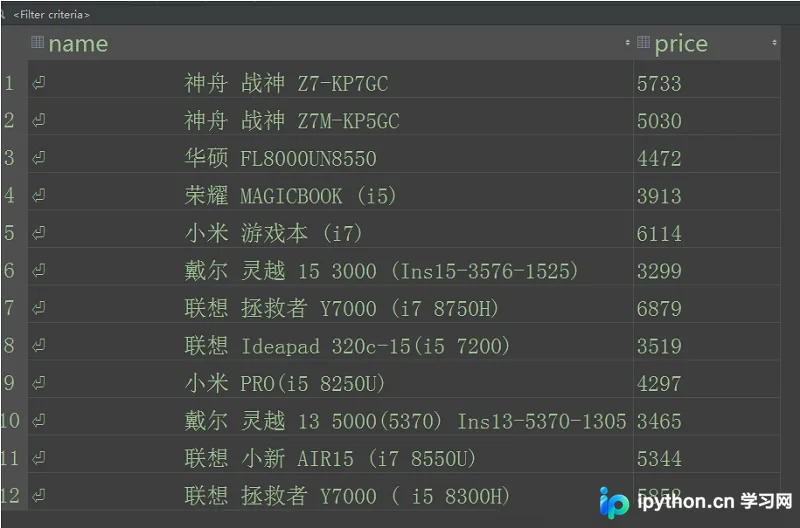
本文介绍如何使用Scrapy框架结合PhantomJS处理动态加载网页数据。通过配置Selenium中间件拦截请求,利用JavaScript渲染页面源码,并在Spider中解析HTML提取商品信息。随后通过Item定义数据结构,利用Pipeline将数据写入SQLite数据库,完整演示从配置到入库的技术流程。
本文介绍如何使用Python递归遍历文件夹,并高效筛选出以指定后缀名结尾的文件。通过定义辅助函数判断序列中是否存在满足条件的元素,结合os.listdir实现目录遍历,支持多后缀匹配。示例代码展示了基础实现与包含计时统计的优化版本,适用于需要批量处理特定格式文件的场景。
本文介绍Python中利用strip()函数清除字符串前后空格的方法。该方法仅去除首尾空白,保留中间空格,区别于正则表达式re.sub会清除所有空格。通过代码示例对比strip()与re.sub(' ','',str)的输出结果,帮助开发者根据需求选择合适方案。