

Python爬虫实现爬取百度百科词条功能实例
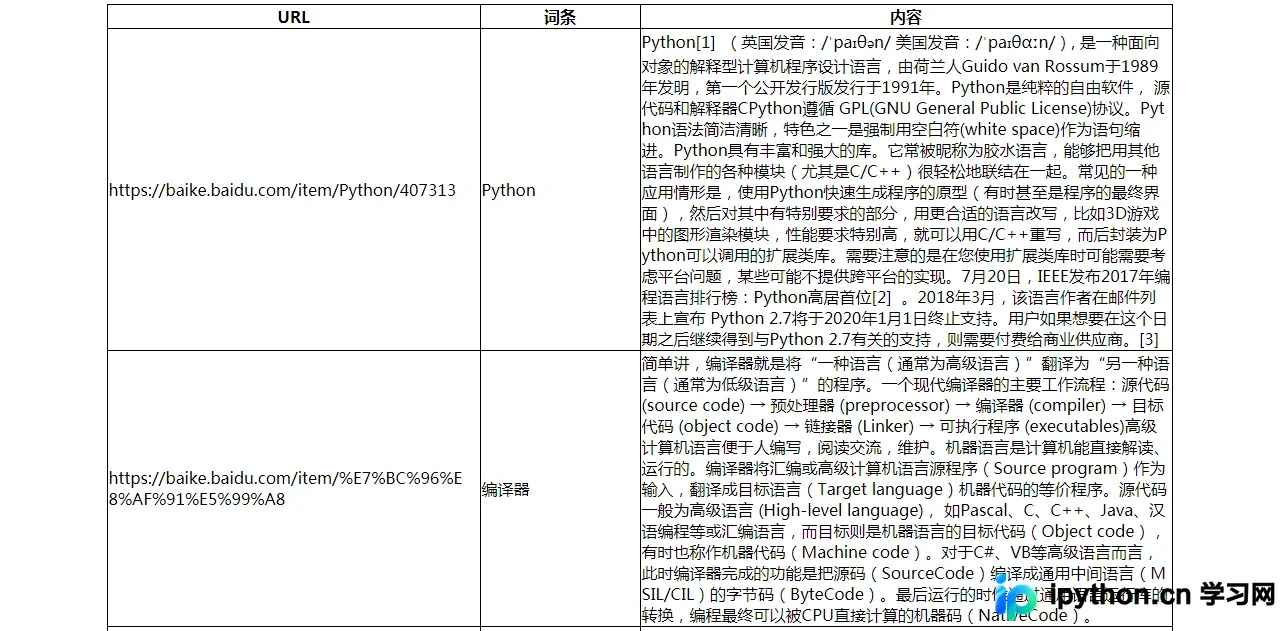
本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
2026-10-13
30

本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
本文深入解析Python内置HTMLParser模块的工作原理,详细列举handle_starttag等核心回调函数。通过一个完整的贴吧图片抓取实例,演示如何继承HTMLParser并重写方法以提取GIF和JPG链接,实现自动下载功能,为Python爬虫开发提供实用参考。
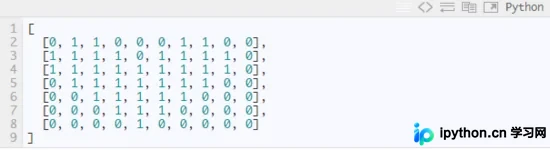
本文介绍如何使用 Python 脚本通过控制本地 Git 提交时间和频率,在 GitHub 贡献面板中生成特定图案。文章详细讲解了利用 GitHub 贡献面板实时生成机制的原理,提供了基于 JSON 模板的设计方案,并给出了实现自动提交、填充历史数据及设置定时任务的完整代码示例,帮助用户打造个性化的 GitHub 主页。
在Java开发中,处理字符串首字母的大小写转换是常见需求。本文将介绍如何通过Character类和StringBuilder高效实现将字符串首字符转为大写或小写的功能,并解释空指针异常的处理细节,提供可直接复用的代码示例。
本文通过Python实战案例,详细解析如何模拟登录CSDN平台。内容涵盖从导入必要库、获取请求头部信息、解析网页结构,到维持登录状态Session及验证登录结果的完整代码流程。旨在帮助开发者理解模拟登录的核心逻辑,提升Python网络编程与爬虫开发能力。
本文介绍KMP字符串匹配算法的原理及Python实现。KMP通过next数组(部分匹配表)避免回溯,提高匹配效率。文章包含核心代码解析、部分匹配值计算逻辑及单元测试示例,帮助开发者理解并应用该算法。
本文深入解析Python中8个最高频使用的内置函数,涵盖print输出控制、isinstance类型检查、range序列生成、enumerate索引枚举、len长度计算、reversed反转、open文件读写及sorted排序。通过具体代码示例与参数详解,帮助开发者掌握高效编程技巧,提升代码可读性与执行效率。
本文详解在pandas DataFrame中如何高效筛选和删除指定行。通过isin()方法传入列表或字典可实现精确匹配,同时介绍针对包含特定字符串行的处理技巧,帮助开发者快速完成数据清洗与过滤操作。
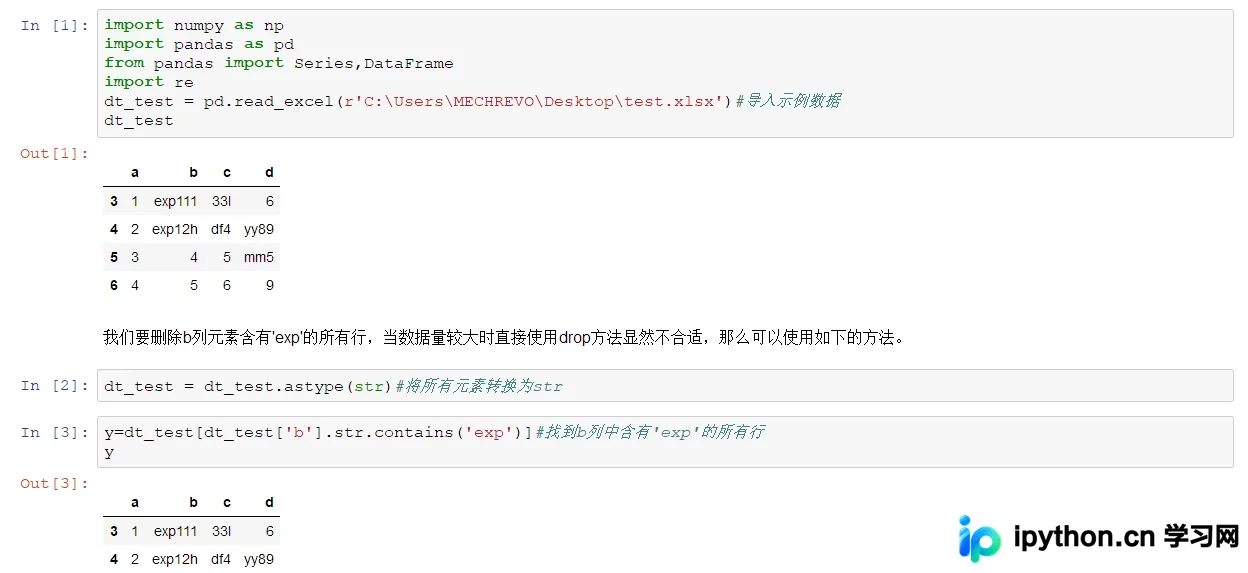
本文介绍在pandas中如何高效删除DataFrame中包含特定字符串的行。通过示例演示利用str.contains()结合逻辑取反或query()方法,快速筛选并剔除含有固定字符的数据行,适用于数据预处理与清洗场景。
本文详细介绍如何使用Python将列表数据分别写入TXT、CSV和Excel文件。通过自定义函数实现TXT文件的逐行写入与格式化清理,利用csv模块处理CSV数据的分隔符控制,以及使用xlwt库生成Excel工作表。提供完整代码示例,涵盖路径设置、编码处理及数据遍历写入逻辑,帮助开发者快速实现数据持久化存储。
本文详解Python中读取图像的三种常用库:Matplotlib、scikit-image和PIL。通过对比安装方式与核心API,重点分析各库在处理PNG等格式时的数据类型差异,如8-bit PNG可能输出3通道或float32等问题,帮助开发者根据实际需求选择最合适的图像读取方案。
本文详细解析Python中三种核心数据结构:元组、列表和字典。通过对比元组的不可变性与列表的可变性,介绍列表的增删改查、排序及多维应用。同时深入讲解字典的键值对存储机制、无序特性及常用操作方法,帮助初学者掌握Python数据处理基础。