

Python实现快速排序的四种方式详解
本文详细解析了Python中快速排序的四种实现方式,包括一行代码的简洁写法、常见的双指针递归实现、《算法导论》版的分区逻辑以及基于栈的非递归迭代方案。文章深入探讨了原地排序对参数传递的要求,以及递归转迭代时栈结构的处理细节,帮助开发者全面理解快排核心机制。
2026-10-13
25

本文详细解析了Python中快速排序的四种实现方式,包括一行代码的简洁写法、常见的双指针递归实现、《算法导论》版的分区逻辑以及基于栈的非递归迭代方案。文章深入探讨了原地排序对参数传递的要求,以及递归转迭代时栈结构的处理细节,帮助开发者全面理解快排核心机制。
本文深入讲解Python3中字符串与字节码的转换机制。重点解析encode和decode方法的正确用法,阐明Python3默认使用Unicode编码的特性。通过实例演示UTF-8与GBK互转流程,并指出常见的AttributeError错误原因,帮助开发者避免编码转换陷阱。
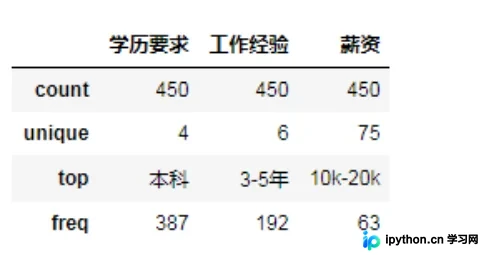
本文详细介绍利用Python3对拉勾网招聘数据进行可视化分析的全过程。从数据清洗、薪资区间预处理到使用jieba进行中文分词,最终通过环状图、柱状图及词云图展示学历、经验与职位要求的分布特征,为数据分析师岗位提供直观的数据洞察。
本文介绍了在 Java 环境下使用 Selenium WebDriver 处理浏览器弹出窗口和标签页切换的方法。核心逻辑是通过 driver.getWindowHandles() 获取所有窗口句柄集合,遍历并比对标题定位目标窗口,再利用 driver.switchTo().window(handle) 完成上下文切换,最后可切回父窗口继续操作。
本文深入解析Python3中从排序数组删除重复项的三种实现方式。重点对比利用set()快速去重、双指针法原地修改以及调用remove()方法的效率差异。所有方案均遵循O(1)额外空间限制,通过具体代码示例展示如何返回新长度并优化数组内容,帮助开发者根据实际场景选择最优解。
本文介绍在Python3中安装图像处理库Pillow的方法。Pillow是PIL的继任者,支持Python 3.x。通过pip或easy_install一行命令即可完成安装,并演示了如何导入Image模块进行基础图片处理操作。
本文介绍Python3中计算两个数组交集的两种常见方案。第一种利用collections.Counter与交集运算符一步获取结果;第二种通过遍历并动态删除元素实现。文章包含完整代码示例及运行结果,适合Python开发者参考。
本文详细记录了在Python 2.7环境下使用Plotly库进行本地数据可视化的过程。针对官方在线存储案例在本地环境下的兼容性问题,特别是jupyter与Python版本的限制,作者通过对比iplot与plot函数的差异,成功实现了无需在线存储的本地散点图和折线图生成方案,并提供了完整的测试代码供参考。

本文详细介绍在Windows系统中下载、安装及验证NumPy库的完整流程。涵盖从选择合适的.whl文件、配置Scripts目录到系统环境变量,再到命令行安装与导入测试的全过程,帮助开发者快速搭建Python科学计算环境。
本文详解Python中@property装饰器的用法,通过Student类示例演示如何利用它实现数据校验、限制属性范围(如0-100分)、创建只读属性以及动态计算属性(如根据出生年份计算年龄)。文章指出直接修改内部变量可能导致数据不一致,而@property能保持接口统一并自动处理逻辑,是优化类属性访问与设置的推荐方案。
DOM将网页解析为树状结构,包含12种节点类型。通过nodeType、nodeName和nodeValue三个核心属性可识别不同节点。本文详解元素(1)、特性(2)、文本(3)、注释(8)、文档(9)等常用节点及其属性值,并说明CDATA(4)、实体(5-6)等XML专用节点的差异与浏览器兼容性问题。
本文详细解析Python中删除列表重复元素的三种常用方法。通过字典fromkeys利用哈希特性去重,利用set集合的无序非重复特性,以及排序后逆向扫描删除重复项。代码简洁高效,适合不同场景下的数据处理需求,帮助开发者掌握Python列表操作的进阶技巧。