基于jieba分词与同义词词典的Python文本替换实现
本文介绍如何利用Python的jieba库结合自定义同义词词典实现文本中的词汇替换。通过读取指定格式的TXT文件构建映射字典,调整特定词汇的词频以确保正确分词,随后对输入字符串进行切分并执行替换逻辑。该方法适用于需要标准化术语或进行文本预处理的自然语言处理场景。
2026-10-13
23

本文介绍如何利用Python的jieba库结合自定义同义词词典实现文本中的词汇替换。通过读取指定格式的TXT文件构建映射字典,调整特定词汇的词频以确保正确分词,随后对输入字符串进行切分并执行替换逻辑。该方法适用于需要标准化术语或进行文本预处理的自然语言处理场景。
深入解析C++中指针作为函数参数的核心机制,通过swap交换示例演示如何利用指针对地址操作以修改主调函数变量值。文章详细剖析了实参形参单向传递特性,指出直接修改形参指针或仅传递值的错误做法,并提供多变量排序的完整代码实现,帮助开发者掌握C++高效数据交互技巧。
本文介绍如何使用TensorFlow查看CKPT文件中各节点变量的名称。通过Python脚本读取模型文件,获取变量到形状映射,并打印出所有节点名称。
本文详细解析C语言中用于目录流定位的两个关键函数:telldir()和seekdir()。通过包含dirent.h头文件,开发者可使用telldir获取当前读取偏移量,利用seekdir设置下一次readdir的起始位置,从而实现从指定目录项开始重新读取或跳转遍历。文中提供了完整的代码示例、执行结果分析及注意事项,帮助理解非连续遍历目录的技巧。
本文详细介绍如何利用pythonnet在Python中调用Halcon脚本。内容涵盖pythonnet的安装与基础用法、HDevEngine的调用流程、ref类型参数处理,以及核心难点:将Python numpy ndarray高效转换为Halcon HImage对象。通过具体代码示例,解决跨平台数据类型差异及内存偏移问题,提供可直接复用的转换方案。
本文详细介绍Python中数据归一化的定义、目的及常见实现方法。归一化旨在消除量纲影响,提升数据可比性,主要处理奇异样本数据。内容涵盖最大-最小标准化(映射至[0,1])和Z-score标准化(均值0,方差1),并解析矩阵列归一化原理。通过sklearn库的normalize函数示例,展示axis参数在行与列归一化中的具体应用,为机器学习数据预处理提供实用参考。
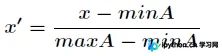
本文详细解析Python中跨目录import的三种常见场景:同级目录直接调用、子目录通过包路径导入,以及上级目录利用sys.path追加路径的方法。文章通过具体代码示例和目录结构图,演示了如何处理不同层级间的模块引用,特别强调了在上级目录调用时需创建__init__.py文件及配置sys.path的关键步骤,帮助开发者解决Python项目中的模块导入难题。
本文深入解析C语言中三大核心输出函数:printf用于屏幕打印,fprintf定向写入文件,sprintf格式化数据至字符串。详细对比参数格式如%d,%s的用法,演示宽度和精度控制,并重点说明sprintf引发的缓冲区溢出风险及snprintf的安全替代方案。
本文详解TensorFlow中如何处理长度不一的变长数据(如语音、视频或NLP样本)。通过对比直接padding写入与使用padded_batch方法,重点解析padded_batch的参数配置及tf.VarLenFeature配合sparse_tensor_to_dense的使用,结合MNIST示例展示完整代码实现。
本文深入解析 Python 内置函数 super() 的核心用法与底层原理。通过单继承与多重继承(MRO)的完整代码示例,展示如何避免硬编码基类名称并正确传递参数。重点剖析钻石继承结构下的方法解析顺序,帮助开发者理解 super() 在复杂类层次中的执行流程。
本文详解Python中future模块的核心作用,即在不升级解释器版本的前提下,提前引入新版本特性。通过print函数语法变更及除法运算规则两个具体案例,演示如何通过在代码头部添加__future__导入语句,解决Python 2与Python 3之间的语法差异,实现代码的跨版本兼容测试。
本文详细解析Python中global和nonlocal关键字的区别与应用。global用于在函数内修改全局变量,需显式声明;nonlocal用于在嵌套函数中修改外层函数变量,作用于闭包。通过代码示例说明未声明导致的UnboundLocalError及正确用法,帮助开发者掌握变量作用域规则。