

Keras与Sklearn数据切分及交叉验证实战指南
本文详解在深度学习训练中如何使用Keras进行数据切分,包括通过validation_split自动切分验证集和结合Sklearn手动指定验证集两种方法。同时深入解析K折交叉验证原理,展示利用StratifiedKFold进行分层抽样的完整代码示例,并厘清训练集、验证集与测试集的核心区别,帮助开发者更准确地评估模型泛化能力。
2026-10-14
24

本文详解在深度学习训练中如何使用Keras进行数据切分,包括通过validation_split自动切分验证集和结合Sklearn手动指定验证集两种方法。同时深入解析K折交叉验证原理,展示利用StratifiedKFold进行分层抽样的完整代码示例,并厘清训练集、验证集与测试集的核心区别,帮助开发者更准确地评估模型泛化能力。
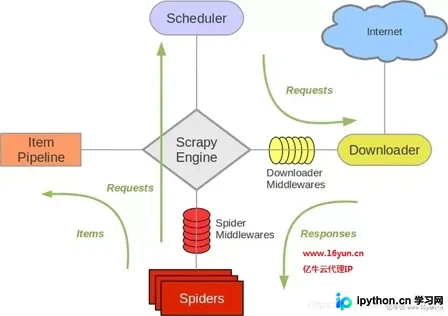
本文介绍如何利用Scrapy框架结合Puppeteer技术解决动态网页抓取难题。Scrapy作为高性能Python爬虫框架,通过集成Pyppeteer中间件,可模拟Chrome浏览器执行JavaScript,从而获取JS渲染后的HTML内容。文章详细解析了Scrapy核心组件及Puppeteer的配置方法,帮助开发者轻松实现复杂动态页面的数据提取。
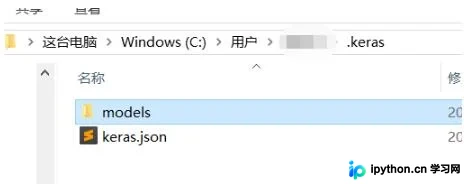
本文介绍在Windows环境下,如何通过Anaconda Prompt使用Python命令查询TensorFlow(CPU/GPU版本)及Keras的具体安装目录。同时补充说明Keras模型文件的默认存储路径(C:\Users\user_name\.keras)及models文件夹的作用,帮助用户快速定位资源文件。
本文解析Go语言中map的完整使用方法。首先介绍如何使用make函数创建map以及使用结构体文法初始化,避免nil指针错误。随后演示增、删、改、查的基本语法,重点讲解如何通过双赋值机制检测键是否存在,并指出读出不存在的键将返回零值而非报错。
本文解释Python中RC1(Release Candidate)即发布候选版的含义。RC1是正式版本发布前的测试预览版,旨在让用户验证新安全性和错误修复。文章列举了Python 3.7.1rc1、3.6.7rc1及3.8.1rc1的发布情况,说明若未发现问题,最终版代码将保持不变,但RC版本不建议用于生产环境。
本文详解Python中创建多进程的三种常用方法。通过实例解析multiprocessing模块中的Process类,涵盖参数传递、常用方法及属性;介绍通过继承Process类处理复杂任务的技巧;并深入讲解利用Pool进程池管理大量进程的非阻塞与阻塞调用方式,帮助开发者提升程序运行效率。
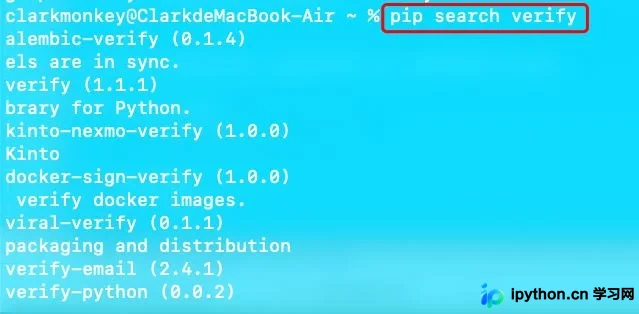
本文详细解析Python虚拟环境的必要性及创建方法,涵盖macOS/Linux与Windows系统的操作步骤。重点介绍利用pip命令进行包的安装、卸载、更新及环境导出,帮助开发者有效隔离项目依赖,避免版本冲突,提升开发效率与项目可维护性。
本文详解Python爬虫中常见的403禁止访问及网络超时问题。通过模拟浏览器User-Agent解决反爬限制,利用requests模块设置timeout参数处理超时,并演示如何捕获ReadTimeout、HTTPError等具体异常类,提升爬虫稳定性。
本文深入解析Python中正则表达式的高级应用,涵盖非贪婪模式、分组匹配、反向引用、命名分组及先行断言等核心概念。通过具体代码示例,演示如何精确控制匹配行为,解决HTML标签匹配、特定格式提取等实际问题,并介绍相关标记参数,帮助开发者提升文本处理效率。
本文详细解析JavaScript的词法结构基础,涵盖Unicode字符集支持、区分大小写特性、注释规范及直接量格式。重点梳理标识符命名规则与保留字限制,并深度剖析可选分号背后的自动补全逻辑(ASI),帮助开发者规避因换行和符号引发的语法歧义风险。
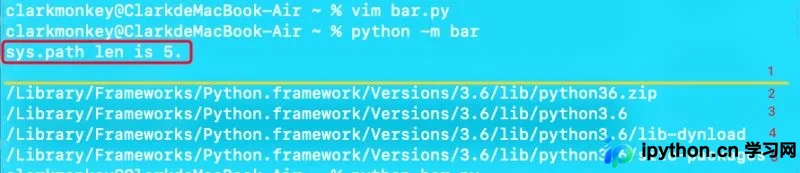
本文深入解析Python中-m参数的作用,对比python -m与直接运行.py文件的区别。重点说明sys.path路径差异、模块搜索机制及-m支持的特殊语法,帮助开发者正确使用模块作为脚本运行。
本文深入解析Python中私有属性和私有方法的实现机制与应用场景。通过双下划线前缀实现名称改写,Python在保持语言开放性的同时提供了数据封装能力。文章详细探讨了敏感数据保护、接口简化等实际应用场景,并结合代码实例对比了公有、受保护及私有属性的访问差异,帮助开发者理解如何在Python中合理运用封装特性。