Python Selenium 元素等待机制详解:显式与隐式等待
本文详细介绍 Python Selenium 中两种核心元素等待机制:显式等待与隐式等待。通过 WebDriverWait 类结合 expected_conditions 实现精准的元素状态检测,以及利用 implicitly_wait 设置全局超时轮询。文章包含完整代码示例与参数解析,帮助开发者解决页面加载不同步导致的定位失败问题,提升爬虫稳定性。
2026-10-14
21

本文详细介绍 Python Selenium 中两种核心元素等待机制:显式等待与隐式等待。通过 WebDriverWait 类结合 expected_conditions 实现精准的元素状态检测,以及利用 implicitly_wait 设置全局超时轮询。文章包含完整代码示例与参数解析,帮助开发者解决页面加载不同步导致的定位失败问题,提升爬虫稳定性。
本文详解Python Selenium中关闭浏览器的两种方法:close()用于关闭当前窗口,quit()用于关闭所有窗口并释放驱动。通过代码示例展示如何在多窗口场景下遍历句柄并逐一关闭,帮助开发者正确管理浏览器资源。
本文整理了 JavaScript 中常用的 DOM 事件列表,涵盖一般鼠标键盘事件、页面加载与状态事件、表单交互、剪贴板与拖拽编辑事件、数据绑定及打印等外部事件。通过分类汇总帮助前端开发者快速查找特定事件的触发条件与作用对象,提升开发效率。
本文详细介绍如何使用Selenium获取网页登录Cookies并添加Cookies实现自动登录。包括get_cookies()、add_cookie()等关键方法的使用,以及模拟登录和添加Cookies的具体代码示例。
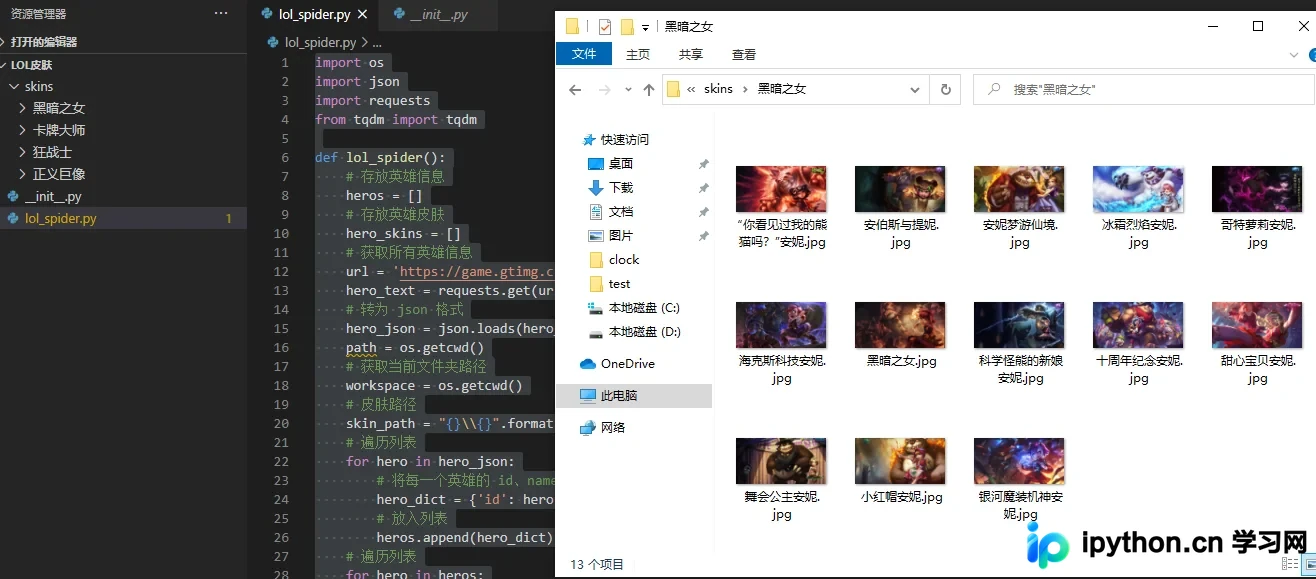
本文提供使用 Python 爬取并下载英雄联盟英雄皮肤的完整示例。通过调用官方接口获取英雄列表,遍历每个英雄获取其皮肤图片链接,并自动创建文件夹保存高清皮肤图片。代码包含完整的请求、解析及文件保存逻辑,适合 Python 初学者学习网络爬虫基础。
本文通过服务器端和客户端的C语言代码,详细展示了基于TCP协议的Socket基本通信流程。涵盖socket创建、bind绑定、listen监听、accept接受连接以及fork分叉处理并发请求的步骤,适合初学者理解Linux下的网络程序设计。
本文详解Python Selenium中处理JavaScript三种弹窗(Alert、Confirm、Prompt)的方法。通过switch_to.alert定位弹窗,利用text获取内容,accept()确认,dismiss()取消,以及send_keys()输入文本。结合百度设置实例,展示完整操作流程与代码实现。
本文介绍在Windows环境下如何使用C++结合iphlpapi.h库中的GetAdaptersInfo函数,获取当前主机的物理MAC地址、IPv4地址及子网掩码。示例代码包含必要的头文件引入、内存分配策略及数据解析逻辑,适用于桌面端网络编程场景。
本文详细解析Python Selenium中ActionChains类的鼠标操作方法,涵盖右键点击、悬停、双击及拖拽等常用功能。通过百度和菜鸟教程的实战代码示例,演示如何定位元素并执行鼠标动作,特别针对iframe嵌套页面提供了切换框架的处理方案,帮助开发者掌握自动化测试中的复杂交互技巧。
本文详解Python Selenium中多窗口切换的核心方法。通过current_window_handle获取当前句柄,利用window_handles获取所有窗口列表,并结合switch_to.window()实现窗口切换。文章提供完整代码示例,演示从百度首页跳转至注册页后的窗口切换与标题打印逻辑,帮助开发者解决新窗口操作难题。
在开发大规模数据量的树形控件时,使用CSS背景图替代传统IMG标签常被认为能减少HTTP请求并提升性能。然而,实测发现当节点数达到500以上时,CSS背景图渲染会导致CPU占用率高达100%,展开/收起操作显著延迟。尤其在IE浏览器中,隐藏元素的父级操作也会触发重新渲染,导致严重性能瓶颈。本文总结测试结果,建议在高动态场景下谨慎使用该方案。
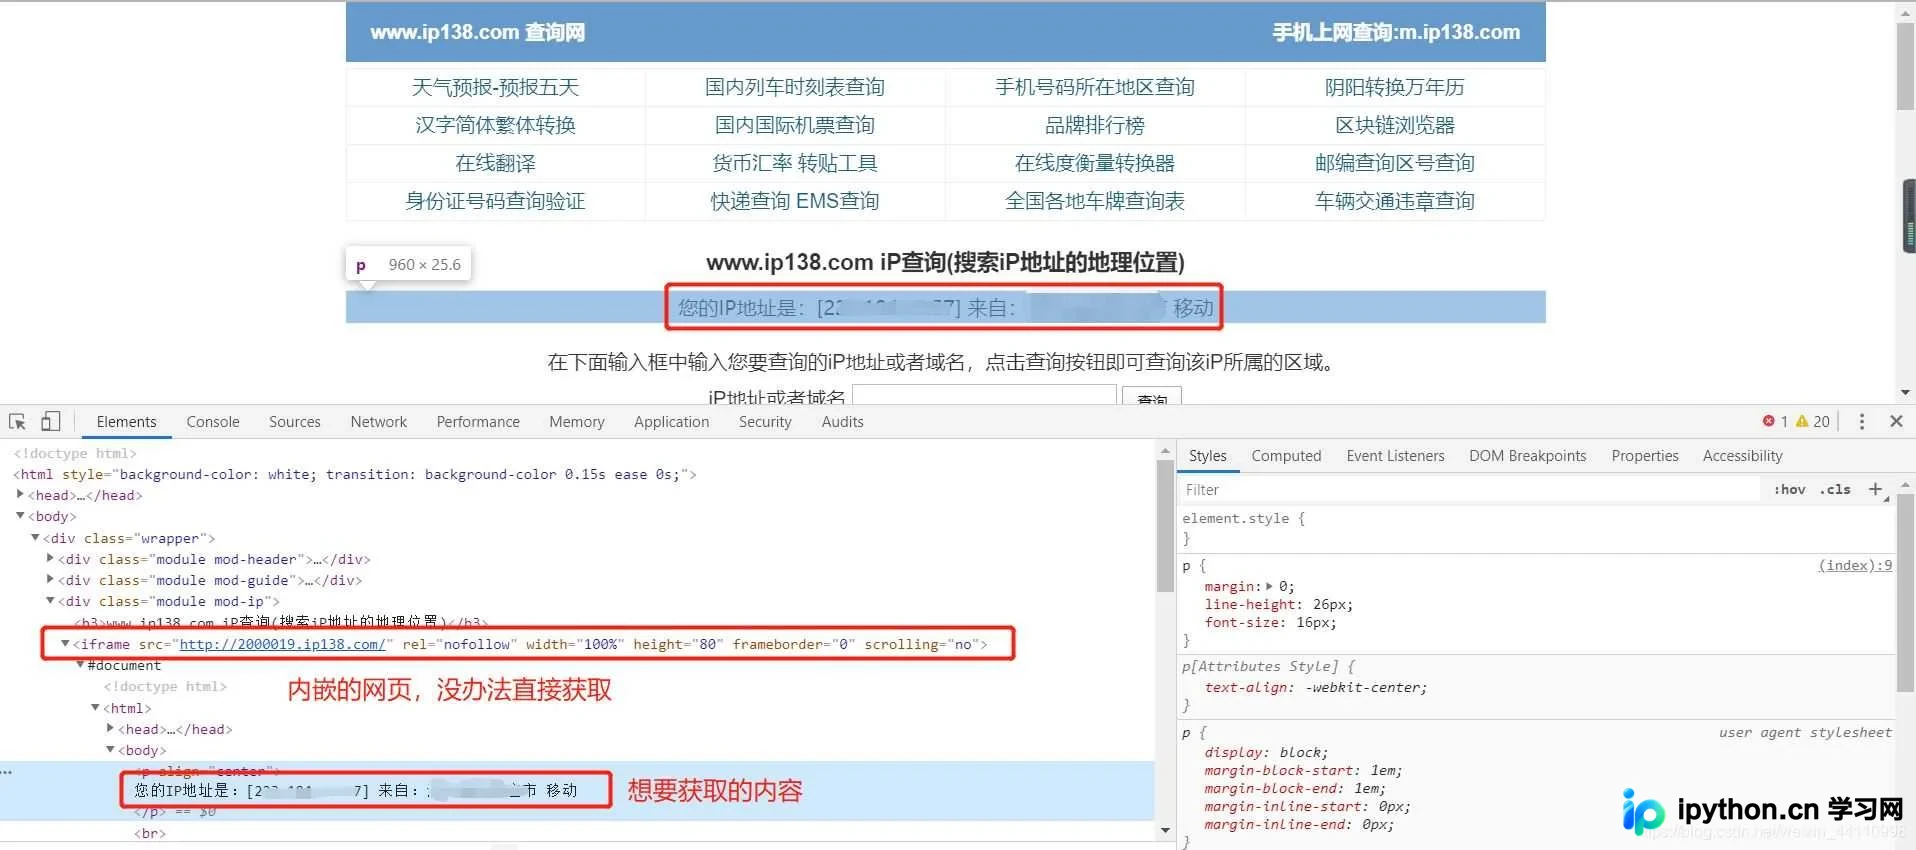
本文介绍在Python Selenium爬虫开发中,如何处理Web页面常见的frame/iframe表单嵌套问题。通过switch_to.frame()方法切换至内嵌页面进行元素定位,并使用switch_to.parent_frame()或default_content()退出嵌套,结合ip138实例代码演示完整操作流程。