

Python 实现英雄联盟皮肤自动爬取与下载

发布时间:2026-10-14| 5人浏览过
本文提供使用 Python 爬取并下载英雄联盟英雄皮肤的完整示例。通过调用官方接口获取英雄列表,遍历每个英雄获取其皮肤图片链接,并自动创建文件夹保存高清皮肤图片。代码包含完整的请求、解析及文件保存逻辑,适合 Python 初学者学习网络爬虫基础。
Python 爬取英雄联盟皮肤示例
本次爬取任务的目标是获取英雄联盟所有英雄的皮肤图片。
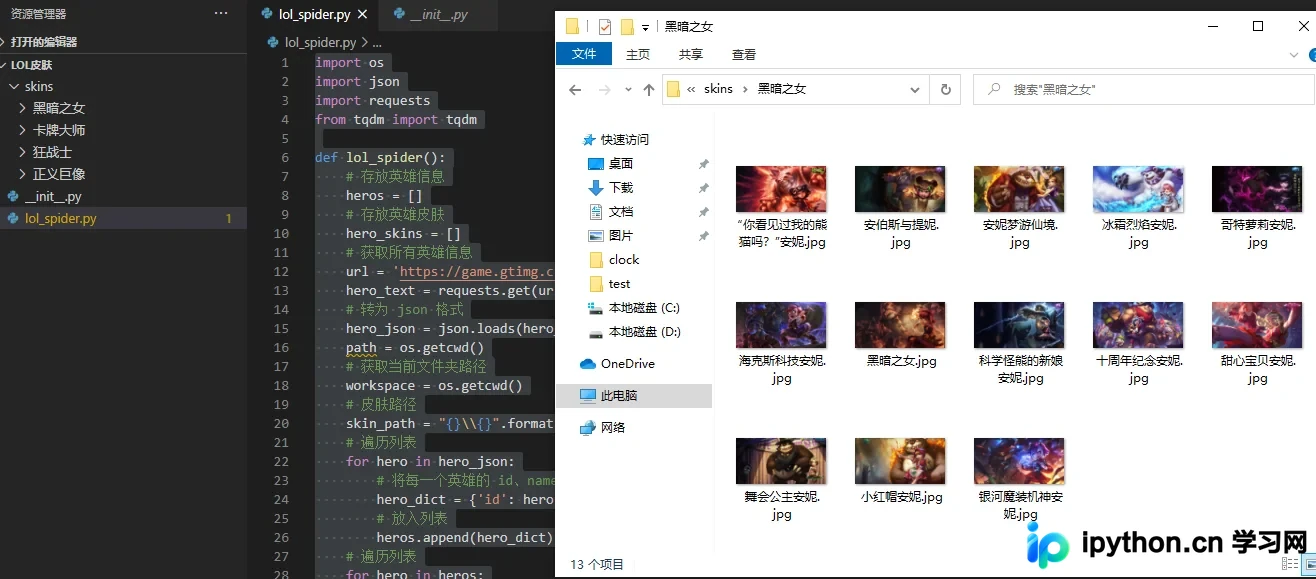
以下是实现该功能的 Python 代码示例。
import os
import json
import requests
from tqdm import tqdm

def lol_spider():
  # 存放英雄信息
  heros = []
  # 存放英雄皮肤
  hero_skins = []
  # 获取所有英雄信息
  url = 'https://game.gtimg.cn/images/lol/act/img/js/heroList/hero_list.js'
  hero_text = requests.get(url).text
  # 转为 json 格式
  hero_json = json.loads(hero_text)['hero']
  path = os.getcwd()
  # 获取当前文件夹路径
  workspace = os.getcwd()
  # 皮肤路径
  skin_path = "{}\\{}".format(workspace, 'skins')
  # 遍历列表
  for hero in hero_json:
    # 将每一个英雄的 id、name 放入一个字典中
    hero_dict = {'id': hero['heroId'], 'name': hero['name']}
    # 放入列表
    heros.append(hero_dict)
  # 遍历列表
  for hero in heros:
    hero_id = hero['id']
    hero_name = hero['name']
    # 为每一个英雄创建一个以自己名字命名的文件夹,用来存放皮肤图片
    dir_name = skin_path + '\\{}'.format(hero_name)
    if not os.path.exists(dir_name):
      os.mkdir(dir_name)
    # 进入文件夹
    os.chdir(dir_name)
    # 根据每一个英雄的 id 生成皮肤信息的 url
    hero_skin_url = 'https://game.gtimg.cn/images/lol/act/img/js/hero/' + hero_id + '.js'
    # 通过 url 获取英雄的皮肤数量
    skin_text = requests.get(hero_skin_url).text
    skin_json = json.loads(skin_text)
    skin_list = skin_json['skins']
    # 获取皮肤名
    hero_skins.clear()
    for skin in skin_list:
      hero_skins.append(skin['name'].replace('/', '').replace('\\', '').replace(' ', ''))
    # 皮肤数量
    skins_num = len(hero_skins)
    s = ''
    for i in tqdm(range(skins_num), desc='【' + hero_name + '】皮肤下载'):
      if len(str(i)) == 1:
        s = '00' + str(i)
      elif len(str(i)) == 2:
        s = '0' + str(i)
      elif len(str(i)) == 3:
        pass
      try:
        # 拼接指定皮肤的 url
        skin_url = 'https://game.gtimg.cn/images/lol/act/img/skin/big' + hero_id + '' + s + '.jpg'
        img = requests.get(skin_url)
      except:
        # 没有炫彩皮肤 url 则跳过
        continue
      # 保存皮肤图片
      if img.status_code == 200:
        with open(hero_skins[i] + '.jpg', 'wb') as f:
          f.write(img.content)


if __name__ == '__main__':
  lol_spider()
以上即为使用 Python 爬取并下载英雄联盟皮肤的完整示例。如需获取更多关于 Python 爬虫技术的信息,建议关注本站发布的其他相关文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









