

详解使用scrapy进行模拟登陆三种方式
本文详细介绍在Scrapy框架中实现模拟登录的三种核心方式:直接携带Cookies、使用FormRequest发送POST请求以及利用from_response自动解析表单。通过GitHub登录示例,解析代码逻辑与配置要点,帮助开发者掌握不同场景下的最佳实践。
2026-10-14
21

本文详细介绍在Scrapy框架中实现模拟登录的三种核心方式:直接携带Cookies、使用FormRequest发送POST请求以及利用from_response自动解析表单。通过GitHub登录示例,解析代码逻辑与配置要点,帮助开发者掌握不同场景下的最佳实践。
MySQL 执行 GROUP BY 时通常需创建临时表,但可通过索引优化避免。本文详解两种高级扫描方式:松散索引扫描(要求全最左前缀且仅用 MIN/MAX)和紧凑索引扫描(利用范围条件或常量覆盖填补索引漏洞)。通过具体 SQL 示例分析适用条件与禁忌,帮助提升查询效率。
本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
本文解析MySQL中Open_tables与Opened_tables的区别及监控方法。通过对比这两个指标,判断table_open_cache(原table_cache)配置是否合理。提供计算公式与建议阈值,帮助DBA优化内存使用,减少文件描述符开销,提升数据库并发性能。
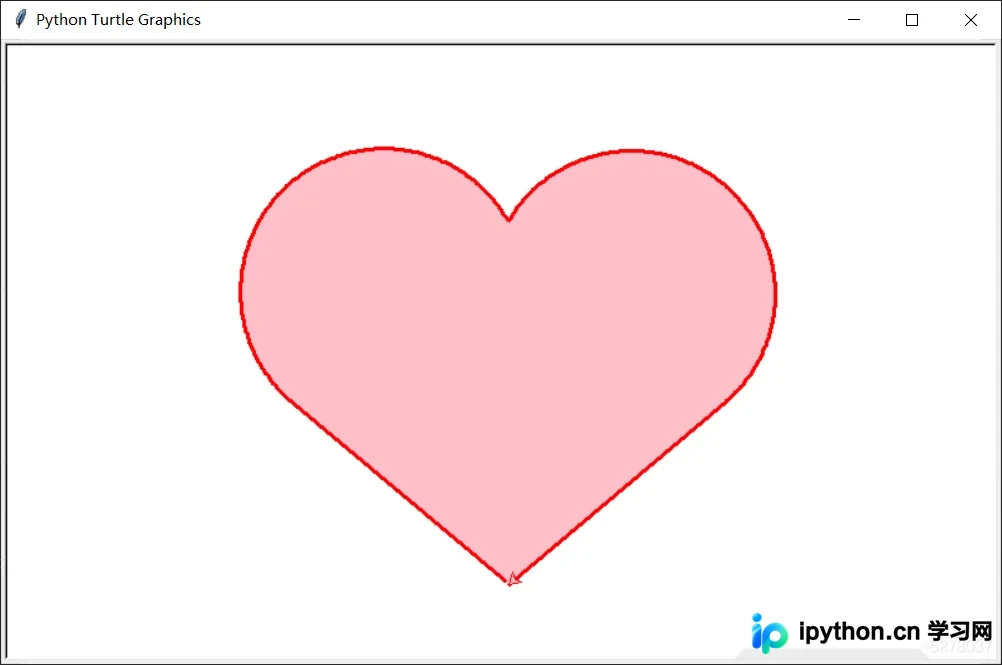
本文详细介绍如何使用Python的Turtle库绘制静态爱心及动态发射爱心的小人。通过解析两段完整源码,涵盖窗口设置、路径规划、圆弧绘制及文字输出等关键步骤,帮助开发者快速掌握基础图形绘制技巧与动画实现逻辑。
本文详细介绍如何使用Python和Pygame库开发一款猴子摘桃小游戏。内容涵盖项目文件目录结构、图片资源(monkey.png、background.jpg、apple.png)的配置方法,以及在PyCharm中修改代码路径的具体步骤。附带完整源代码及运行截图,适合Python初学者进行实战练习。
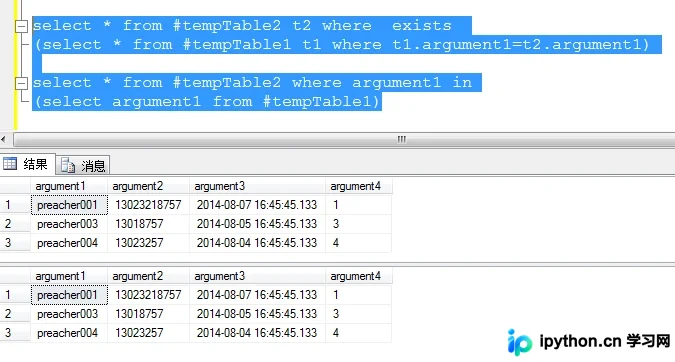
在SQL Server查询优化中,IN和EXISTS的选择对执行效率有显著影响。通常NOT EXISTS优于NOT IN,因其支持嵌套循环算法;而EXISTS可能不如IN高效,因后者常使用哈希合并。本文通过临时表示例,详解两种写法求交集与差集的操作方法,帮助开发者掌握最佳实践。
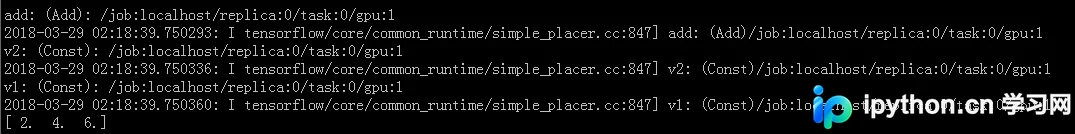
本文详细介绍如何在TensorFlow中使用tf.device()指定模型运行的具体设备,包括GPU和CPU的选择。通过示例代码展示如何指定特定GPU运行Session,以及如何配置ConfigProto打印设备放置信息。同时解释了默认情况下Session在GPU:0上运行的机制,以及如何将计算指定到CPU。
本文详解MySQL中UPDATE语句的核心语法与实战技巧,涵盖单表基础更新、多表关联更新、修饰符使用及性能优化要点。通过具体代码示例,展示如何利用WHERE条件精准定位、SET子句批量赋值,以及处理并发与事务时的安全策略,帮助开发者高效且安全地管理数据库数据。
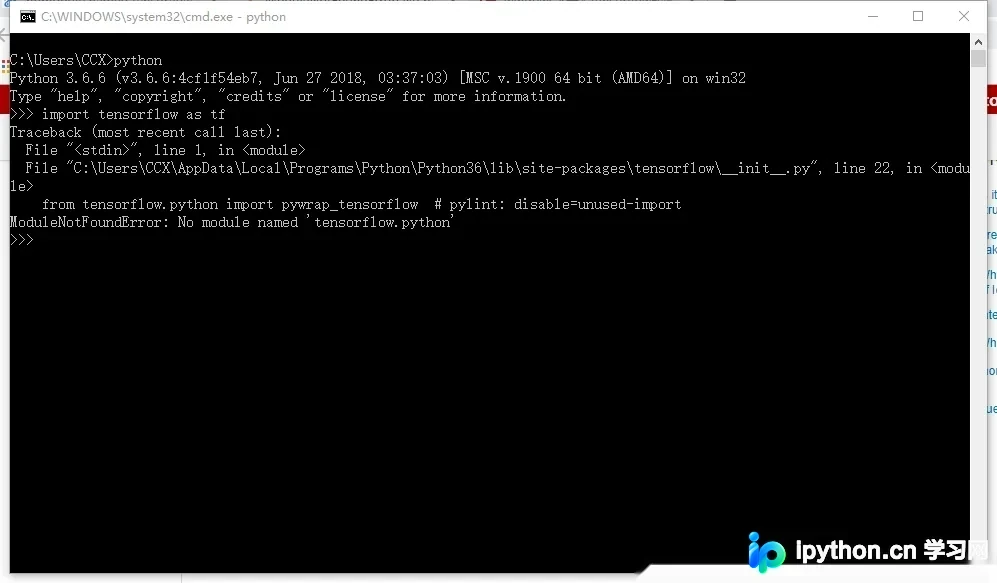
本文针对使用pip安装TensorFlow后运行Python报错“no module named tensorflow.python”的问题提供解决方案。该错误通常因pip未将库安装至Python 3目录所致,建议改用pip3命令重新安装以匹配Python版本,确保模块路径正确。
本文介绍 TensorFlow 官方提供的自动升级脚本 tf_upgrade.py,用于将 0.n 版本代码迁移至 1.0。涵盖单文件与目录批量更新命令、参数配置及局限性说明,帮助开发者高效完成版本兼容处理。
本文详细介绍在Python3爬虫项目中安装RedisDump的方法。由于RedisDump基于Ruby实现,需先配置Ruby环境及rvm工具。文章涵盖通过gem命令安装redis-dump的详细步骤,包括国内源配置、版本验证及命令测试,帮助开发者顺利完成Redis数据迁移工具的部署。