

Python+Pygame实现猴子摘桃游戏完整教程
本文详细介绍如何使用Python和Pygame库开发一款猴子摘桃小游戏。内容涵盖项目文件目录结构、图片资源(monkey.png、background.jpg、apple.png)的配置方法,以及在PyCharm中修改代码路径的具体步骤。附带完整源代码及运行截图,适合Python初学者进行实战练习。
2026-10-14
24

本文详细介绍如何使用Python和Pygame库开发一款猴子摘桃小游戏。内容涵盖项目文件目录结构、图片资源(monkey.png、background.jpg、apple.png)的配置方法,以及在PyCharm中修改代码路径的具体步骤。附带完整源代码及运行截图,适合Python初学者进行实战练习。
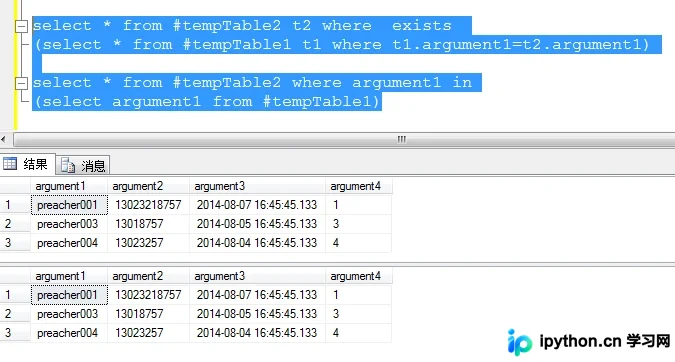
在SQL Server查询优化中,IN和EXISTS的选择对执行效率有显著影响。通常NOT EXISTS优于NOT IN,因其支持嵌套循环算法;而EXISTS可能不如IN高效,因后者常使用哈希合并。本文通过临时表示例,详解两种写法求交集与差集的操作方法,帮助开发者掌握最佳实践。
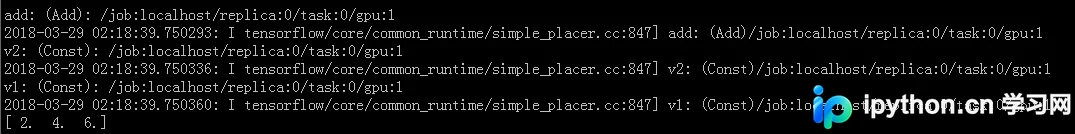
本文详细介绍如何在TensorFlow中使用tf.device()指定模型运行的具体设备,包括GPU和CPU的选择。通过示例代码展示如何指定特定GPU运行Session,以及如何配置ConfigProto打印设备放置信息。同时解释了默认情况下Session在GPU:0上运行的机制,以及如何将计算指定到CPU。
本文详解MySQL中UPDATE语句的核心语法与实战技巧,涵盖单表基础更新、多表关联更新、修饰符使用及性能优化要点。通过具体代码示例,展示如何利用WHERE条件精准定位、SET子句批量赋值,以及处理并发与事务时的安全策略,帮助开发者高效且安全地管理数据库数据。
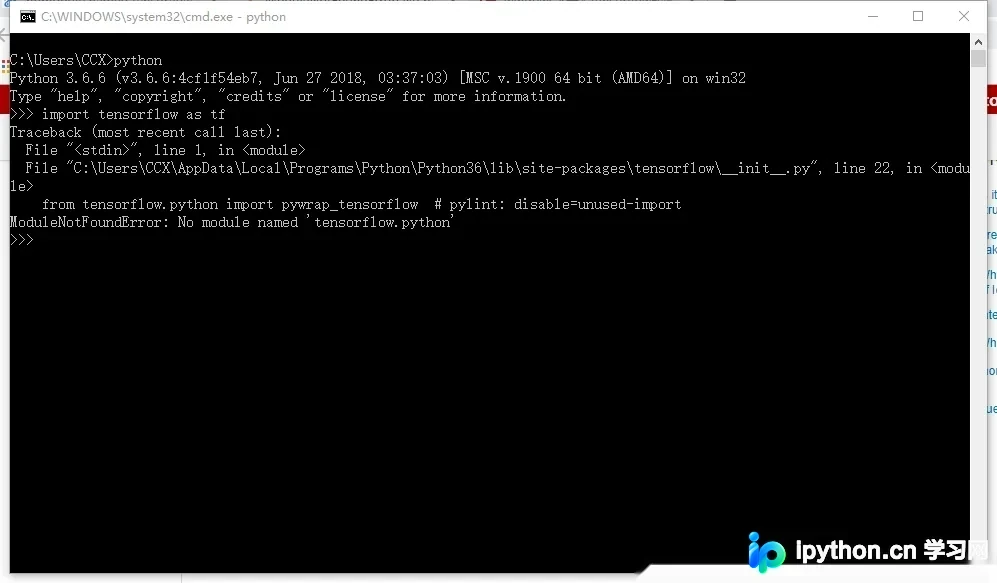
本文针对使用pip安装TensorFlow后运行Python报错“no module named tensorflow.python”的问题提供解决方案。该错误通常因pip未将库安装至Python 3目录所致,建议改用pip3命令重新安装以匹配Python版本,确保模块路径正确。
本文介绍 TensorFlow 官方提供的自动升级脚本 tf_upgrade.py,用于将 0.n 版本代码迁移至 1.0。涵盖单文件与目录批量更新命令、参数配置及局限性说明,帮助开发者高效完成版本兼容处理。
本文详细介绍在Python3爬虫项目中安装RedisDump的方法。由于RedisDump基于Ruby实现,需先配置Ruby环境及rvm工具。文章涵盖通过gem命令安装redis-dump的详细步骤,包括国内源配置、版本验证及命令测试,帮助开发者顺利完成Redis数据迁移工具的部署。
针对MySQL中LIMIT查询在大偏移量下的性能瓶颈,本文通过对比实验分析了直接LIMIT与基于主键ID的范围查询两种策略。实验表明,当偏移量较小时直接使用LIMIT更高效;而在处理第10000页之后的大偏移场景时,采用“WHERE id >= (SELECT id ... LIMIT offset, 1) LIMIT page_size”的子查询方式可将耗时从约0.018秒降至0.006秒左右,显著提升响应速度。
本文详细介绍如何使用Python的multiprocessing.dummy模块实现线程池爬虫,以梨视频为例演示短视频的批量抓取与下载。内容涵盖URL解析、动态链接拼接、文件命名冲突处理及并发下载优化,提供完整代码示例与关键技术点解析,帮助开发者掌握高效网络爬虫开发技巧。
本文介绍如何使用 Node.js 自带的 n 模块快速切换和管理不同版本的 Node.js。通过安装 n 全局包,仅需一条 'n stable' 或指定版本号即可升级,同时附带 npm 常用操作命令以优化开发流程。
本文介绍使用Python编写爬虫程序,通过BeautifulSoup解析网页获取视频URL,并利用迅雷COM接口实现自动批量下载的方法。代码包含获取最新网址、分页处理、URL提取及调用迅雷一键下载功能,适合需要自动化视频采集场景的开发者参考。
本文详细解析Python爬虫中因缺少User-Agent标识导致请求被拒的问题,并提供使用requests库进行UA伪装的完整代码示例。通过模拟Chrome浏览器头部信息,有效绕过门户网站的简单反爬检测,实现正常数据抓取。