

JavaScript按位异或(^)运算符:原理与实战应用
本文介绍JavaScript中按位异或(^)运算符的工作原理。通过对比二进制位,当且仅当一位为1时结果为1,否则为0。该运算符常用于变量交换、权限控制及哈希计算等底层逻辑处理场景。
2026-10-14
21

本文介绍JavaScript中按位异或(^)运算符的工作原理。通过对比二进制位,当且仅当一位为1时结果为1,否则为0。该运算符常用于变量交换、权限控制及哈希计算等底层逻辑处理场景。
本文介绍了如何在Python中使用Matplotlib和Seaborn库绘制箱型图。通过具体代码示例,详细展示了箱型图的垂直/水平显示、异常值处理、箱体样式、均值线及缺口设置等关键参数的配置方法,帮助读者快速掌握数据分布可视化技巧。
本文通过Python代码实例,详细讲解如何构建一个基于控制台的简单名片管理系统。内容涵盖项目结构设计、主循环逻辑、菜单显示、名片的创建、遍历展示、条件查询以及修改与删除功能。通过实际代码片段,帮助读者理解列表与字典在数据存储中的应用,以及函数模块化编程的最佳实践。
本文通过 JavaScript 原生 DOM API,演示如何准确获取 HTML 表单中的特定输入元素,并执行数据清空操作。重点解析了通过 ID 定位表单、利用 name 属性访问内部控件的标准用法,帮助开发者掌握基础的前端表单交互逻辑。
本文详细讲解如何利用Python和requests库爬取百度翻译结果。通过浏览器开发者工具分析AJAX请求,定位fanyi.baidu.com/sug接口,构造包含kw参数的POST请求,并解析返回的JSON数据获取翻译内容。文章提供完整代码示例及注意事项,适合初学者学习动态网页数据抓取。
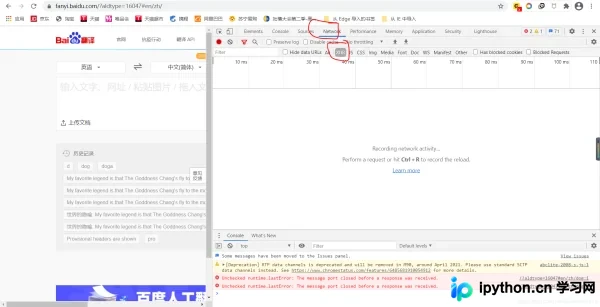
本文介绍Python爬虫中常见的反爬机制及应对策略。通过requests库发起请求时,若未设置User-Agent,服务器可能识别为爬虫并拒绝访问。文章详细演示了如何获取浏览器的User-Agent值,并在代码中通过headers字典进行UA伪装,从而成功抓取特定网页数据。
本文详细解析MySQL中InnoDB引擎外键的使用条件、定义语法及级联操作参数。涵盖建表时创建外键的具体SQL代码,以及ALTER TABLE添加外键的正确步骤,确保数据库关联数据的完整性与一致性。
本文详细介绍Python中Bs4库的安装方法及数据解析技巧。通过pip安装bs4和lxml后,结合requests库实现图片批量下载与文本内容爬取。文章提供完整代码示例,涵盖UA伪装、URL遍历及文件存储操作,帮助开发者快速掌握Bs4在爬虫中的应用。
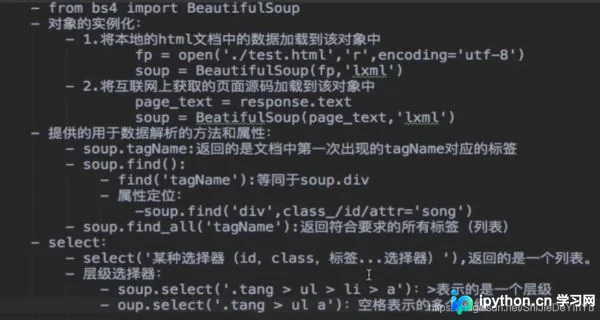
本文介绍Python爬虫的基础流程,包括指定URL、发送请求及数据存储三步。详细讲解requests外部库的安装方法,并通过完整代码示例演示如何爬取搜狗首页并保存为HTML文件,帮助初学者快速掌握网络数据抓取的基本操作。
本文详解Django中Cookie机制及其在反爬虫中的应用。通过解析request对象获取Cookie,利用set_cookie方法配置max_age、expires及path等关键参数,有效限制爬虫抓取频率并隐藏生成逻辑。结合代码示例,帮助开发者构建更安全的Web应用。
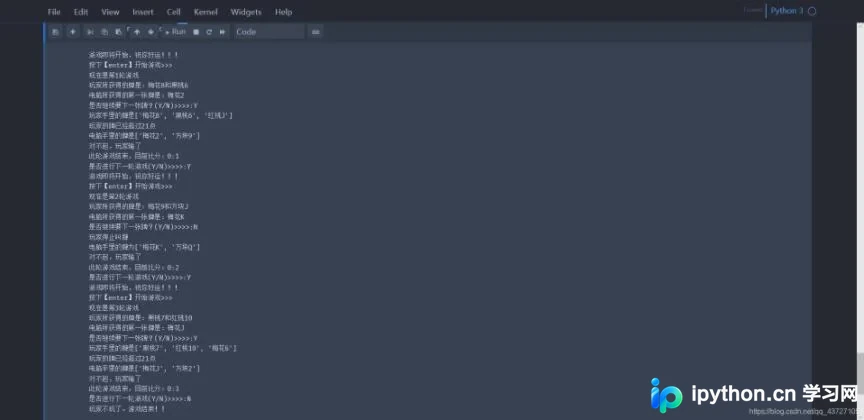
本文详细介绍如何使用Python语言实现经典的21点小游戏。内容涵盖扑克牌的初始化、洗牌算法、A牌点数动态计算规则以及多轮游戏的计分逻辑。通过完整代码示例,帮助开发者理解基础游戏逻辑与Python编程技巧的结合应用。
本文分享一个基于Microsoft Enterprise Library的C#日志记录帮助类LogHelper。该类封装了Info、Debug、Error等静太方法,通过LogEntry对象支持优先级、严重性级别及扩展属性的自定义记录。文章包含完整的C#代码示例以及在实际数据库查询中捕获异常并记录错误信息的实践用法。