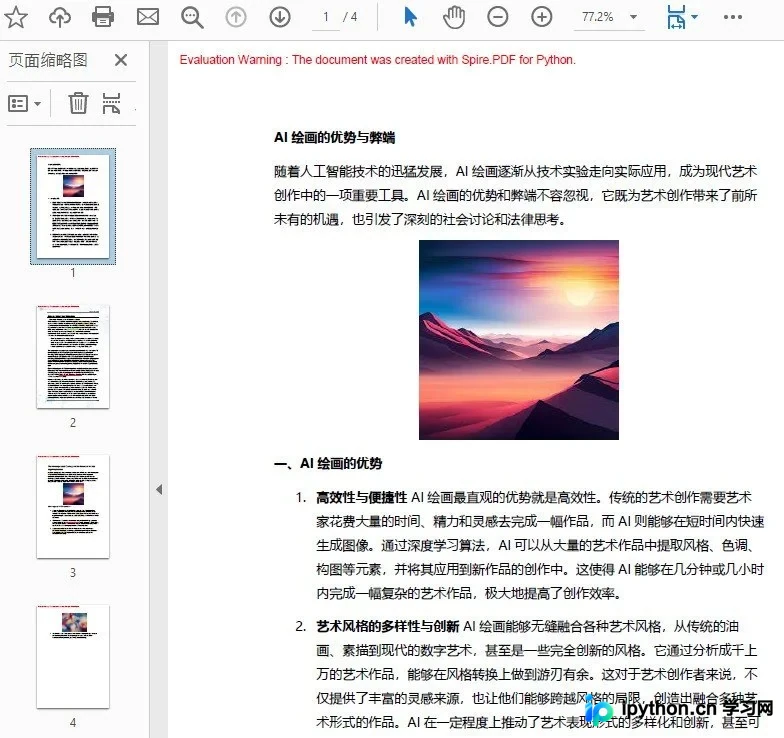
Python使用Spire.PDF合并多个PDF文件
在实际文档管理与企业流程中,经常需要将分散的合同附件、报告章节或多份独立文件整合为单一档案。本文详细说明如何使用 Python 配合 Spire.PDF 库完成多 PDF 合并任务,提供精准页面抽取、基于内存流合并以及文件夹批量处理的核心操作,帮助开发者快速构建自动化文档整合方案。
2026-10-10
14

在实际文档管理与企业流程中,经常需要将分散的合同附件、报告章节或多份独立文件整合为单一档案。本文详细说明如何使用 Python 配合 Spire.PDF 库完成多 PDF 合并任务,提供精准页面抽取、基于内存流合并以及文件夹批量处理的核心操作,帮助开发者快速构建自动化文档整合方案。
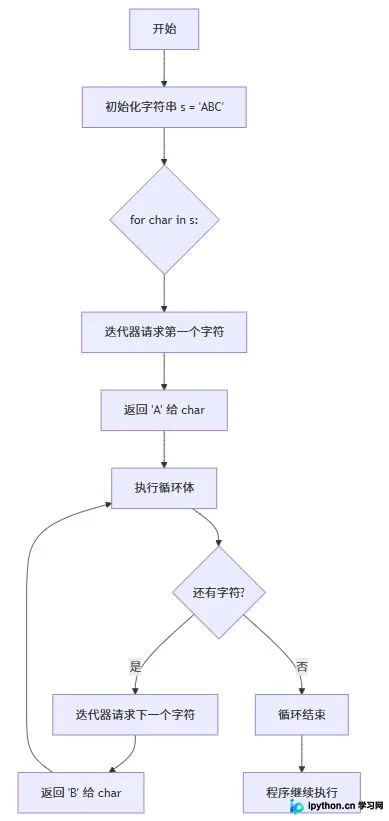
详细讲解在Python中如何利用for循环遍历字符串以逐个获取字符。涵盖基础迭代语法、字符统计与变换的实战示例,以及enumerate索引获取、列表推导式和高效join拼接等进阶技巧。同时提供常见错误排查,帮助开发者写出更高效的字符串处理代码。
本文详细梳理 Python 构建系统与包管理器 uv 的标准操作流程,涵盖命令行安装、虚拟环境隔离、依赖包管理、基于 pyproject.toml 的项目初始化及代码直运功能。通过对比传统 pip 与 poetry 的差异,提供可直接复制的高效终端指令,帮助开发者快速搭建现代化 Python 开发环境并规范多模块工程管理。
本文详解Pandas库处理时间序列数据的三大核心工具:滑动窗口用于捕捉局部动态,重采样用于调整时间粒度,趋势分析用于揭示长期走向。通过实际案例展示如何用简洁代码快速定位异常波动、转换数据频率并建立预测模型,助力物联网、金融和智能制造等领域的高效数据分析。
本文以贵州茅台股价为例,演示如何使用Python完成时间序列数据的获取、清洗与可视化分析。涵盖从依赖配置、缺失值填充,到绘制移动均线、季节性分解、自相关检测,再到利用Plotly制作交互式图表及3σ原则识别异常波动的全流程,助您快速掌握金融数据分析核心技巧。
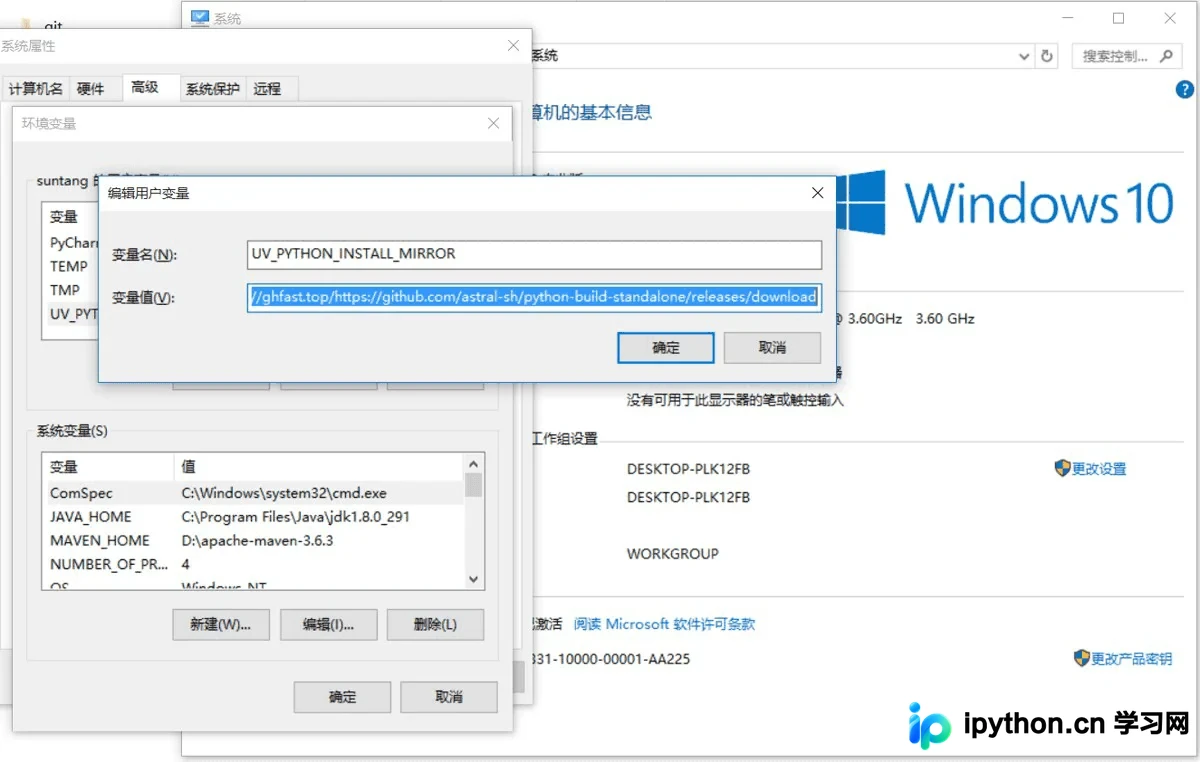
在使用 Python 包管理工具 uv 安装指定版本时,默认直连官方源会导致国内网络环境下载极慢或频繁超时。通过配置 UV_PYTHON_INSTALL_MIRROR 环境变量指向可用的镜像代理地址,即可显著提升获取速度并顺利完成 Python 版本的下载与安装。
本文系统梳理Python提取PDF内容的完整方案,涵盖pypdf、pdfplumber、PyMuPDF、Camelot及OCRmyPDF等主流工具。详解文本与坐标级提取、表格识别(lattice/stream模式)、扫描件OCR转换、图片/链接/注释/表单及元数据读取。提供批量处理、清洗分块及RAG对接的实战代码与常见坑避坑指南,助力知识库构建与自动化处理。
掌握Python数据可视化工具能快速提炼业务规律。本文以Matplotlib和Seaborn为核心,详解折线图、柱状图、散点图等基础图表及箱线图、热力图等高级图表的生成代码,结合Pandas内置绘图功能与多子图布局,提供完整可运行示例,帮助初学者快速搭建数据可视化工作流。
本文系统讲解 MySQL 逻辑备份原理与 mysqldump 命令行实操,涵盖全量恢复、Binlog 增量修复及自动化脚本编写。结合 Python pymysql 模块演示数据库连接、参数化增删改查、结果集提取与防注入的最佳实践,助力快速掌握数据安全与维护流程。
本文系统梳理Python NumPy中ndarray数组的元素访问方法与增删改查核心函数。涵盖切片与索引规则、append与insert插入机制、delete与条件过滤删除,以及直接赋值、切片覆盖、put定位与clip裁剪等修改技巧,附带标准代码示例与参数避坑说明。
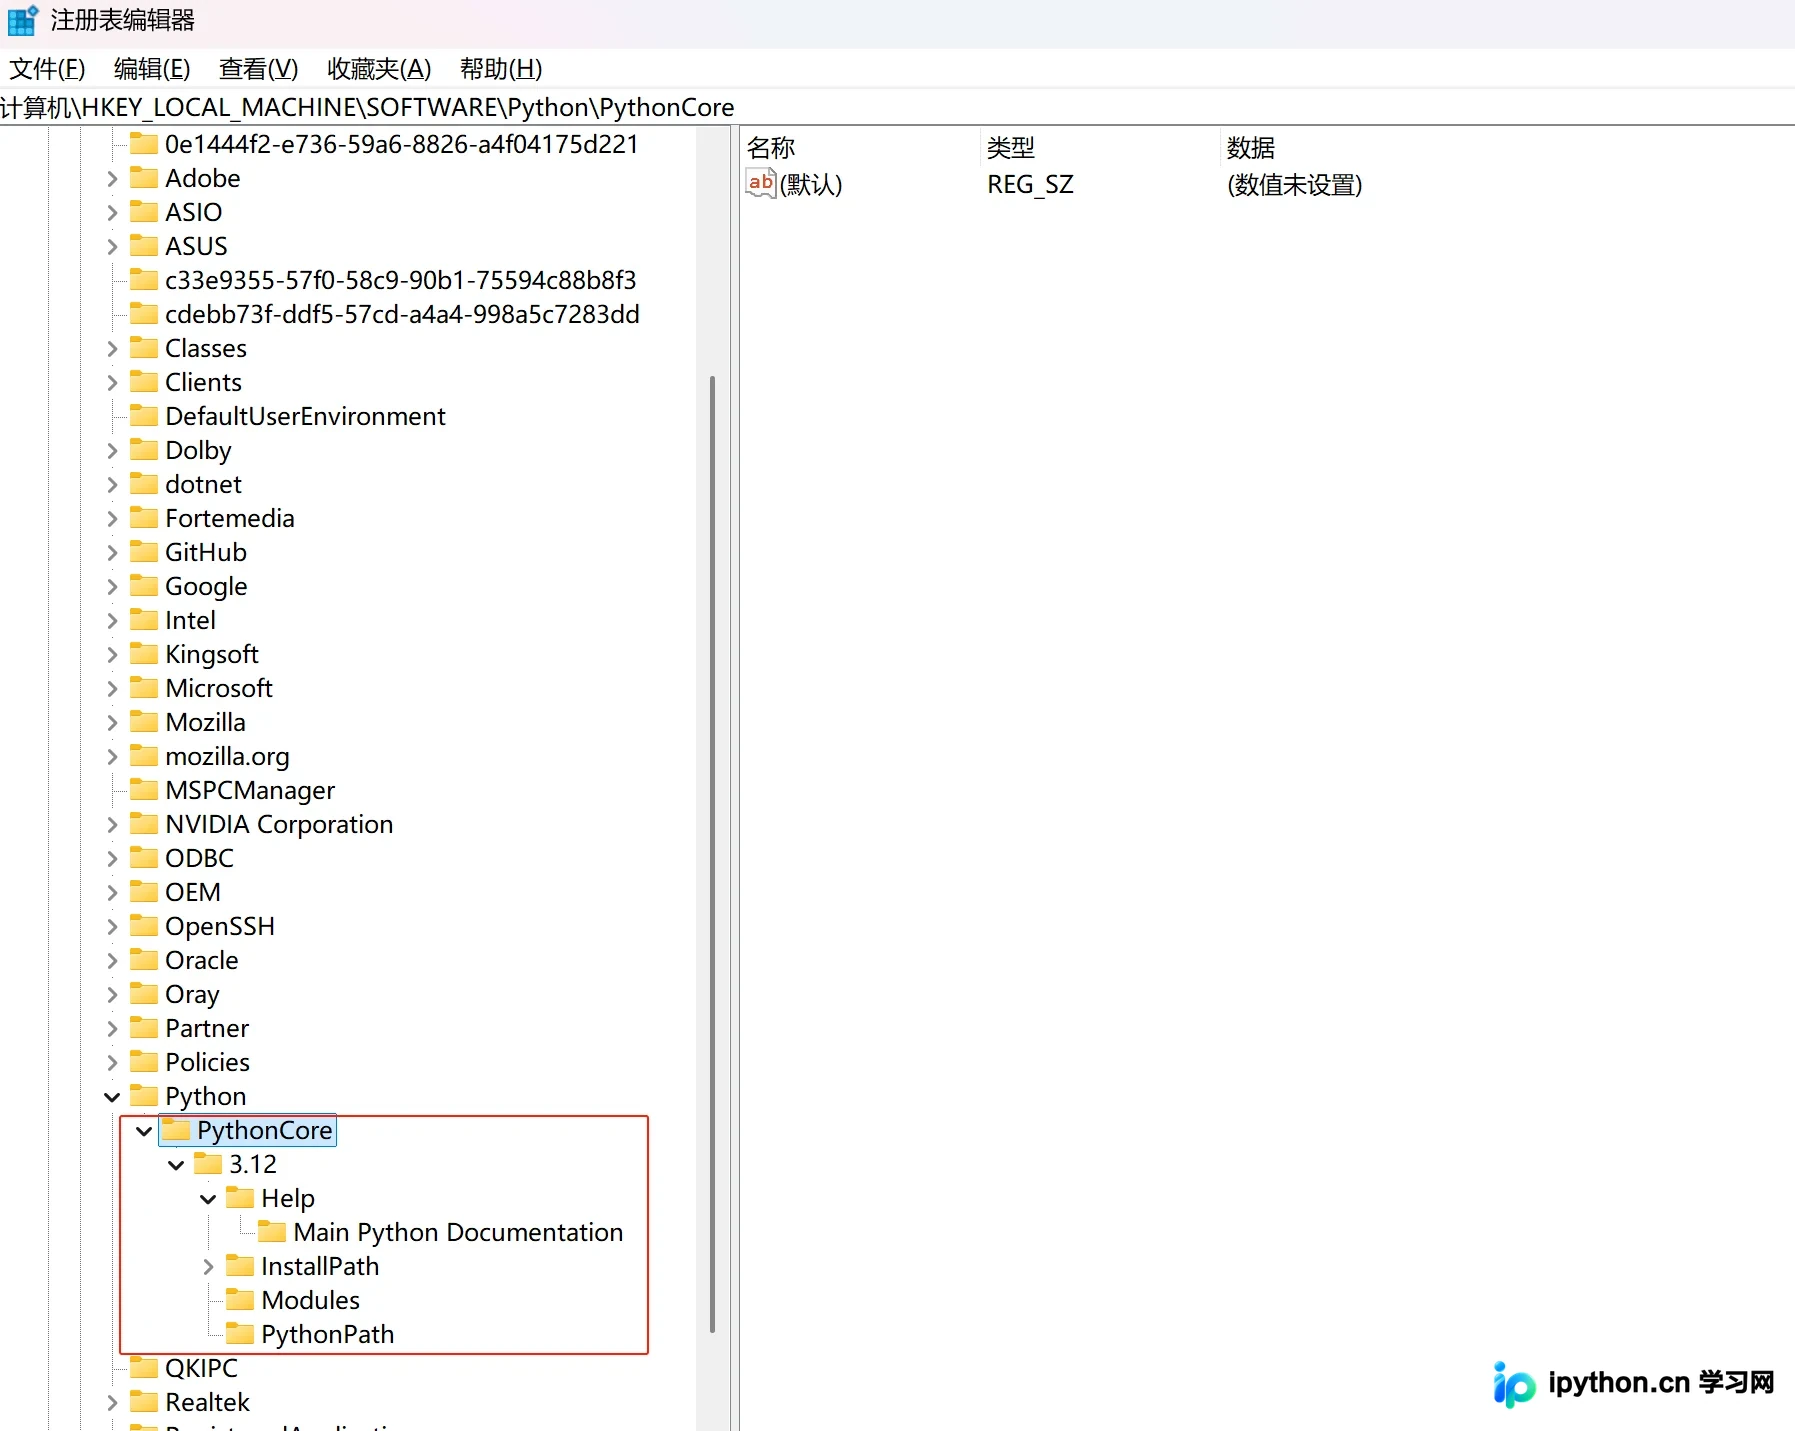
详细讲解在Windows系统中彻底卸载旧版Python的完整流程,涵盖控制面板移除、残留文件与注册表清理、环境变量重置,以及重新安装目标版本并验证环境的实操步骤。避免多版本路径冲突,保障开发环境纯净稳定。
Django项目中正确配置时区可避免多地区用户与服务器交互时的时间混乱。通过设置TIME_ZONE为本地时区并开启USE_TZ=True,框架会在接收前端请求、写入数据库及返回接口数据时自动完成UTC与本地时的双向转换。本文拆解完整的时间流转链路并提供核心验证方法。