

Python使用Spire.PDF合并多个PDF文件

在实际文档管理与企业流程中,经常需要将分散的合同附件、报告章节或多份独立文件整合为单一档案。本文详细说明如何使用 Python 配合 Spire.PDF 库完成多 PDF 合并任务,提供精准页面抽取、基于内存流合并以及文件夹批量处理的核心操作,帮助开发者快速构建自动化文档整合方案。
明确合并目标与适用场景
直接合并 PDF 能够有效保持原始排版与样式,避免格式转换带来的损耗。该操作适用于以下常规需求:
- 档案归集:将主合同、补充协议及附件整合为完整卷宗
- 报告汇编:按固定顺序将各分章或附录拼接成最终手册
- 分发简化:减少邮件附件数量,提升传输与查阅效率
准备开发环境
操作前需确保 Python 运行环境就绪,并通过 pip 安装对应的第三方组件:
pip install Spire.PDF安装完成后,脚本即可调用相关类库进行文档读取与写入。
第1步:通过索引精准插入指定页面
当需要打破原文档结构,仅提取特定页码或连续范围时,可使用 InsertPage 与 InsertPageRange 方法按需构建新文件。该方法允许精确控制每个页面的来源与落位顺序:
from spire.pdf import *
from spire.pdf.common import *

file1 = "示例1.pdf"
file2 = "示例2.pdf"
file3 = "示例3.pdf"
files = [file1, file2, file3]

pdfs = []
for file in files:
    doc = PdfDocument()
    doc.LoadFromFile(file)
    pdfs.append(doc)

newPdf = PdfDocument()
newPdf.InsertPage(pdfs[0], 0)
newPdf.InsertPage(pdfs[1], 1)
newPdf.InsertPageRange(pdfs[2], 0, 1)

newPdf.SaveToFile("output/复制页面合并PDF.pdf")
newPdf.Close()
for pdf in pdfs:
    pdf.Close()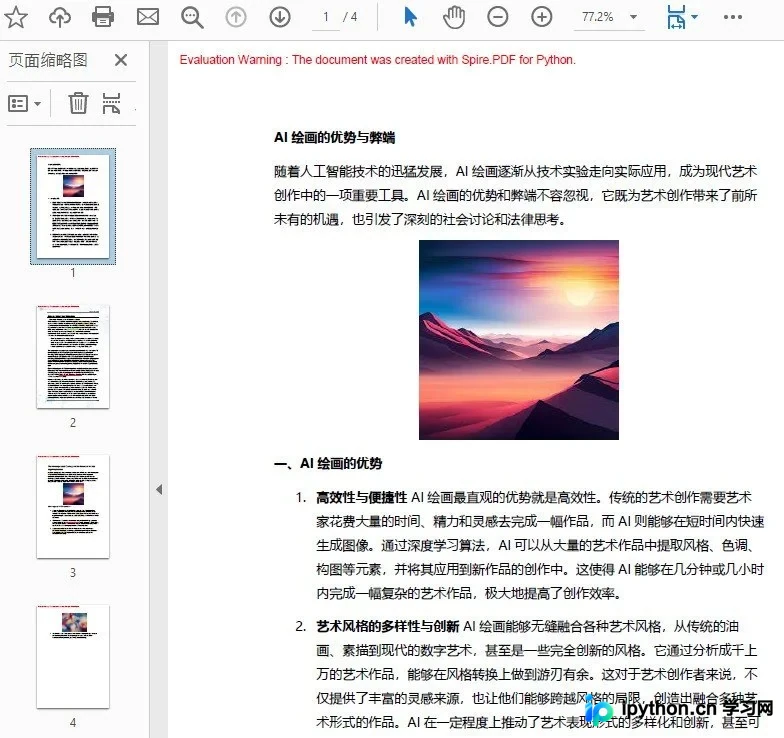
执行逻辑解析:
InsertPage(pdfs[i], index):从源文档提取单页并追加至新文档末尾。InsertPageRange(source_doc, start_index, end_index):连续提取起始到结束的页码区间,处理相邻章节时比循环调用单页插入更高效。
第2步:使用流对象直接合并数据
若输入源来自网络接口、数据库或内存缓冲,无需落地为临时磁盘文件,可直接利用流对象完成合并。此路径能显著降低磁盘 I/O 压力:
from spire.pdf.common import *
from spire.pdf import *

inputFile1 = "./Demos/Data/MergePdfsTemplate_1.pdf"
inputFile2 = "./Demos/Data/MergePdfsTemplate_2.pdf"
inputFile3 = "./Demos/Data/MergePdfsTemplate_3.pdf"
outputFile = Stream("MergeFilesByStream.pdf")

stream1 = Stream(inputFile1)
stream2 = Stream(inputFile2)
stream3 = Stream(inputFile3)

streams = [stream1, stream2, stream3]
mergeOp = MergerOptions()

PdfMerger.MergeByStream(streams, outputFile, mergeOp)
MergerOptions 可传入合并策略配置(如书签继承规则、元数据处理方式),未显式指定时采用库内默认安全策略。
第3步:批量处理文件夹内所有 PDF
面对目录级批量整合需求,可通过文件系统扫描结合排序算法,实现按名称顺序自动拼接。以下为可直接复用的核心函数:
from spire.pdf.common import *
from spire.pdf import *
import os
import glob

def MergePdfFolder(input_folder: str, output_file: str):
    pdf_files = sorted(glob.glob(os.path.join(input_folder, "*.pdf")))

    if not pdf_files:
        print("未找到 PDF 文件")
        return

    print(f"找到 {len(pdf_files)} 个 PDF 文件,开始合并...")

    main_doc = PdfDocument()
    main_doc.LoadFromFile(pdf_files[0])

    for i in range(1, len(pdf_files)):
        temp_doc = PdfDocument()
        temp_doc.LoadFromFile(pdf_files[i])
        main_doc.AppendPage(temp_doc)
        temp_doc.Close()

    main_doc.SaveToFile(output_file)
    main_doc.Close()
    print(f"合并完成!已归档至:{output_file}")

# 调用示例
MergePdfFolder("./待合并文档", "最终汇总.pdf")
该流程会自动忽略非 PDF 文件,并严格遵循字典序执行 AppendPage 追加操作,适合系列报告或标准化表单的流水线处理。
结果验证与排错建议
合并完成后建议进行以下核对,以确保输出符合预期:
- 页码连续性校验:打开结果文件检查总页数是否等于各源文件页数之和,确认缺失或重复页。
- 书签层级审查:多源合并可能残留独立目录树,建议在阅读器中展开大纲确认跳转路径是否合理。
- 横竖版混排处理:若混入横向扫描件,合并后会保留原始方向,查看时需适配阅读器显示比例。
- 大文件内存溢出:单次合并超过数百兆时,建议改用流式分块处理或增加系统堆内存限制。
核心要点总结
本文系统梳理了借助 Python 与 Spire.PDF 解决 PDF 聚合问题的标准路径:通过 InsertPage 实现碎片化页面的灵活拼装,借助 PdfMerger.MergeByStream 跳过磁盘中转提升吞吐,并利用文件系统遍历完成批量作业。掌握上述参数与流程后,可有效替代手动拖拽操作,满足企业级文档归档与自动化办公需求。
以上就是使用 Python 配合 Spire.PDF 库合并多个 PDF 文件的详细内容,更多关于 Python 自动化文档处理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









