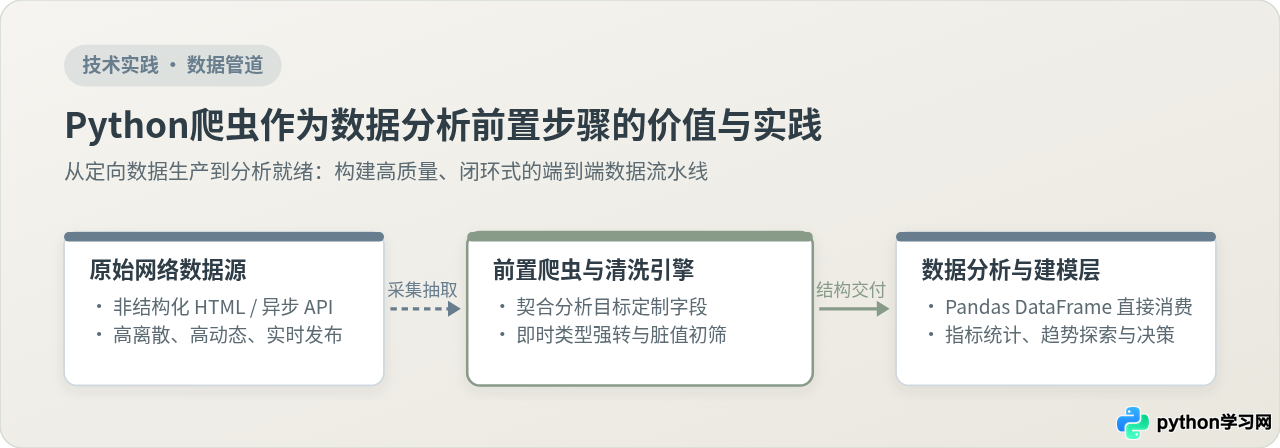
Python爬虫作为数据分析前置步骤的价值与实践
深入探讨Python爬虫作为数据分析前置输入层的核心价值与实践路径,涵盖从分析目标推导爬虫逻辑、结构化抽取、前置数据清洗到Pandas对接的完整流程与质量防线。
2026-11-08
9

深入探讨Python爬虫作为数据分析前置输入层的核心价值与实践路径,涵盖从分析目标推导爬虫逻辑、结构化抽取、前置数据清洗到Pandas对接的完整流程与质量防线。
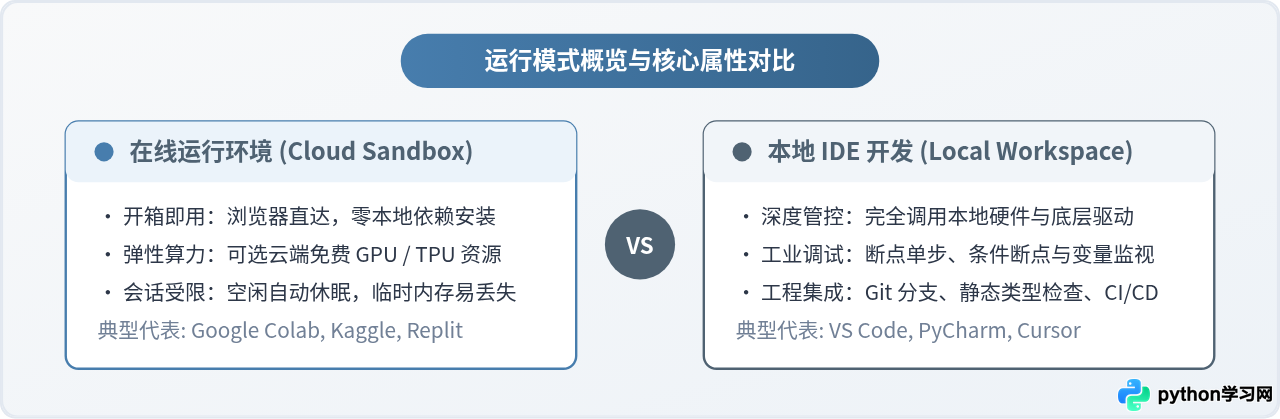
深入对比Python在线运行环境与本地IDE开发的架构机制、核心优势、主要局限、操作流程及选型决策依据,帮助开发者根据实际开发任务合理选择运行平台。
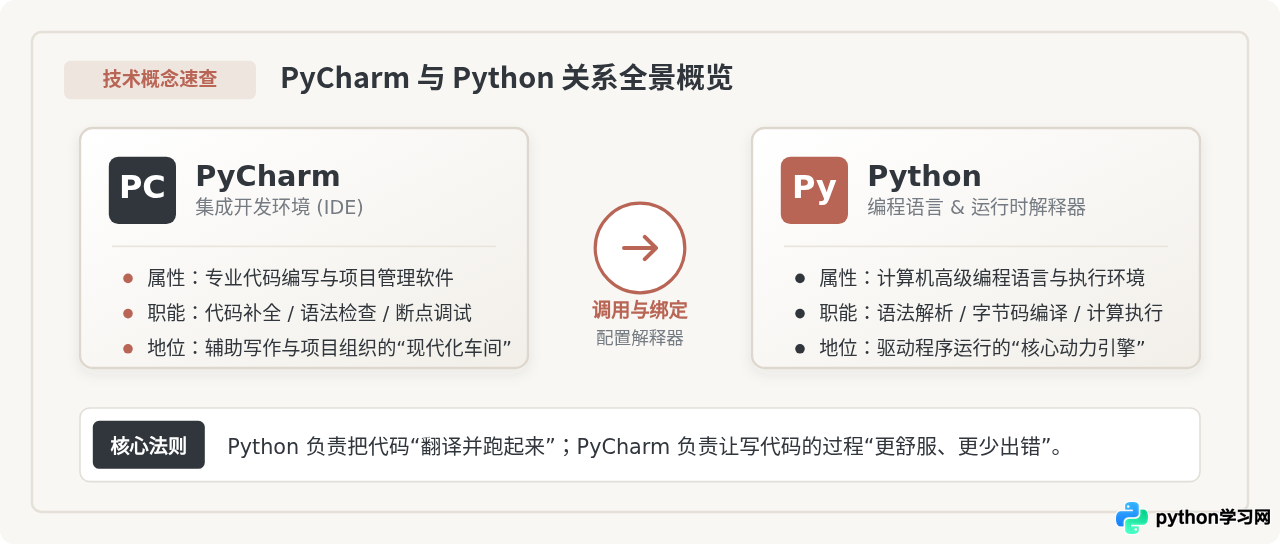
详细剖析PyCharm与Python的本质区别与协作关系。通过通俗比喻、核心分工对比、PyCharm配置Python解释器的具体步骤以及常见误区排查,帮助初学者彻底理清编程语言与开发工具的关系。
针对Windows版Excel,本文解析如何高效为连续或分散的单元格区域批量添加统一的下拉菜单。通过“数据验证”结合“选择性粘贴-验证”功能,避免逐格设置的低效与遗漏,确保录入规范的一致性,并说明后续维护选项来源时的注意事项。
本文针对企业引入AI办公工作台的选型困惑,提出以数据权限闭环和业务动作安全为核心的评估逻辑。通过解析知识库检索中的版本同步与权限继承风险,以及系统集成中写入操作的幂等性与身份隔离问题,提供具体的验收测试方法。强调在小范围真实流程中验证成本与退出机制,避免盲目追求功能数量而忽视交付质量与安全边界。
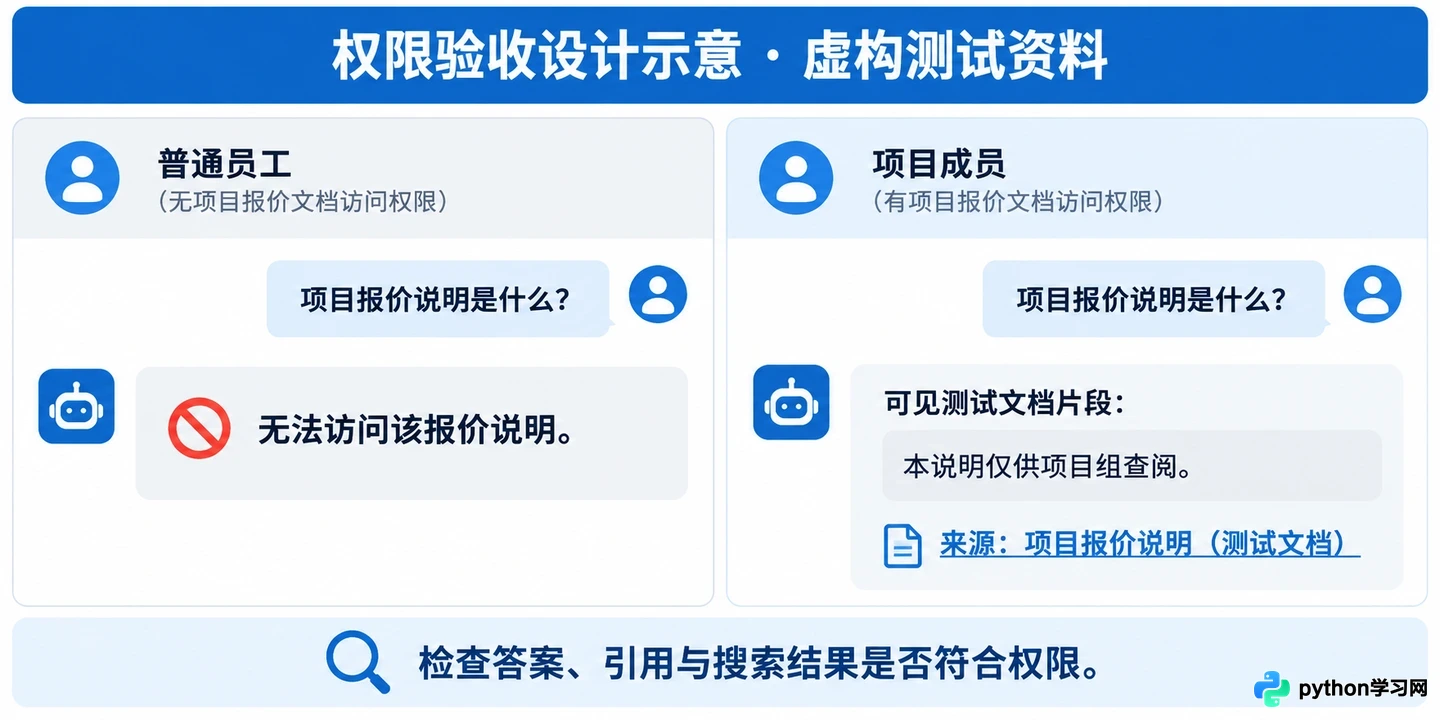
专为零基础读者梳理的Python爬虫经典教材选书指南,详细剖析5本代表性教材的核心特色、适用读者与梯度路线,附赠技术栈分层图与选书决策矩阵。
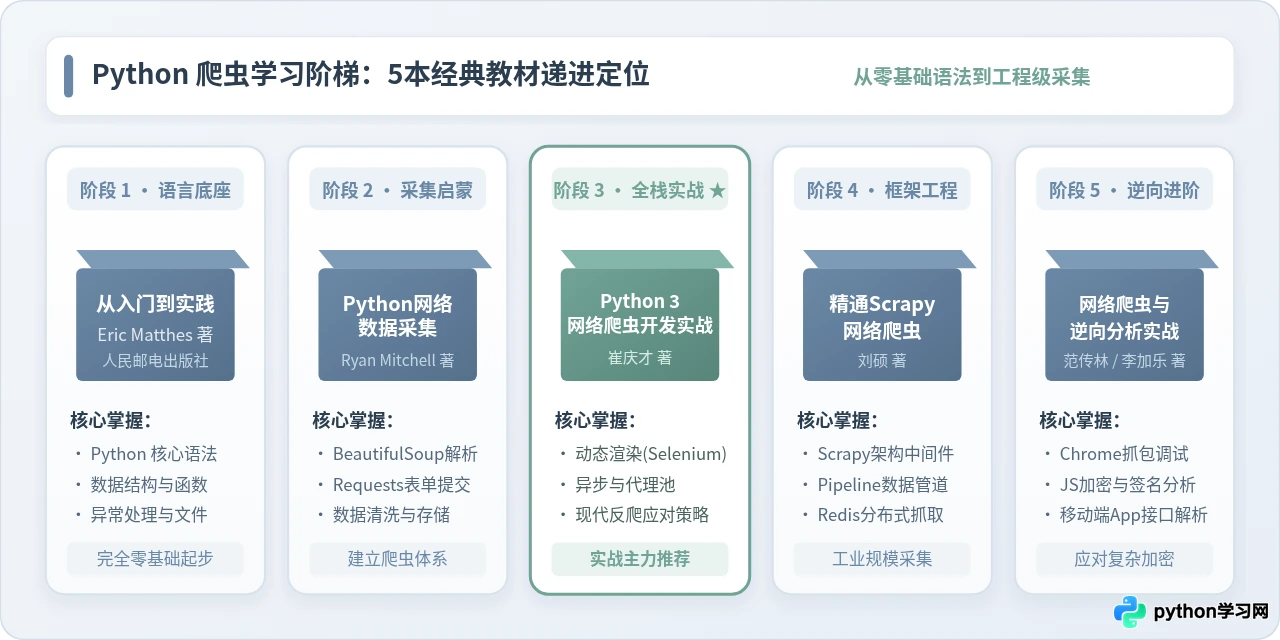
本文深入解析PyCharm中Windows系统环境变量、运行配置变量及终端设置的区别,厘清其作用范围、优先级及继承逻辑,帮助开发者正确配置开发环境。
本文介绍在无网络环境下迁移 VS Code 插件的两种方法:直接复制 extensions 文件夹与使用 VSIX 离线安装。重点讲解 Windows 系统下扩展目录的定位、复制注意事项、权限处理及兼容性检查,帮助用户在内网或离线场景中高效完成插件迁移。
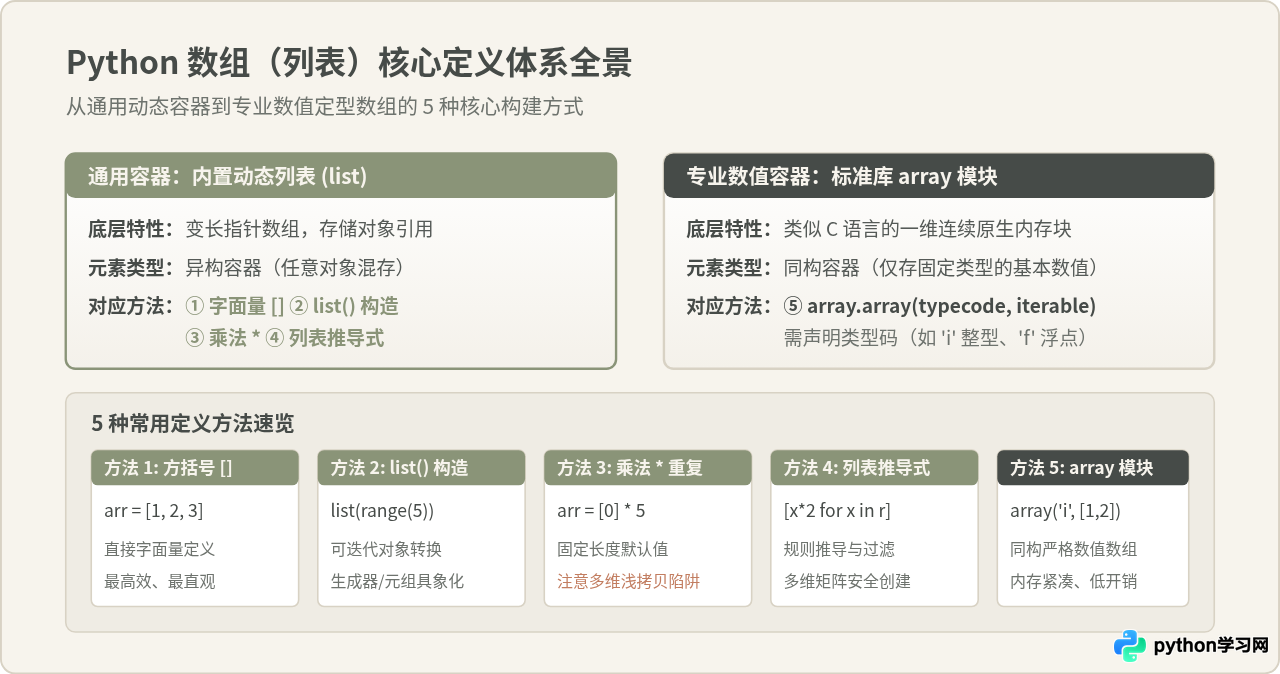
全面解析在Python中定义数组与列表的5种常用方法:方括号字面量、list()构造函数、乘法运算符重复、列表推导式以及标准库array模块。深入分析一维与多维初始化原理及内存引用机制,助你写出高效、无Bug的代码。
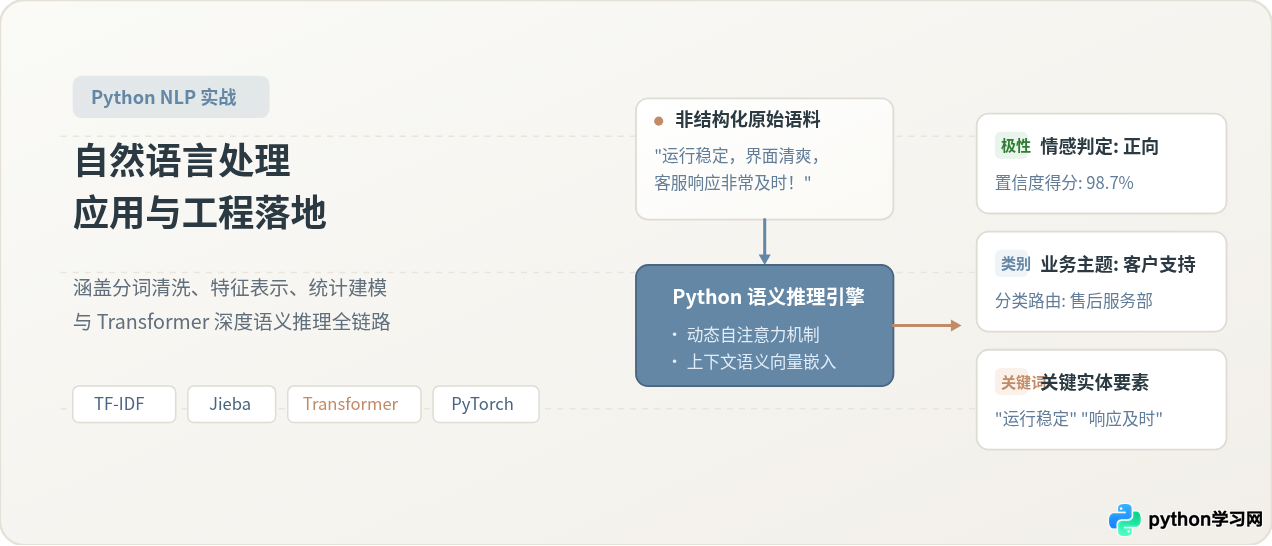
本文以具体可落地的工程实践为核心,深入讲解Python人工智能在自然语言处理(NLP)中的应用实例。涵盖文本清洗分词、TF-IDF统计建模与现代Transformer预训练深度语义推理,提供完整代码与避坑指南。
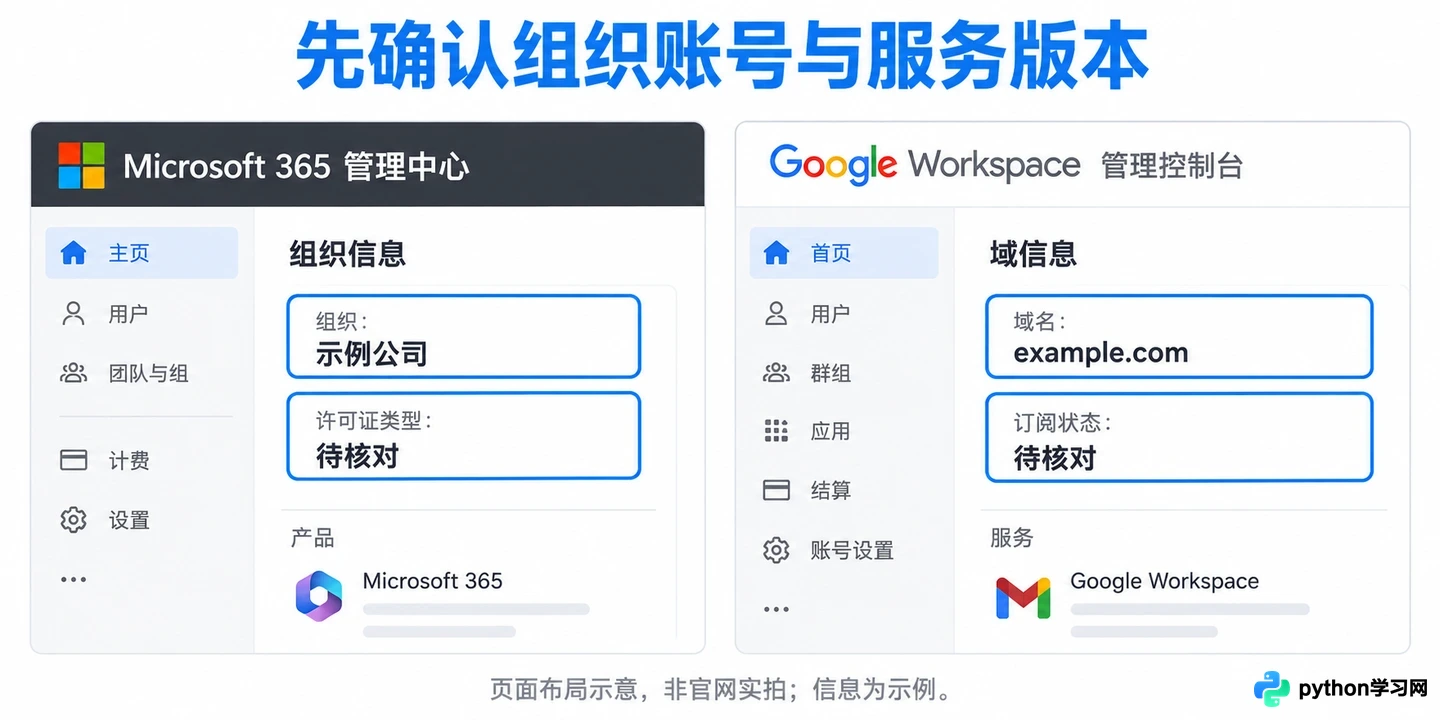
本文以虚构的“春季活动项目会议纪要”为例,演示如何在Microsoft 365 Copilot和Google Workspace中安全使用生成式AI。通过确认账号服务范围、最小化输入数据、核对训练与留存策略、检查访问权限边界以及建立验收记录五个步骤,帮助企业厘清AI办公平台的数据隐私风险与合规操作要点。
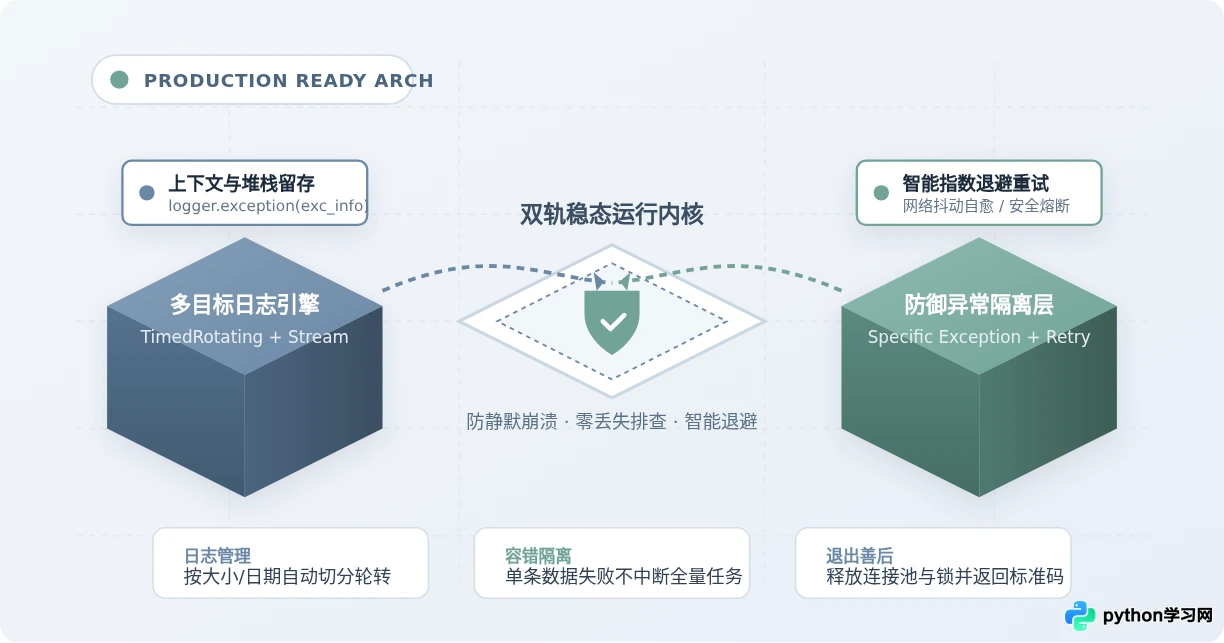
深入讲解如何通过结构化日志记录、分层异常捕获、指数退避重试以及资源安全回收,全面提升无人值守Python自动化脚本的运行稳定性与故障排查效率。