C 语言自定义数据类型梳理:枚举、结构体、共用体与 typedef
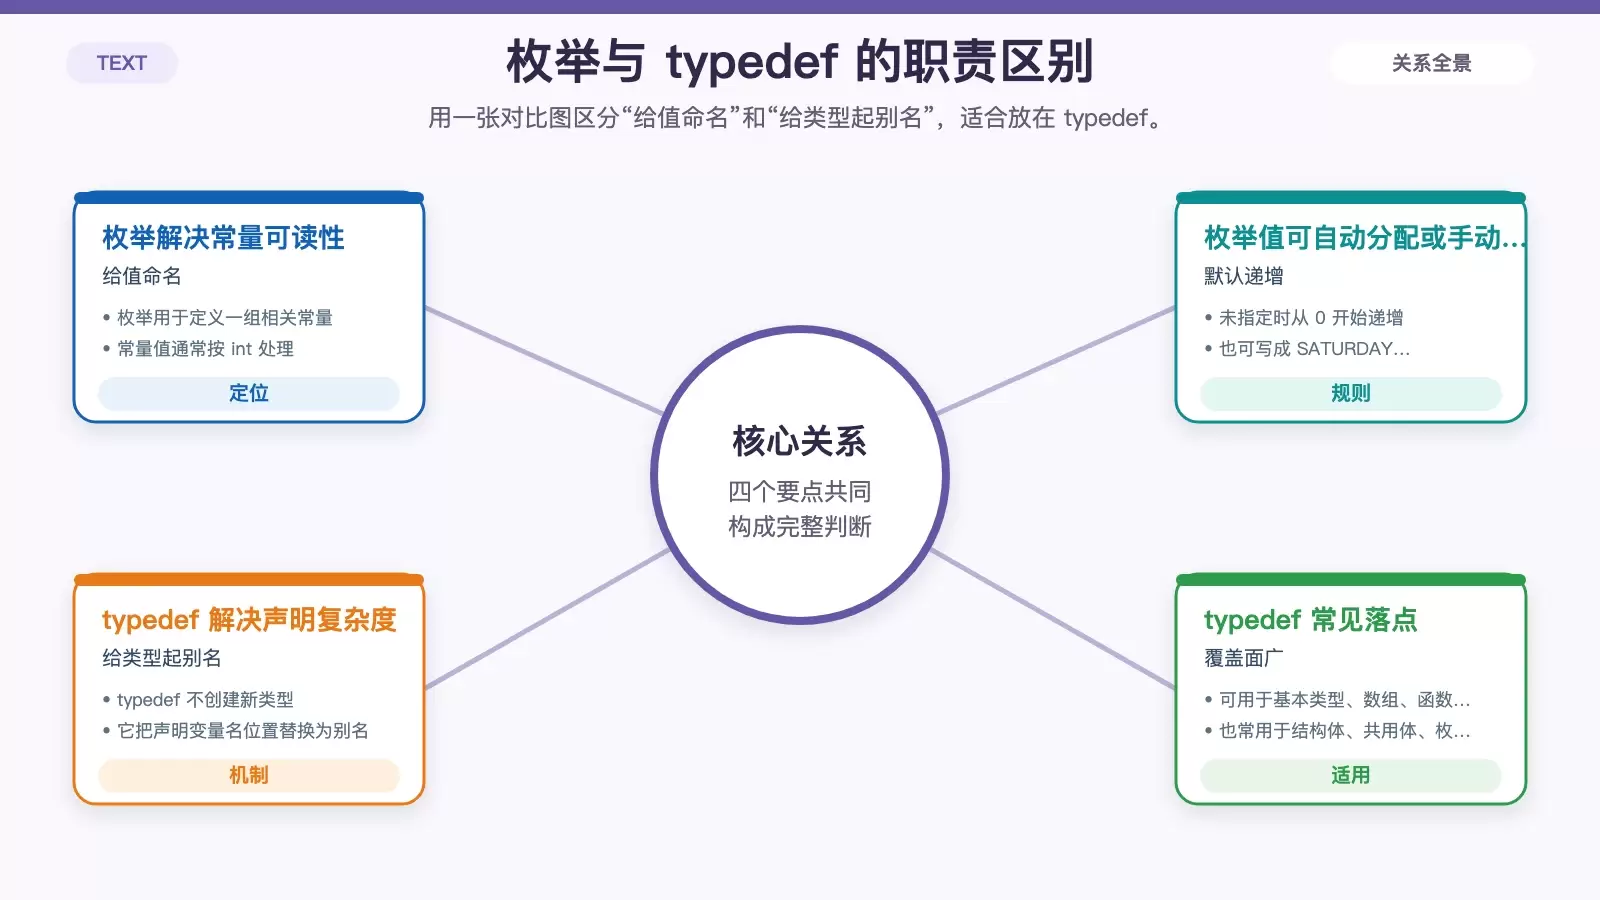
本文系统梳理 C 语言四类常见自定义数据类型:枚举、结构体、共用体和 typedef。重点不只在语法,还补清了默认取值、成员访问、内存对齐、共享存储和别名使用场景,适合用来建立判断:什么时候该提高可读性,什么时候该关注内存布局。
2026-08-24
158

本文系统梳理 C 语言四类常见自定义数据类型:枚举、结构体、共用体和 typedef。重点不只在语法,还补清了默认取值、成员访问、内存对齐、共享存储和别名使用场景,适合用来建立判断:什么时候该提高可读性,什么时候该关注内存布局。
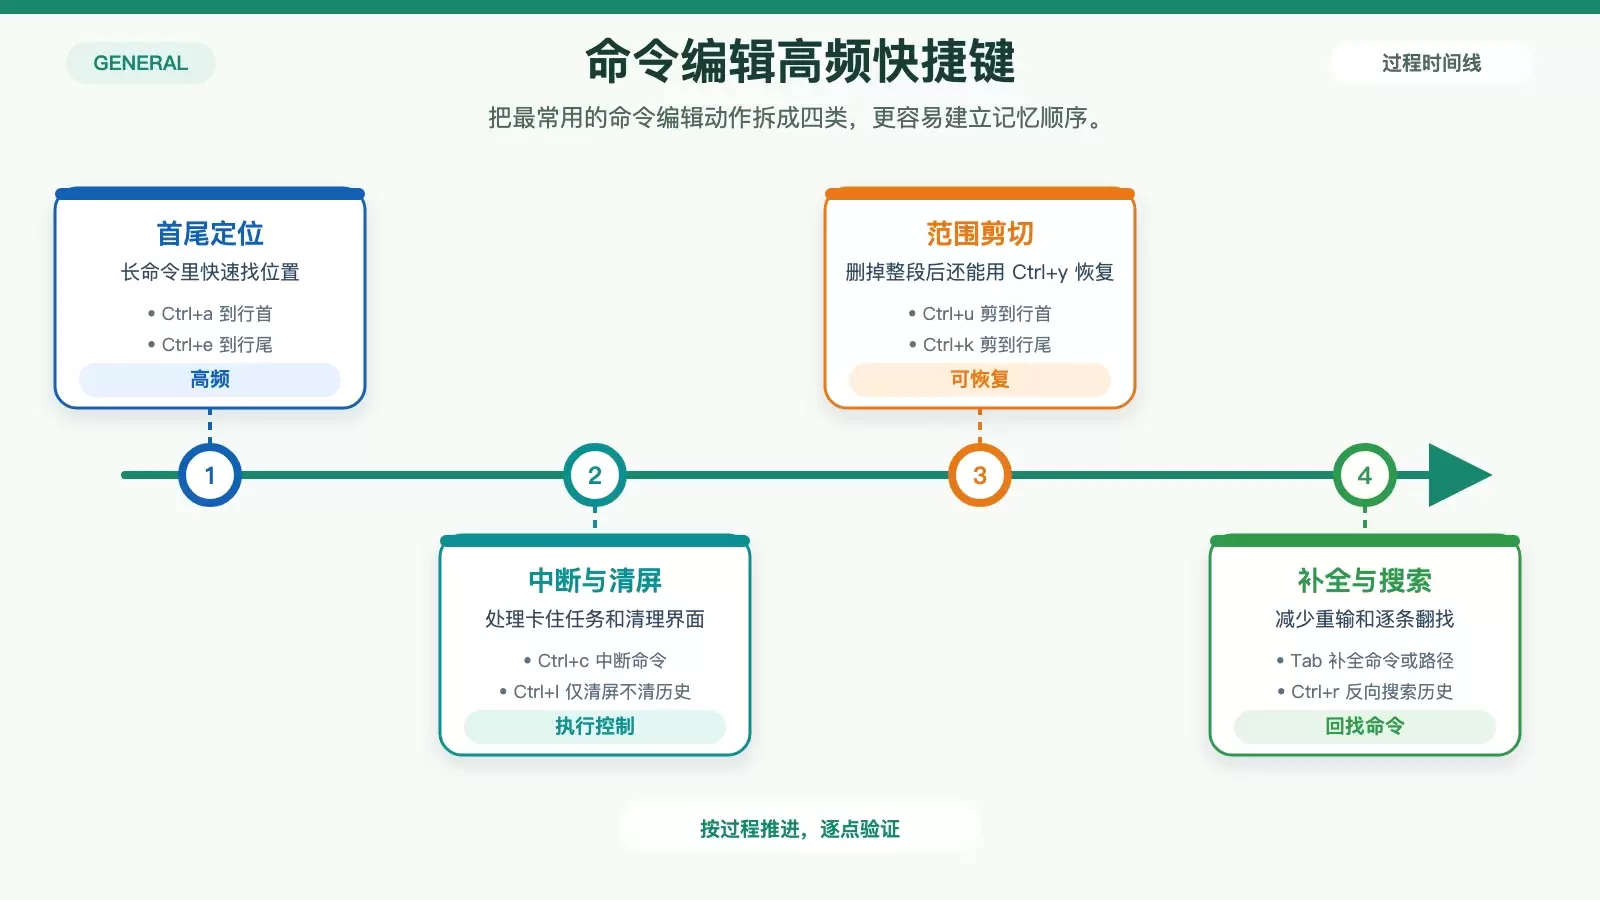
这篇文章按实际使用场景整理 SecureCRT 常见快捷键,覆盖光标移动、命令编辑、历史检索、复制粘贴以及标签页管理。保留原有按键和功能对应关系,并补出适用场景与注意点,方便你快速判断哪些组合最值得优先记住。
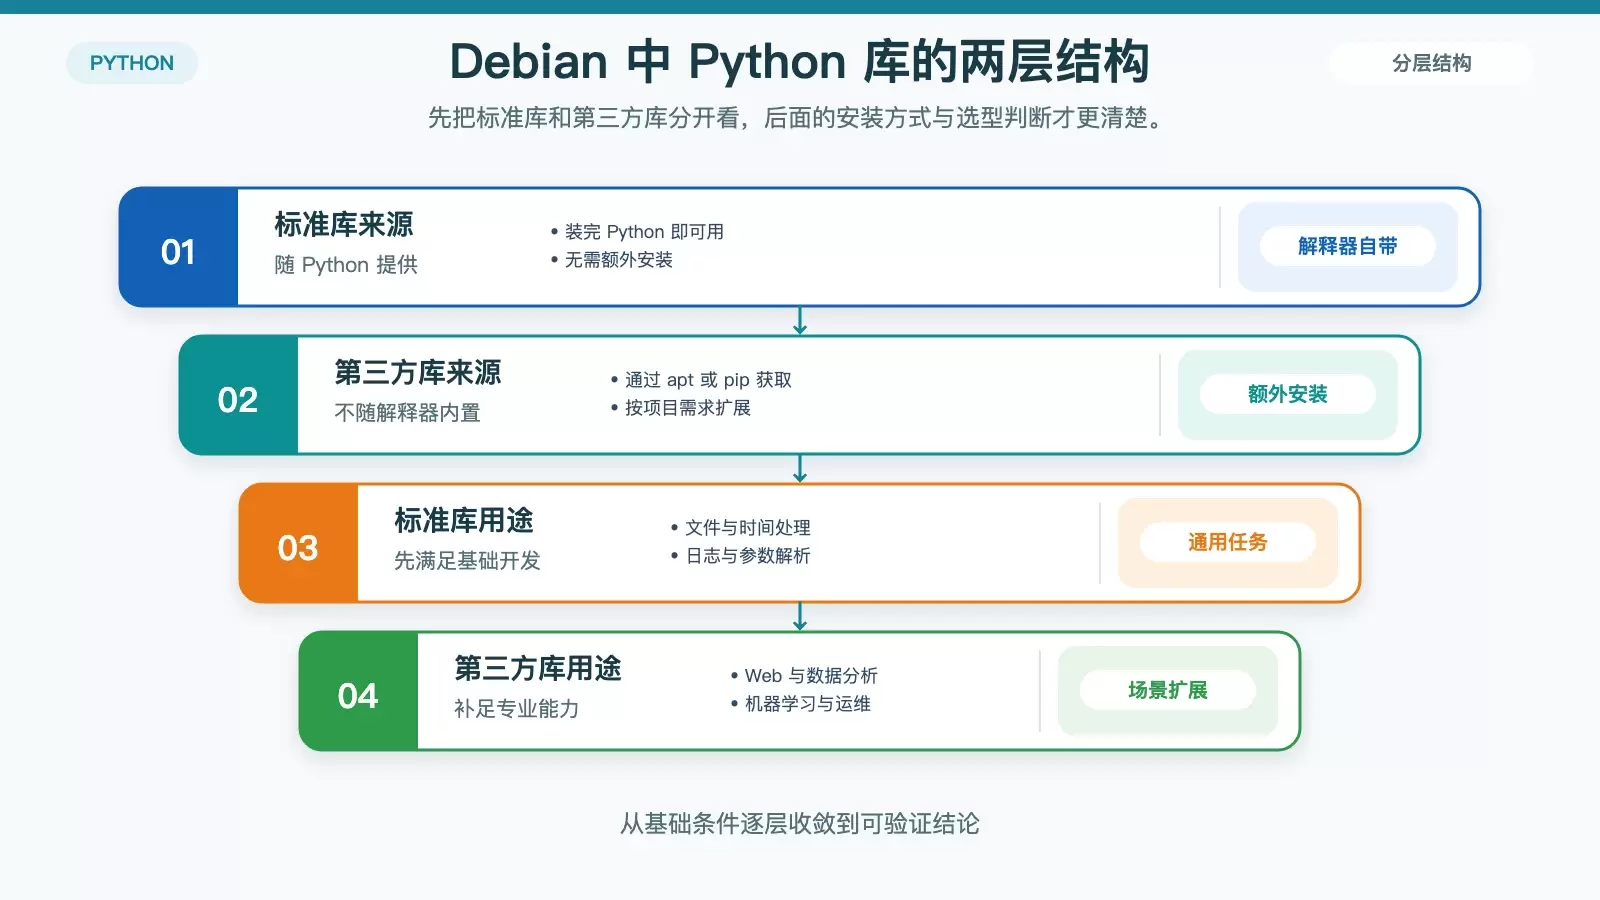
Debian 里的 Python 库大致分为两类:安装 Python 后即可使用的标准库,以及通过 apt 或 pip 额外安装的第三方库。理解两者的边界、适用场景和安装方式,能帮助你在开发、运维和数据处理时更稳妥地选库与管理环境。
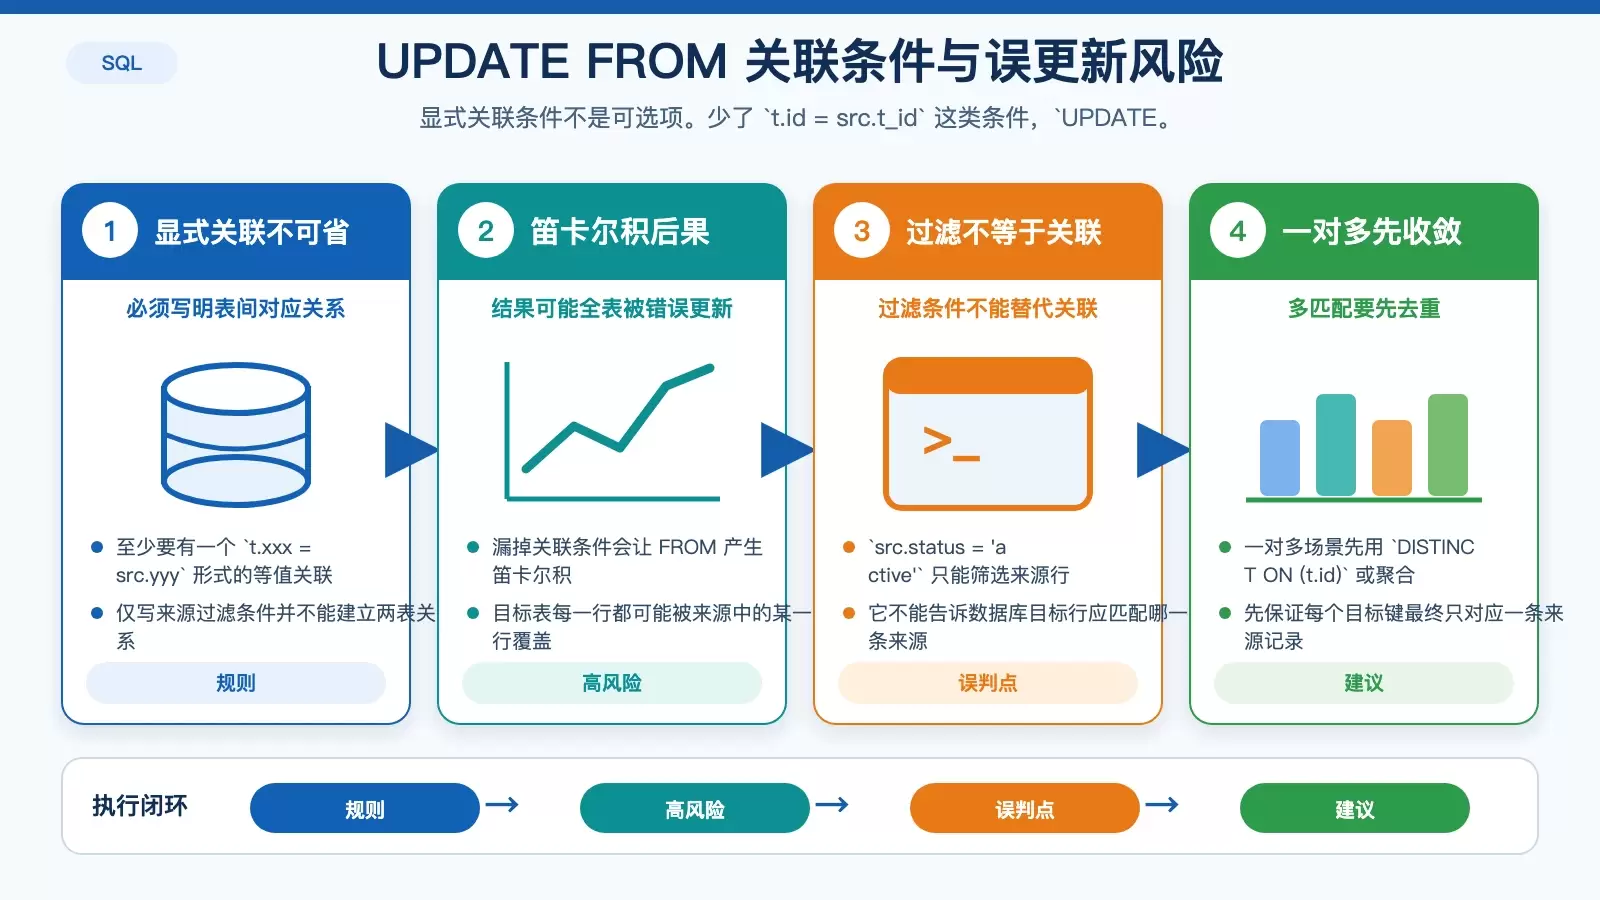
PostgreSQL 16 里的 `UPDATE ... FROM` 很好用,但几个细节处理错了,结果往往不是报错,而是“看起来执行成功,实际改错数据”。这篇文章把目标表声明规则、显式关联条件、子查询别名和更新前验证方法拆开说明,帮助你在写更新语句前先判断风险。
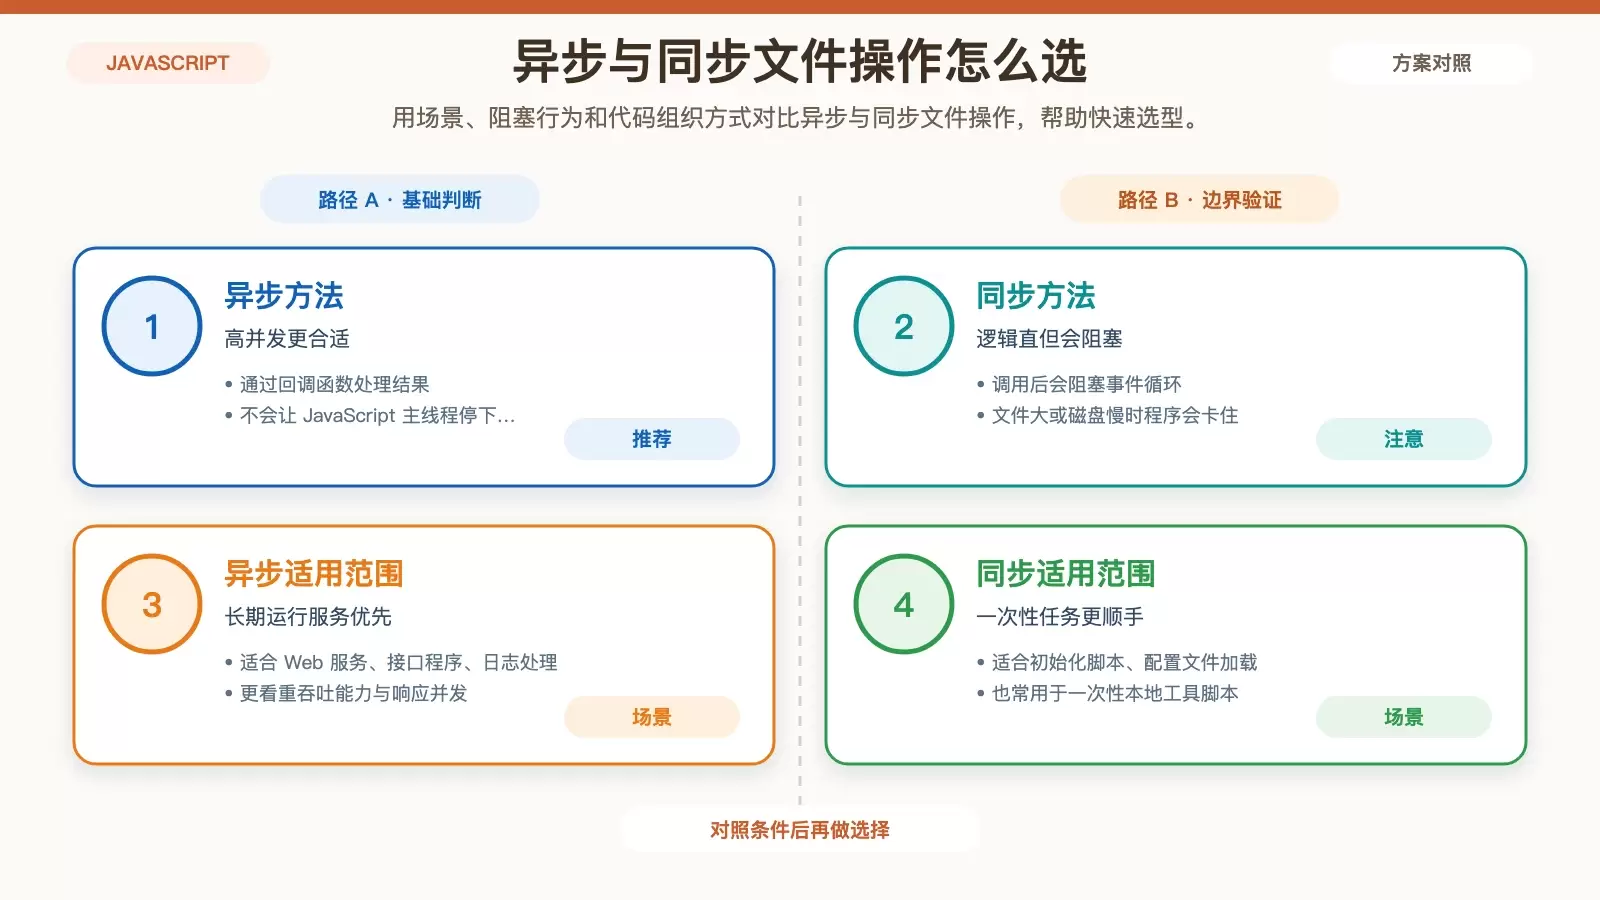
这篇文章围绕 Node.js 在 Linux 上最常见的文件操作展开,重点梳理内置 `fs` 模块的异步与同步两套接口,以及读取、写入、追加、删除、重命名、建目录、读目录这些高频方法。文末结合一段完整示例,帮助你判断不同场景下该选哪种写法。
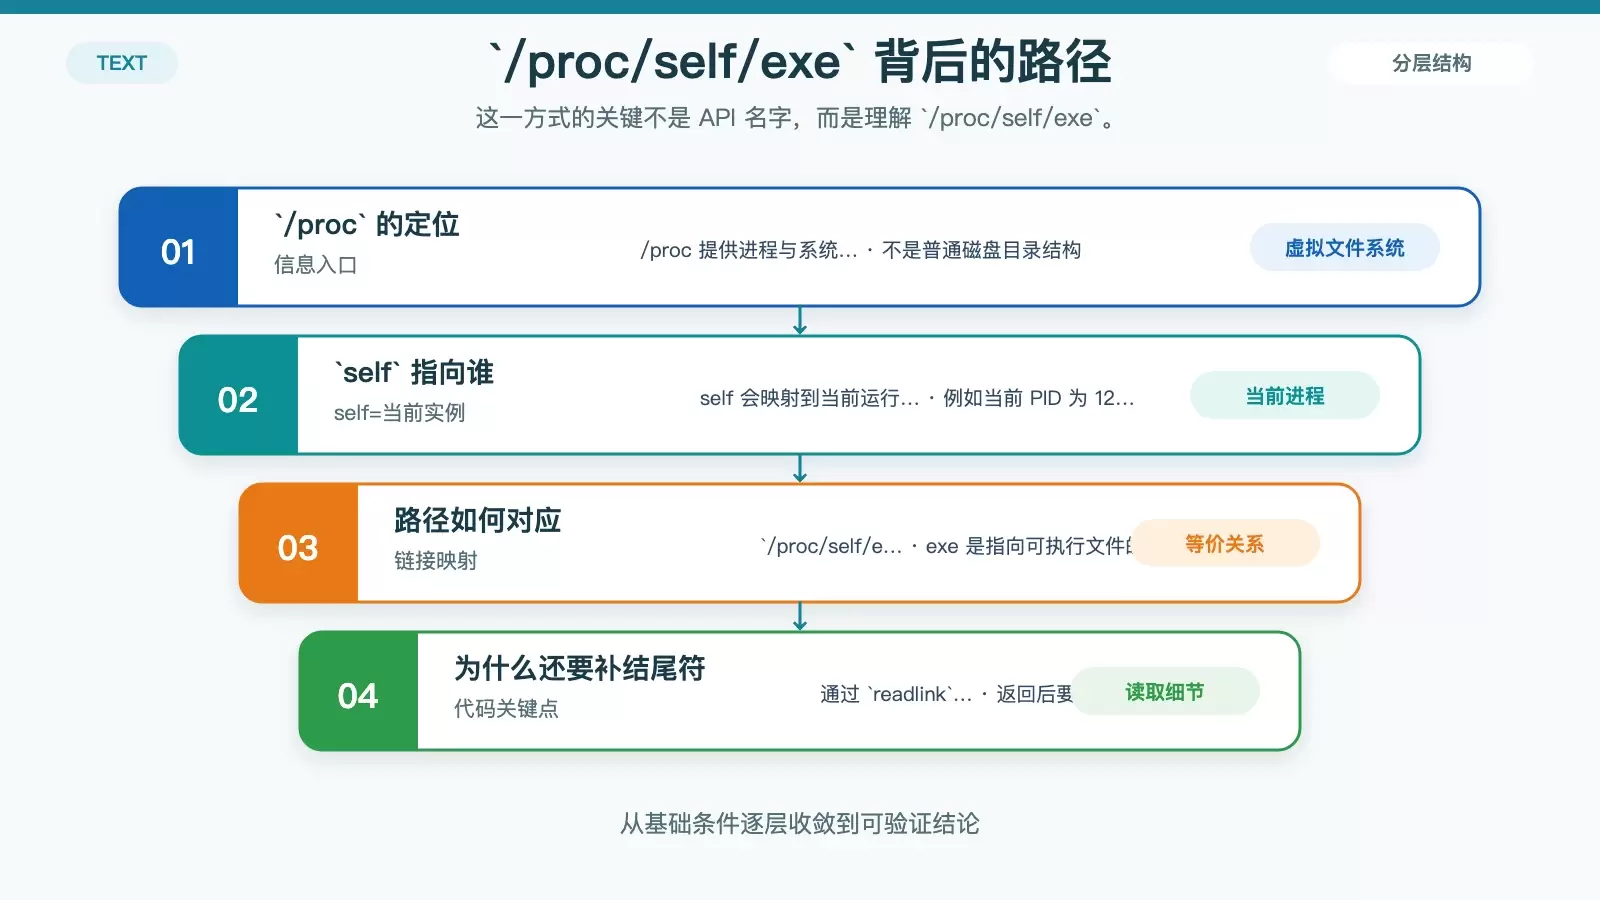
在 C 程序里获取“当前程序名”没有单一标准答案,不同平台和目标适合的方法并不一样。本文把 `__progname`、`argv[0]`、`/proc/self/exe` 和 Windows 的 `GetModuleFileName` 分开讲清楚,并补上各自能拿到的是“名称”还是“完整路径”,方便你按平台快速选型。
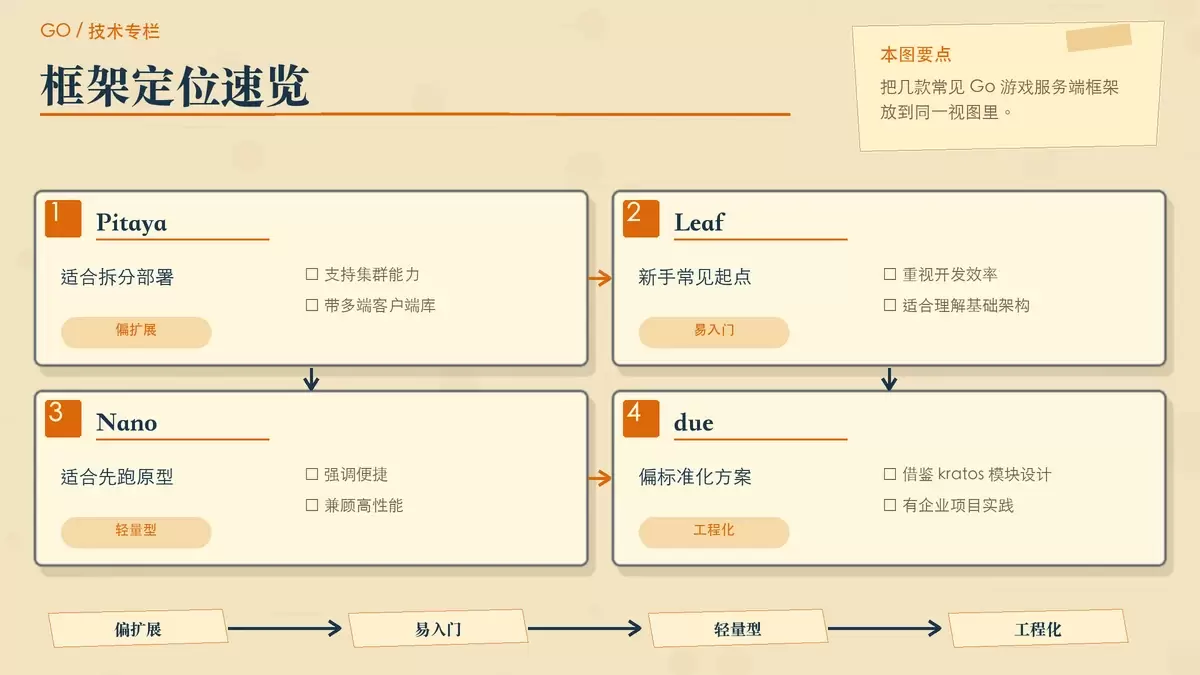
Golang 游戏服务端很难套用一个“大而全”的通用框架,选型通常取决于项目规模、分布式需求和团队经验。本文基于原文提到的活跃项目,梳理几款常见 Go 游戏服务端框架的定位、适用场景与入门建议,帮助你先缩小选择范围。
在 Go 里判断 goroutine 是否已经结束,本质上是在解决同步、通知和取消传播三类问题。本文把 `sync.WaitGroup`、Channel、`context.Context`、关闭通道广播以及 `errgroup` 放到同一条决策线上,帮助你按任务数量、是否需要取消、是否要收集错误来选方案。
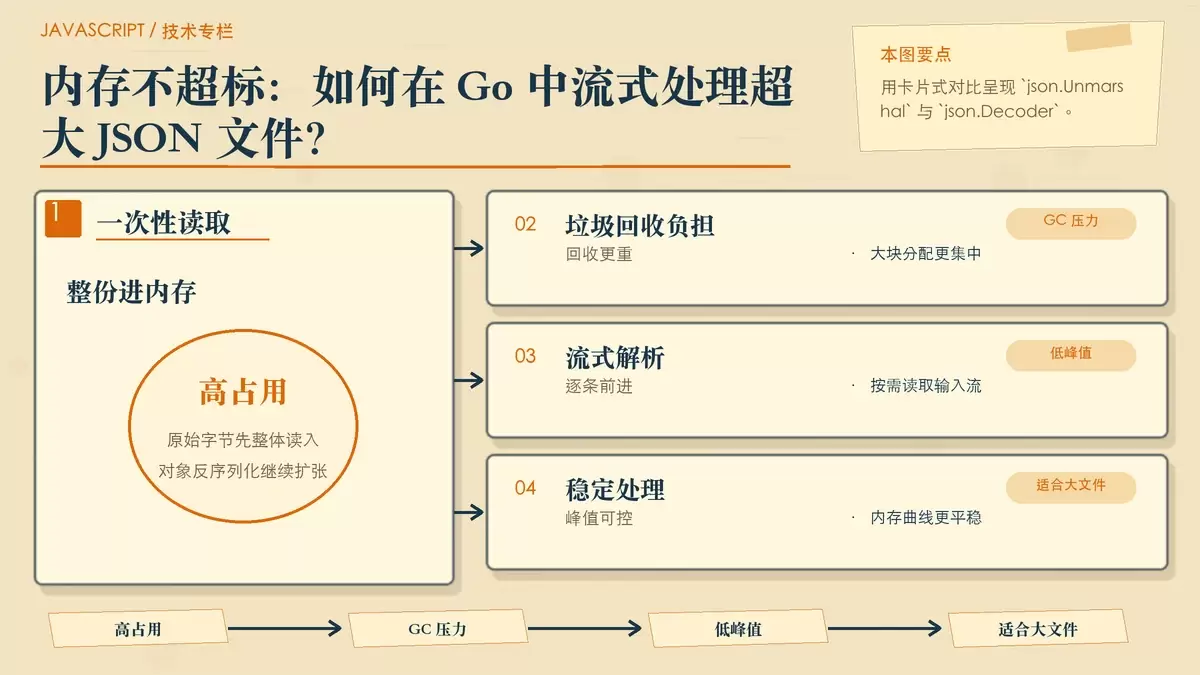
处理 GB 级 JSON 时,`json.Unmarshal` 往往会把整份数据一次性拉进内存,容易触发高占用甚至 OOM。本文围绕 Go 标准库 `json.Decoder` 的流式解析方式,说明它为什么更适合大文件,并给出解析超大 JSON 数组的关键写法、适用场景与落地注意点。
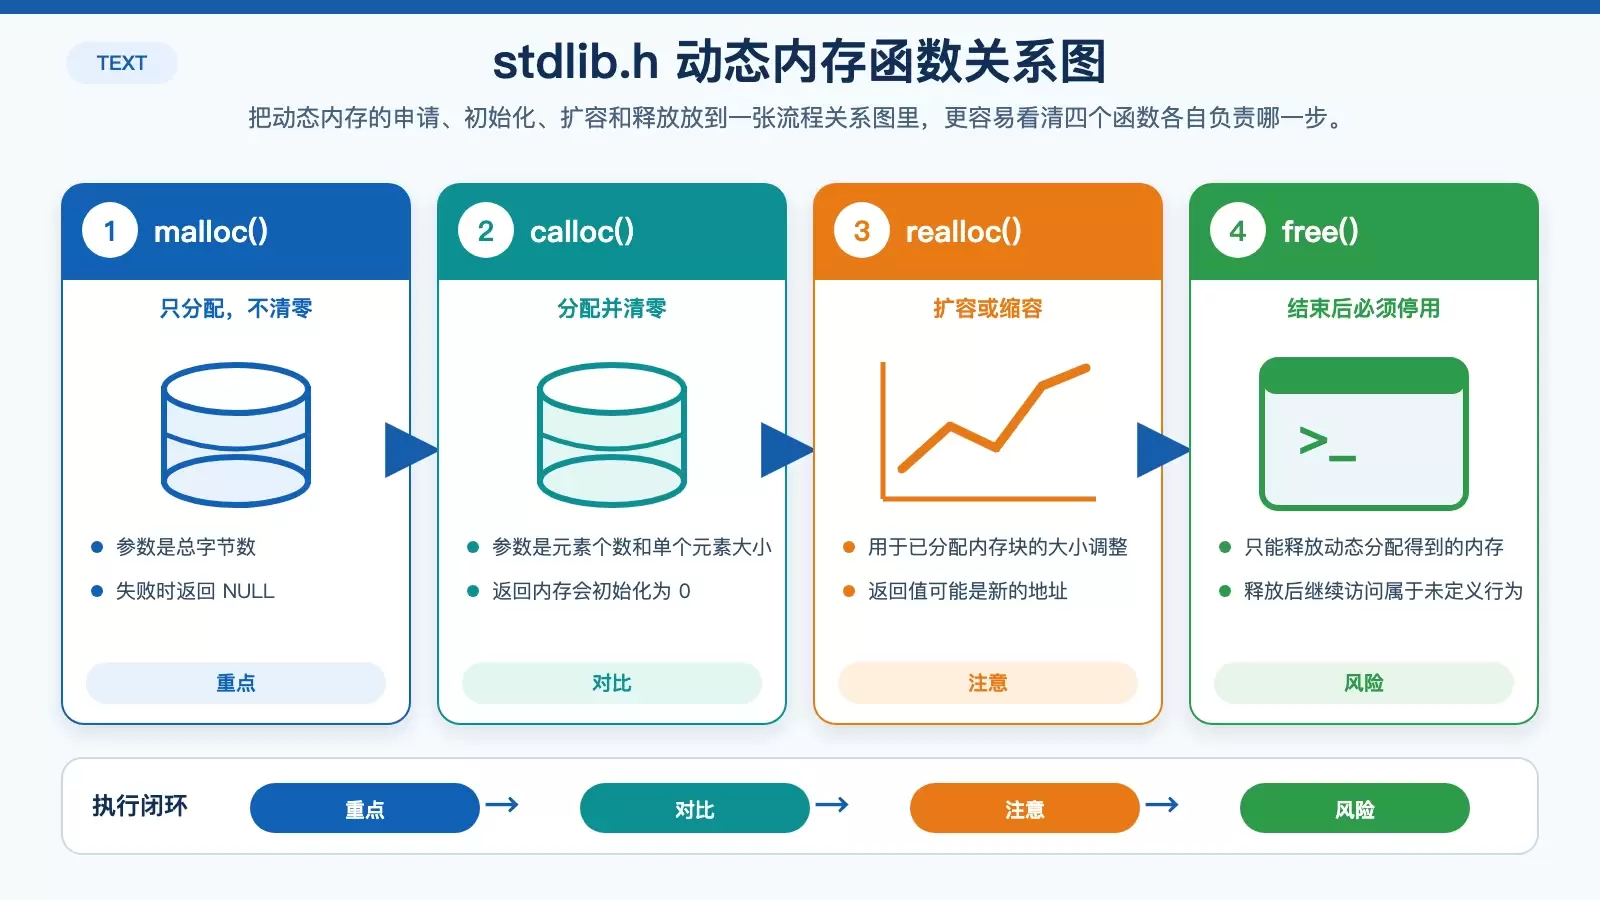
stdlib.h 是 C 语言里最常用的标准库头文件之一,覆盖动态内存、随机数、字符串转数值和程序控制等基础能力。本文按使用场景梳理常见函数,保留示例代码,并补上各函数适用边界与使用时的判断要点。
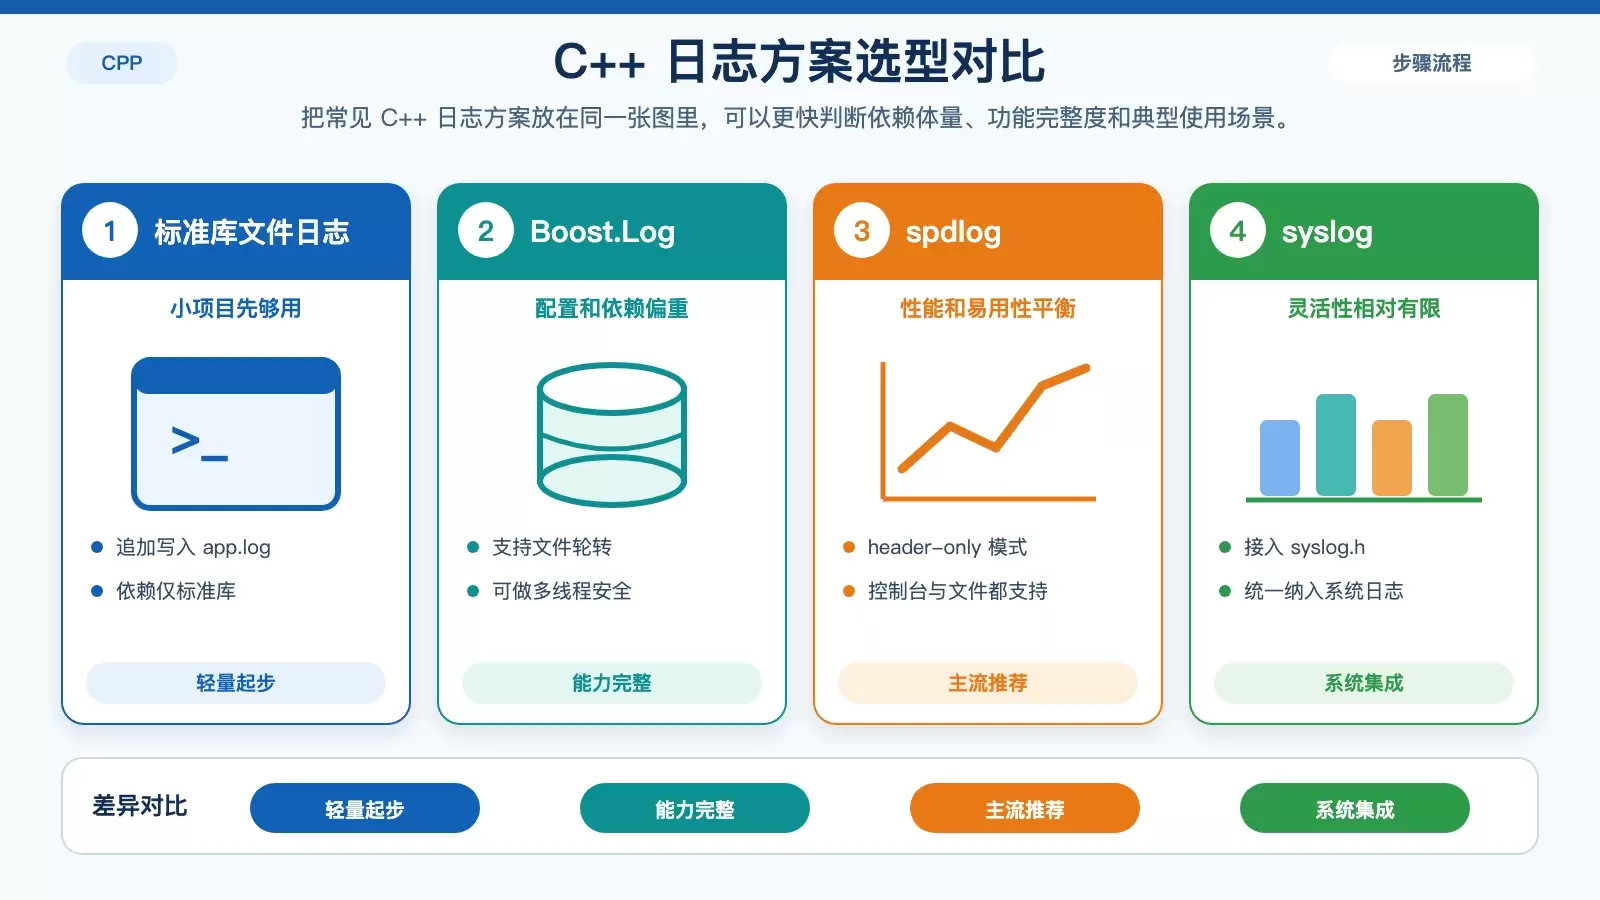
在 Linux 上给 C++ 程序加日志,常见方案主要分成三类:自己用标准库写文件、接入第三方日志库,或直接走系统的 syslog。它们在依赖体量、功能完整度、性能和运维方式上差别很大,选型时要先看项目规模、线程模型和后续排障需求。
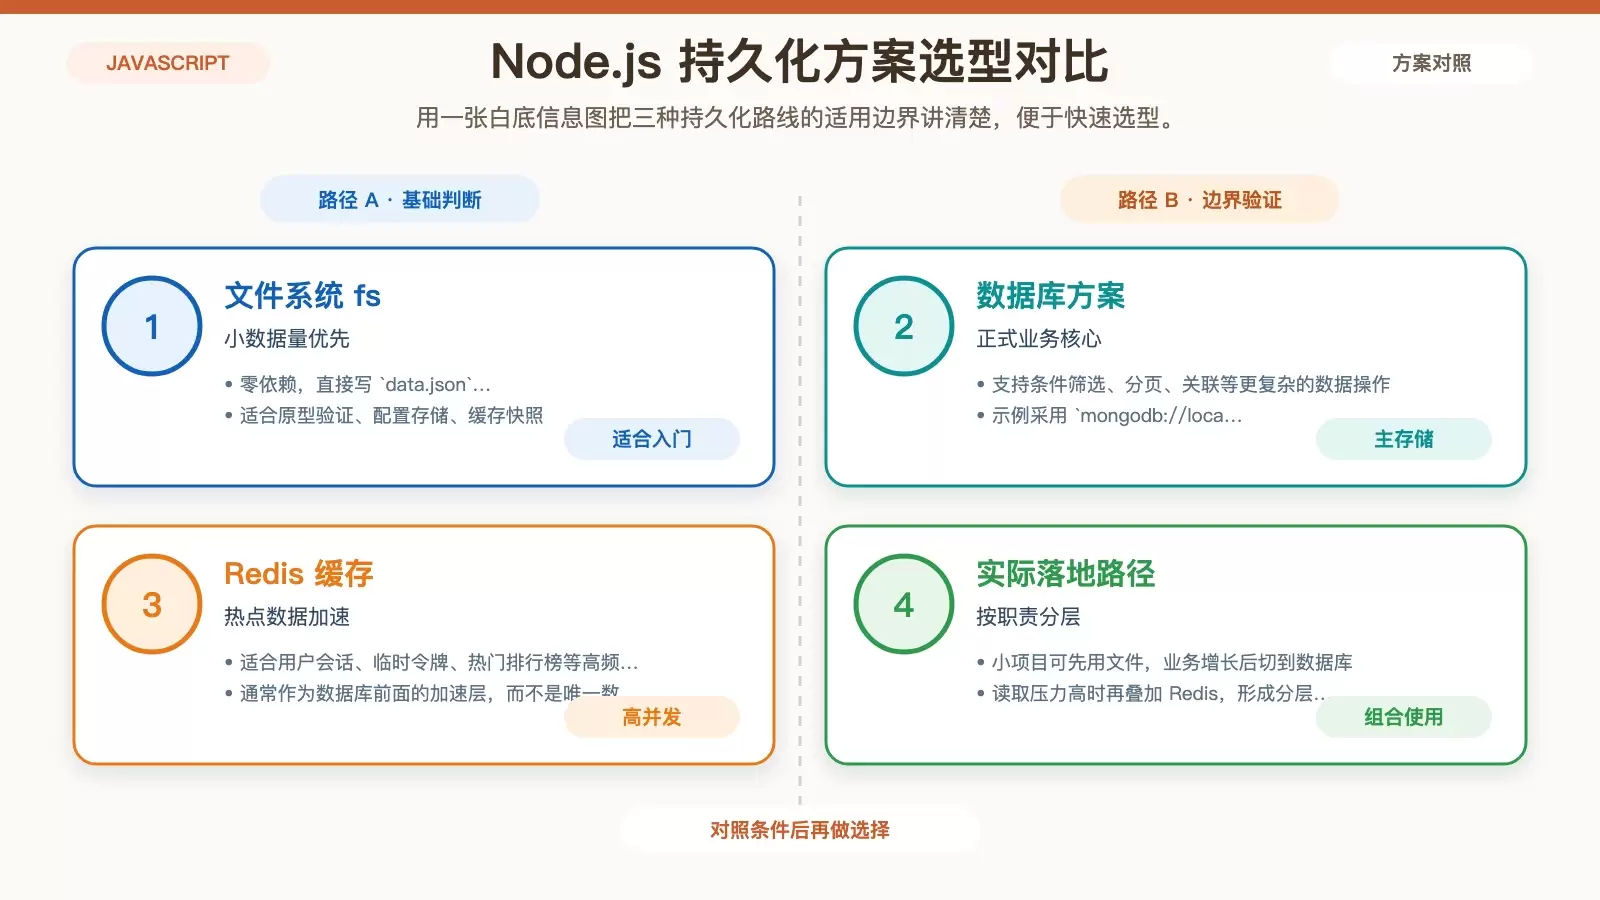
在 Ubuntu 上做 Node.js 数据持久化,常见路线无非是文件、数据库和缓存三类。它们的差别不在“能不能存”,而在数据规模、并发压力、查询能力和维护成本。本文结合 `fs`、MongoDB + Mongoose 与 Redis 示例,帮你快速判断该怎么选。