


在 Ubuntu 部署 Node.js 服务时,数据到底该落到文件、本地数据库,还是直接接入 Redis,往往不是“技术能不能做”的问题,而是后续能不能扛住数据量、并发和维护成本。本文把三种常见持久化方案拆开说清楚:各自适合什么场景、代码怎么写、短板在哪里,以及你该依据哪些业务指标做选择。
为什么要先选对持久化方式
Node.js 本身并不负责长期保存业务数据,真正决定系统稳定性的,往往是你把数据放在哪里。对 Ubuntu 上的应用来说,常见选择可以分成三类:
- 直接写本地文件,适合轻量、低并发场景;
- 使用数据库,适合正式业务和复杂查询;
- 引入 Redis 缓存,适合高频读取和高并发访问。
它们并不是互斥关系。很多线上项目的实际组合是“数据库负责主存储,Redis 负责热点加速”,而文件系统更多承担配置、快照或原型阶段的数据落盘任务。
小数据量场景:直接用文件系统
如果你的应用只是临时存一点 JSON 数据,或者需要做原型验证、配置存储、缓存快照,Node.js 自带的 fs 模块就是最省事的办法。它零依赖、上手快,不需要额外部署服务。
基本写法:把 JSON 直接写入本地文件
const fs = require('fs');

// 写入数据到文件
fs.writeFile('data.json', JSON.stringify({ key: 'value' }), (err) => {
  if (err) throw err;
  console.log('数据已保存');
});

// 从文件读取数据
fs.readFile('data.json', 'utf8', (err, data) => {
  if (err) throw err;
  console.log('读取到的数据:', data);
});
什么时候适合用 fs
- 项目还在原型阶段,先验证功能;
- 数据量很小,结构也简单;
- 不需要复杂筛选、排序、关联查询;
- 读写频率不高,通常只有单进程访问。
它的限制也很明确
文件系统最大的问题不是“不能存”,而是扩展性有限。数据量变大后,读写效率会下降;并发上来后,多进程同时写入还可能产生冲突。换句话说,fs 更像轻量级落盘工具,而不是完整的数据层方案。
正式业务场景:数据库才是主力
当你的应用开始涉及持续增长的数据量、条件筛选、分页、统计,甚至关联查询时,数据库基本就是必选项。Node.js 社区对 MySQL、PostgreSQL、MongoDB、SQLite 等都有成熟支持,这里先用 MongoDB + Mongoose 作为示例。
先安装 Mongoose
npm install mongoose连接数据库并执行基础读写
const mongoose = require('mongoose');

// 连接到MongoDB数据库
mongoose.connect('mongodb://localhost:27017/myDatabase', {
  useNewUrlParser: true,
  useUnifiedTopology: true,
});

// 定义一个数据模型
const Data = mongoose.model('Data', { key: String });

// 写入数据
const data = new Data({ key: 'value' });
data.sa ve((err) => {
  if (err) throw err;
  console.log('数据已保存');
});

// 读取数据
Data.findOne({ key: 'value' }, (err, data) => {
  if (err) throw err;
  console.log('读取到的数据:', data);
});
为什么很多 Node.js 项目会选 Mongoose
Mongoose 不只是一个连接驱动,它还补上了不少工程化能力,比如 Schema 校验、中间件和更清晰的数据模型定义。这样做的直接收益是:数据结构更容易维护,代码约束更明确,也更适合多人协作开发。
如果你更强调底层控制,也可以直接使用官方 mongodb 驱动。代价是代码会更原生,样板部分也通常更多。
数据库更适合哪些需求
- 数据量会持续增长;
- 需要按条件查询、排序、分页;
- 业务逻辑开始复杂化;
- 希望数据结构具备明确约束和可维护性。
高并发读取场景:用 Redis 做缓存
并不是所有数据都适合每次都去查数据库。像用户会话、临时令牌、热门排行榜这类高频读取内容,如果每次都回数据库,性能很容易成为瓶颈。这时候 Redis 的价值就体现出来了。
Node.js 里常见的 Redis 客户端
常见选择有 redis 和 ioredis。原文提到,ioredis 性能更好且支持 Promise;如果你需要较新的异步开发体验,它通常会更顺手。
先安装 redis 库
npm install redis基础 set/get 示例
const redis = require('redis');
const client = redis.createClient();

// 连接到Redis服务器
client.on('connect', () => {
  console.log('已连接到Redis');
});

// 写入数据
client.set('key', 'value', (err) => {
  if (err) throw err;
  console.log('数据已保存');
});

// 读取数据
client.get('key', (err, data) => {
  if (err) throw err;
  console.log('读取到的数据:', data);
});
缓存真正难的不是接入,而是策略
Redis 接进来并不代表问题自动解决。缓存设计里至少要考虑两个核心点:
- 过期策略,也就是 TTL 应该怎么设;
- 缓存失效后,应用如何回源到数据库并重建缓存。
如果这两件事处理不好,就可能出现脏数据、缓存击穿或热点失衡。除了缓存,Redis 也常被拿来做消息队列、分布式锁,功能远不止键值存取。
三种方案怎么选,先看业务形态
把选择标准压缩一下,其实可以按下面的逻辑判断:
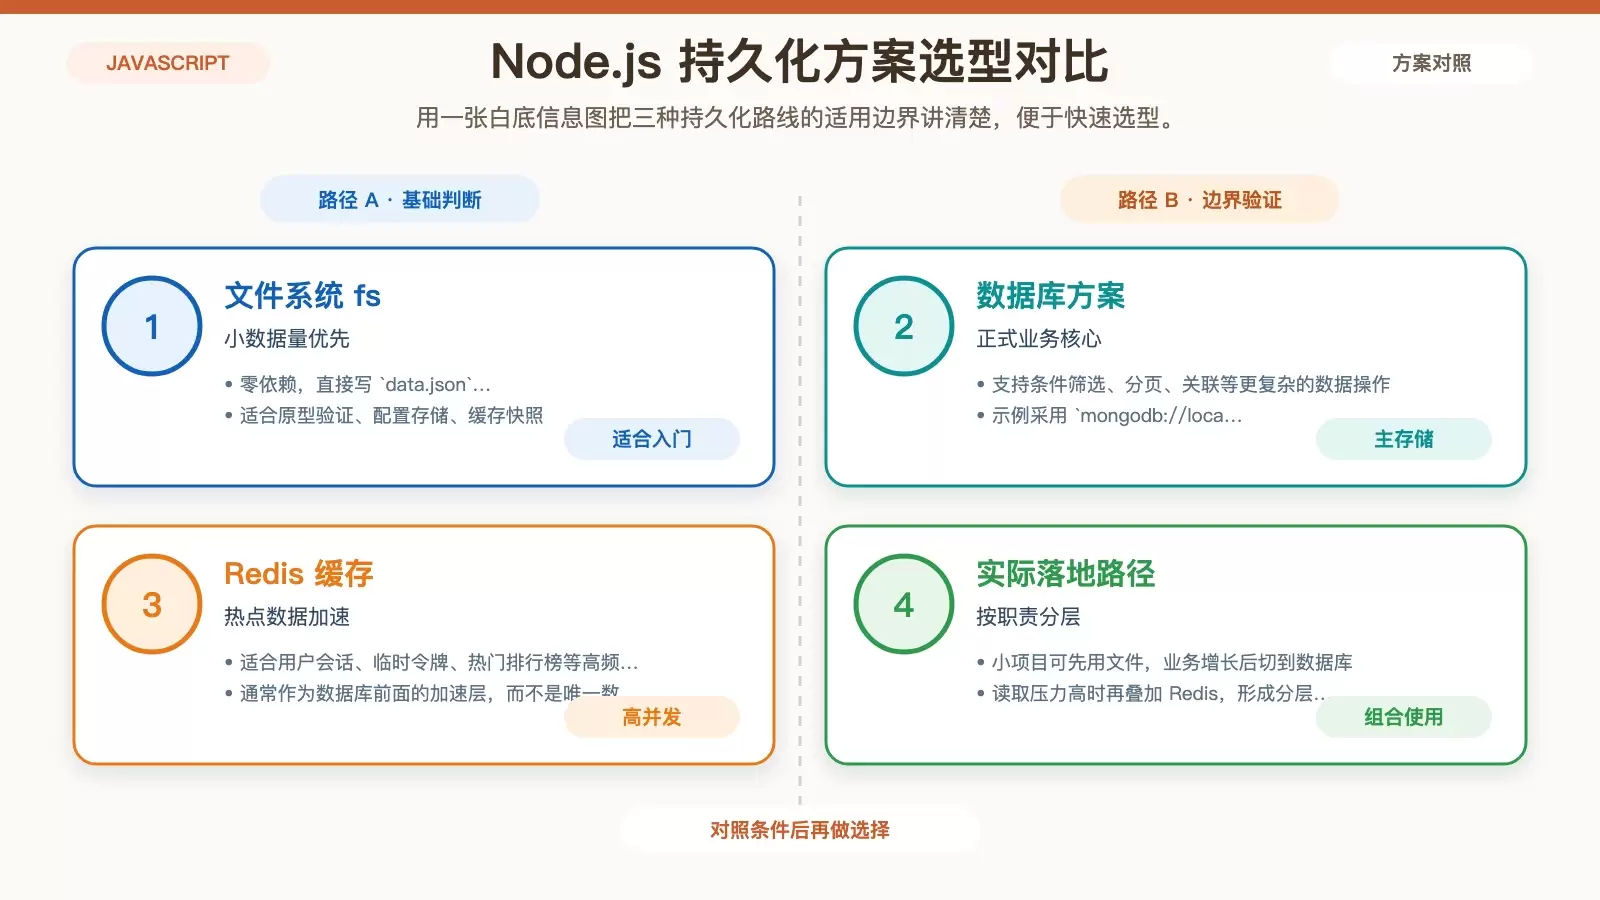
- 小项目、低并发、临时数据:优先考虑文件系统;
- 中大型项目、正式业务数据:数据库是主存储核心;
- 高频读取、高并发访问:在数据库之外叠加 Redis 缓存。
最常见、也最稳妥的架构,不是三选一,而是按职责分层:文件负责轻量落盘,数据库负责主数据,Redis 负责性能加速。
结论
在 Ubuntu 上做 Node.js 数据持久化,没有一招通吃的方案。fs 胜在简单,适合轻量场景;MongoDB + Mongoose 这类数据库方案更适合正式业务;Redis 则负责把高并发读取压力从数据库前面挡下来。真正该怎么落地,取决于你的数据规模、访问频率和业务复杂度,而不是单看某个技术是否流行。









