

Python逆向抓取APP数据实战:从抓包到代码实现
本文详细演示如何利用Python逆向分析APP数据。通过Fiddler抓包发现SSL Pinning,使用Xposed和JustTrustme绕过;利用ApkScan查壳、frida-DEXDump脱壳及jadx反编译定位加密逻辑。最终通过Frida Hook获取AES密钥,在Python中复现加解密过程,成功抓取APP接口数据。
2026-10-15
20

本文详细演示如何利用Python逆向分析APP数据。通过Fiddler抓包发现SSL Pinning,使用Xposed和JustTrustme绕过;利用ApkScan查壳、frida-DEXDump脱壳及jadx反编译定位加密逻辑。最终通过Frida Hook获取AES密钥,在Python中复现加解密过程,成功抓取APP接口数据。
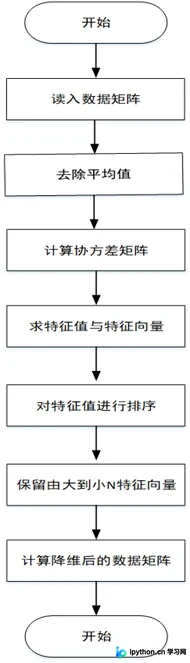
本文详细解析Python中主成分分析(PCA)降维算法的原理、计算步骤及优缺点。涵盖从数据零均值化、协方差矩阵构建到特征值分解的全过程,并提供基于NumPy和Scikit-learn的完整代码实现示例,帮助开发者掌握高维数据降维与可视化技巧。
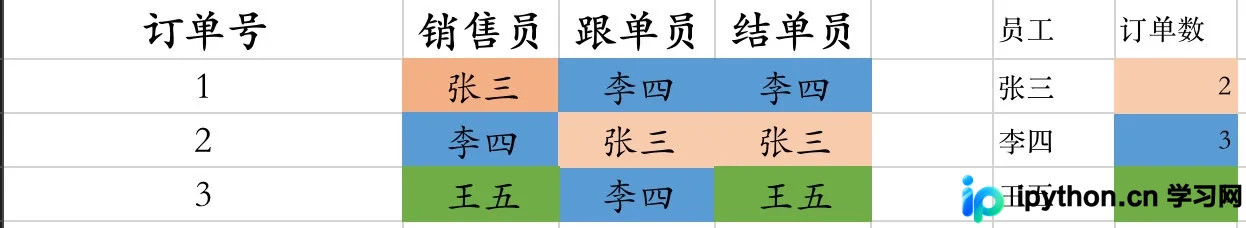
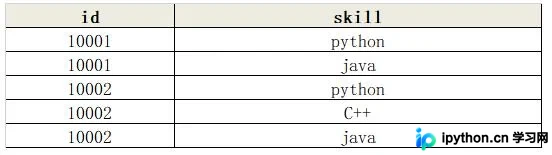
本文详解如何在Pandas中实现Hive的explode函数功能,用于处理员工销售记录统计。通过展开订单角色列表并去重,准确计算每位员工参与的不同订单数量,适用于复杂业务场景下的数据清洗与分析。
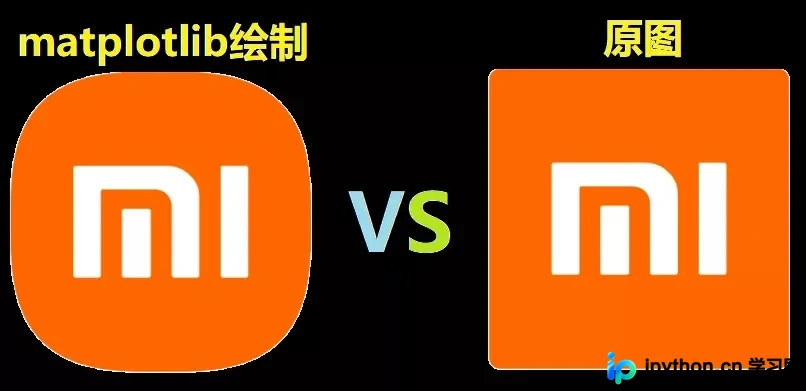
本文详细解析小米新Logo背后的数学原理,重点介绍如何利用Python的Matplotlib库绘制超椭圆,并结合PIL库处理像素数据,实现旧Logo“米”字图案与新背景的融合。文章提供完整代码逻辑与关键函数说明,帮助开发者复现这一设计效果。
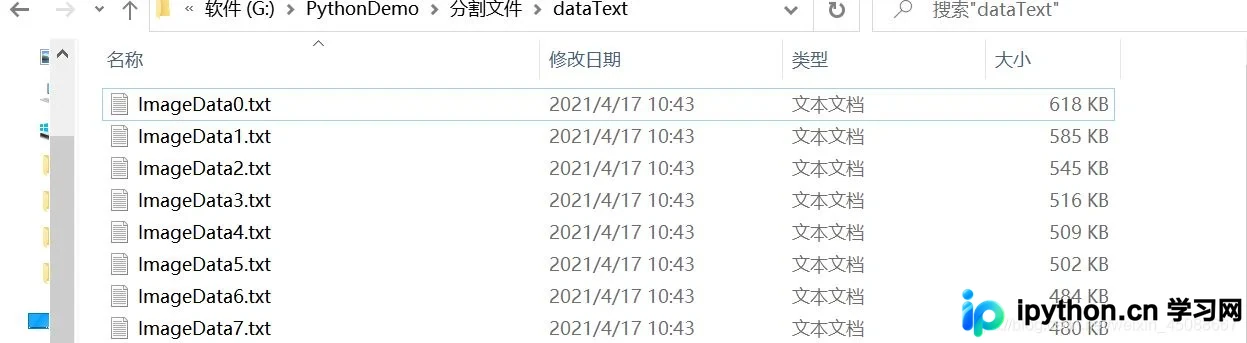
本文介绍如何使用Python将单个大型文本文件按固定行数拆分为多个小文件。通过读取源文件内容,设定每批处理的行数(如5000行),利用列表切片进行分批处理,并将结果写入指定的目录中。该方法适用于解决因文件过大导致软件导入失败的问题,例如批量处理URL列表供下载工具使用。
本文详细介绍在Pandas中创建Category类型数据的两种主要方法。首先讲解如何直接指定预设类别创建分类数据,其次演示如何利用分箱机制(结合max、mean、min)动态生成Category类型。通过具体代码示例,展示如何处理空值、NaN及多字段数据分类,帮助开发者高效进行数据预处理与分类管理。
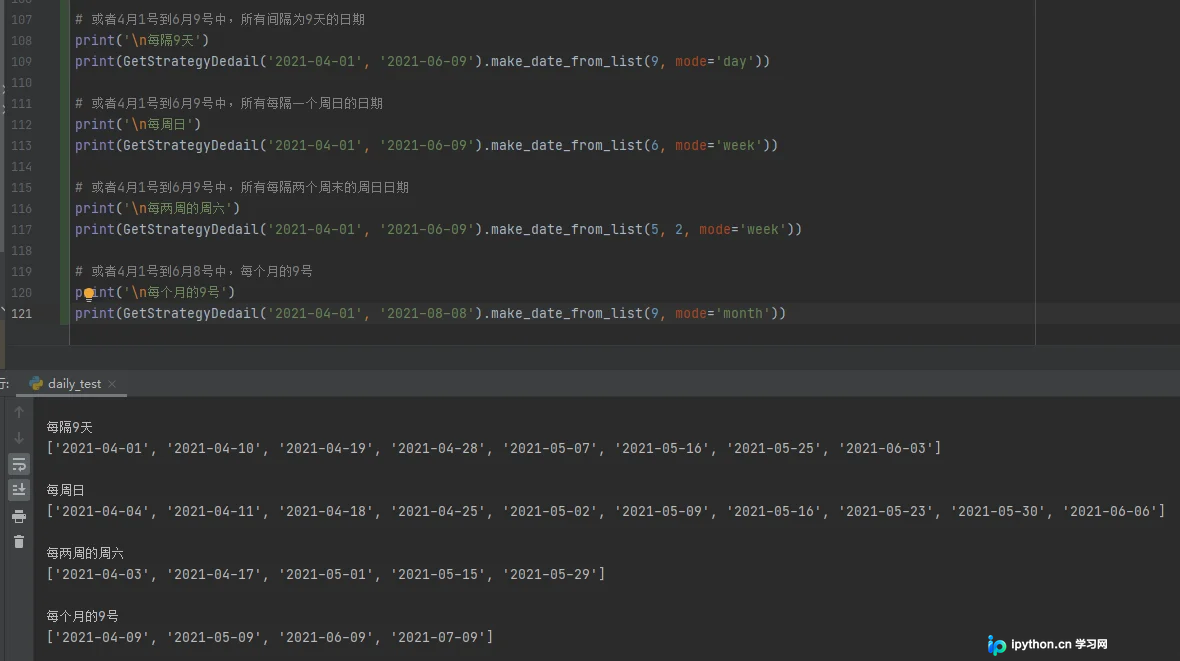
本文介绍在Python中如何生成指定时间段内符合特定规律的日期列表。通过封装GetStrategyDedail类,实现了固定天数间隔、按周几循环以及按月循环三种策略。文章提供了核心代码逻辑与make_date_from_list方法的使用示例,适用于需要自定义回归时间或周期性执行任务的场景。
本文介绍在pandas中如何利用groupby对数据进行分组,并将其他列的值合并为列表或字典。通过apply结合list或lambda表达式,可实现单列或多列的聚合处理。同时补充字符串字段的拼接方法及常见字符串处理函数,帮助高效完成数据清洗与转换任务。
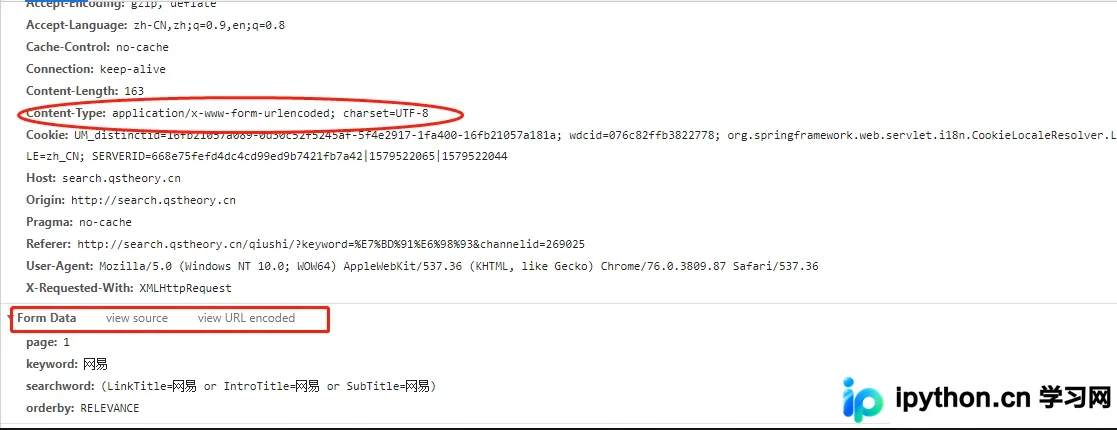
本文深入解析Python requests库中Post请求的两种主要参数形式:Form Data与Request Payload。通过Chrome开发者工具示例,详细对比了application/x-www-form-urlencoded与application/json两种Content-Type下的数据提交方式,并提供了对应的requests.get与requests.post代码实现,帮助开发者解决因参数格式错误导致的数据获取失败问题。
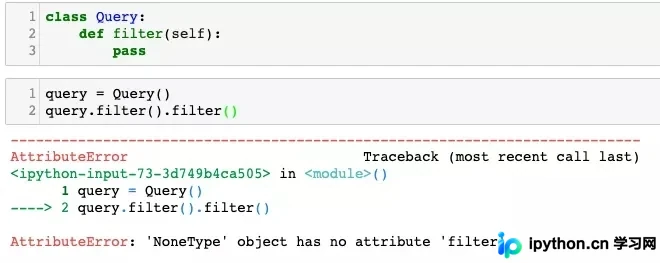
本文解析 Python 中链式调用的实现机制,指出关键在于方法返回实例自身(self)。通过修改 filter 方法返回 self,可消除 None 报错。进一步结合 **kwargs 缓存查询条件,模拟 Django 的惰性查询模式,仅在最终获取结果时执行数据库操作,提升效率。
本文介绍如何在Python中判断一个五位数是否为回文数。通过三种不同思路实现:利用整除和求模进行算术运算、通过字符串索引对比字符、以及使用切片逆序比较。文章详细解析了每种方法的逻辑与代码实现,帮助开发者理解不同数据结构在解决此类问题时的应用。
本文介绍了在Python中计算任意数任意次方根的方法。通过幂运算操作符**实现简单开方,如8的3次方根为8**(1/3)。此外,还提供了一个基于牛顿迭代法的Evolution函数,用于高精度计算任意数的任意次方根,包含用户输入、预估值设定及循环收敛逻辑,适合需要自定义算法场景的开发者参考。