

Python实现文本文件按固定行数拆分并写入多个文件的方法

本文介绍如何使用Python将单个大型文本文件按固定行数拆分为多个小文件。通过读取源文件内容,设定每批处理的行数(如5000行),利用列表切片进行分批处理,并将结果写入指定的目录中。该方法适用于解决因文件过大导致软件导入失败的问题,例如批量处理URL列表供下载工具使用。
引言
本文旨在演示如何将一个包含大量行的TXT文本文件,按照固定的行数进行拆分,并自动分批写入到多个新的文本文件中。例如,若源文件包含5100行数据,设定每1000行生成一个新文件,则最终会生成6个文本文件:前5个文件各包含1000行数据,最后一个文件包含剩余的100行数据。
步骤
1、首先创建一个用于存放分割后TXT文件的目录(此处示例目录名为:dataText)。 2、调整代码中定义的拆分行数(示例中设定为每5000行数据存入一个TXT文件)。 3、运行Python脚本,检查生成的TXT文件是否符合预期。
代码
open_diff = open('data.txt', 'r') # 源文本文件
diff_line = open_diff.readlines()

line_list = []
for line in diff_line:
    line_list.append(line)

count = len(line_list) # 文件行数
print('源文件数据行数:',count)
# 切分diff
diff_match_split = [line_list[i:i+5000] for i in range(0,len(line_list),5000)]# 每个文件的数据行数

# 将切分的写入多个txt中
for i,j in zip(range(0,int(count/5000+1)),range(0,int(count/5000+1))): # 写入txt,计算需要写入的文件数
    with open('./dataText/ImageData%d.txt'% j,'w+') as temp:
        for line in diff_match_split[i]:
            temp.write(line)
print('拆分后文件的个数:',i+1)
结果
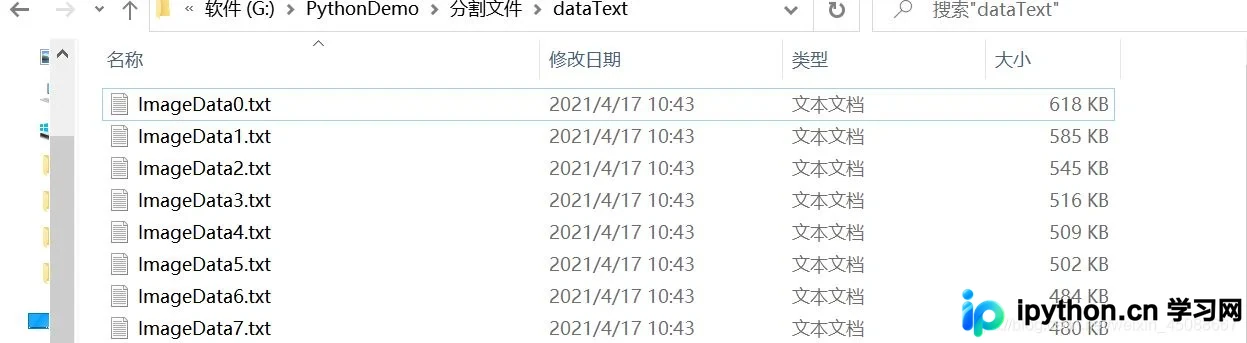
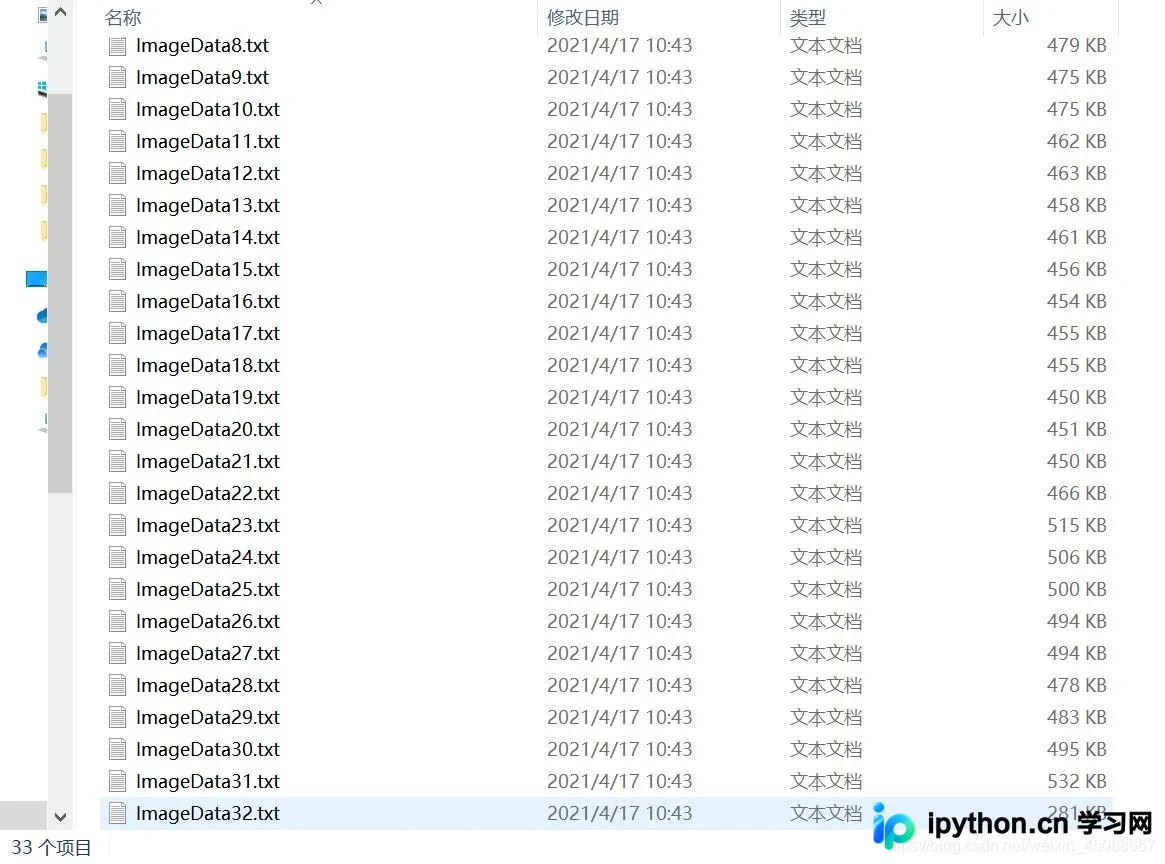
应用:
将TXT文件中的数据拆分成多个文本文件,可以有效解决因单个文本文件数据量过大而无法导入某些软件的问题。
例如,将一个约15M的URL文本文件导入IDM(Internet Download Manager)下载其中的链接内容时,由于源文件过大且数据量过多,直接导入可能失败。此时,将源文件拆分成多个小文本文件并分批次导入IDM,即可顺利完成下载任务。
注意: 1、代码中的5000代表写入每个新文件的数据行数。即使最后一个文件的行数不足5000,也会单独生成一个文本文件进行存储。 2、根据实际需求修改存储数据的行数,请注意代码中涉及拆分逻辑的两个地方(切片步长和文件计数计算)均需同步修改为相同的数值。
到此这篇关于Python实现文本文件拆分写入到多个文本文件的方法的文章就介绍到这了,更多相关Python 文本文件拆分内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









