

Python截取指定字符前所有内容的两种实现方式
本文介绍在Python中提取指定字符之前所有内容的两种常用方法。第一种利用rfind函数定位最后一个分隔符并截取子串;第二种通过字符串逆序、split分割后再逆序还原的方式实现。两种方案均能准确获取目标字符前的完整路径或字符串部分,适用于JSON数据清洗及网络请求处理等场景。
2026-10-13
21

本文介绍在Python中提取指定字符之前所有内容的两种常用方法。第一种利用rfind函数定位最后一个分隔符并截取子串;第二种通过字符串逆序、split分割后再逆序还原的方式实现。两种方案均能准确获取目标字符前的完整路径或字符串部分,适用于JSON数据清洗及网络请求处理等场景。
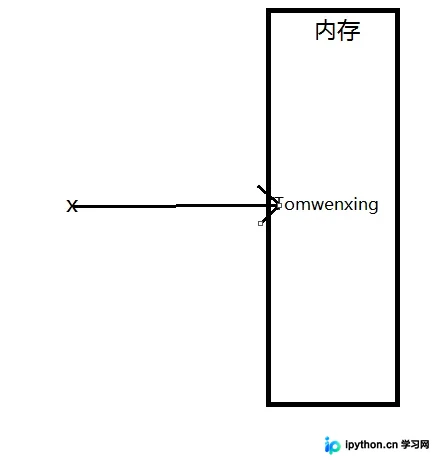
本文深入解析Python装饰器的核心原理,阐述其作为函数本质及不修改源码和调用方式的两大原则。通过解析变量与函数的内存存储机制,结合高阶函数与嵌套函数的知识,详细演示了基础装饰器、带参装饰器的实现逻辑及代码运行流程,帮助开发者掌握装饰器的实际应用。
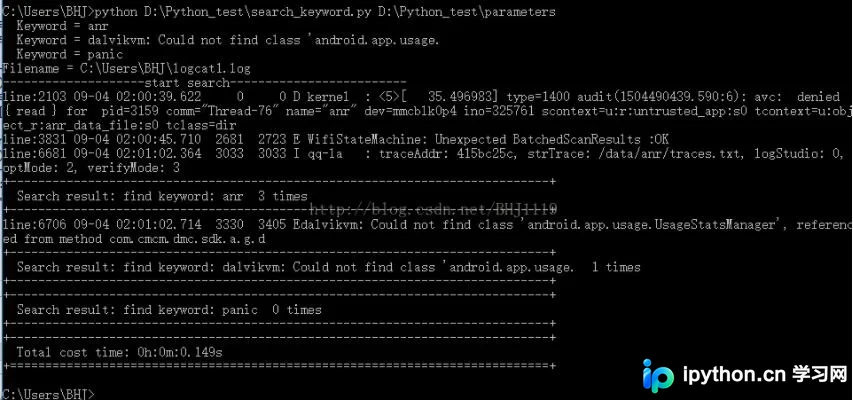
本文介绍如何利用Python脚本在压力测试产生的大量日志中快速定位关键信息。通过读取包含关键字和日志路径的配置文件,程序自动遍历指定文件进行正则匹配,并统计匹配次数与耗时。示例基于Windows 10及Python 2.7.14环境,提供了完整的参数解析、文件检查及时间格式化代码,适用于需要高效日志分析的运维场景。
本文详细介绍 TensorFlow 1.0 中池化层(pooling)与全连接层(dense)的核心用法。涵盖 max_pooling2d 与 average_pooling2d 的参数配置,如 pool_size、strides、padding 及 data_format。同时解析 dense 层的 units、activation、正则化及初始化器等关键参数,提供代码示例与最佳实践,帮助开发者构建高效的卷积神经网络。
本文介绍Python第三方库retrying的使用,通过retry装饰器实现函数失败时的自动重试。重点解析如何配置最大重试次数及自定义异常判断,并指出在已包含try-except的代码中混用可能导致重试失效的问题,提供优化建议。
本文介绍如何使用Python3结合urllib库实现百度贴吧指定页面的数据爬取。通过解析URL中pn参数的分页规律,编写脚本批量获取HTML源码,并将结果保存为本地文本文件。教程包含完整的代码示例、URL规则分析及控制台运行效果,适合Python初学者进行网络爬虫入门实践。
本文通过三个经典案例详解Python中的贪心算法应用。首先解决硬币找零问题,通过优先使用大面值硬币实现数量最小化;其次探讨最大子数组和问题,利用动态更新策略寻找连续子数组的最大和;最后分析汽车加油站问题,通过贪心策略计算最少加油次数。每个案例均提供完整Python代码实现及逻辑解析,适合算法初学者参考学习。
本文详细解析 Python 中实现选择排序算法的具体步骤。通过遍历数组找出最小元素并与当前位置交换,逐步完成排序。文章包含 6 个元素的排序过程演示及完整 Python 代码示例,帮助读者理解选择排序逻辑。
本文介绍在pandas中利用groupby结合head()方法获取分组后每组前几行记录的实用技巧。通过先按指定列排序,再执行groupby().head(n),可高效提取各组Top N数据,适用于排行榜、抽样等场景。
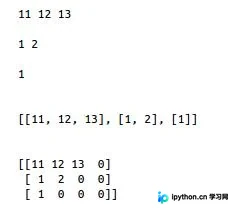
本文介绍利用Python的raw_input()函数读取多行不定长数据的方法。通过循环接收输入,以空格分割并转换为整数列表,最终构建二维矩阵。针对不等长子序列,使用指定值进行填充,生成标准的二维数组结构,适用于需要处理非结构化输入的场景。
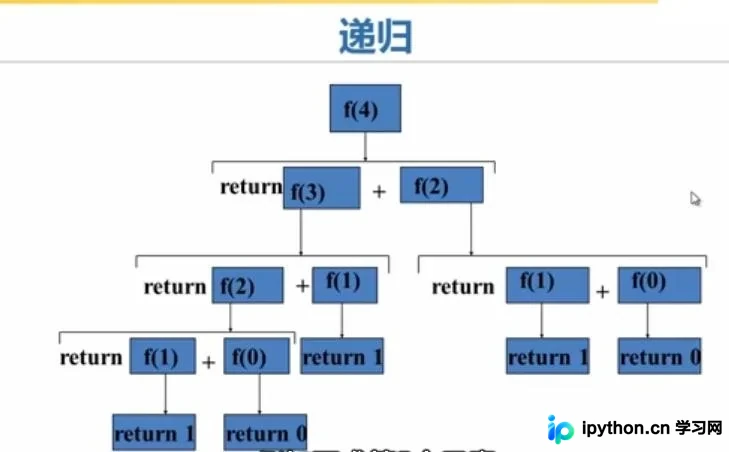
本文通过Fibonacci数列和汉诺塔两个经典案例,深入解析Python中递归算法的实现与应用。对比了while循环与递归在代码简洁性及执行效率上的差异,指出递归虽资源消耗较大,但在解决如汉诺塔等缺乏明显循环方案的问题时具有独特优势,适合Python初学者理解计算思维。
本文详细解析Python中列表(list)、元组(tuple)与Numpy数组(array)的区别。List可变且存储指针,Tuple不可变且安全,Array要求同类型数据以提升性能。通过对比内存占用、操作限制及二维处理,帮助开发者根据场景选择合适的数据结构。